Ingénierie de l’apprentissage automatique
CSI 4506 - automne 2026
Version: oct. 13, 2026 11h53
Préambule
Message du jour

Objectifs d’apprentissage
- Choisir un encodage qui respecte la signification d’un attribut et les besoins de l’estimateur.
- Expliquer quand la mise à l’échelle importe et l’appliquer sans fuite d’information provenant des données de validation ou de test.
- Comparer les stratégies de traitement des valeurs manquantes et effectuer l’imputation dans un pipeline.
- Appliquer les remèdes au déséquilibre des classes aux données d’entraînement sans modifier la distribution d’évaluation.
- Construire des attributs non linéaires et des interactions tout en contrôlant la complexité du modèle.
- Expliquer comment la qualité, la couverture et l’augmentation des données influencent la généralisation.
Ingénierie de l’apprentissage automatique
Ingénierie de l’apprentissage automatique
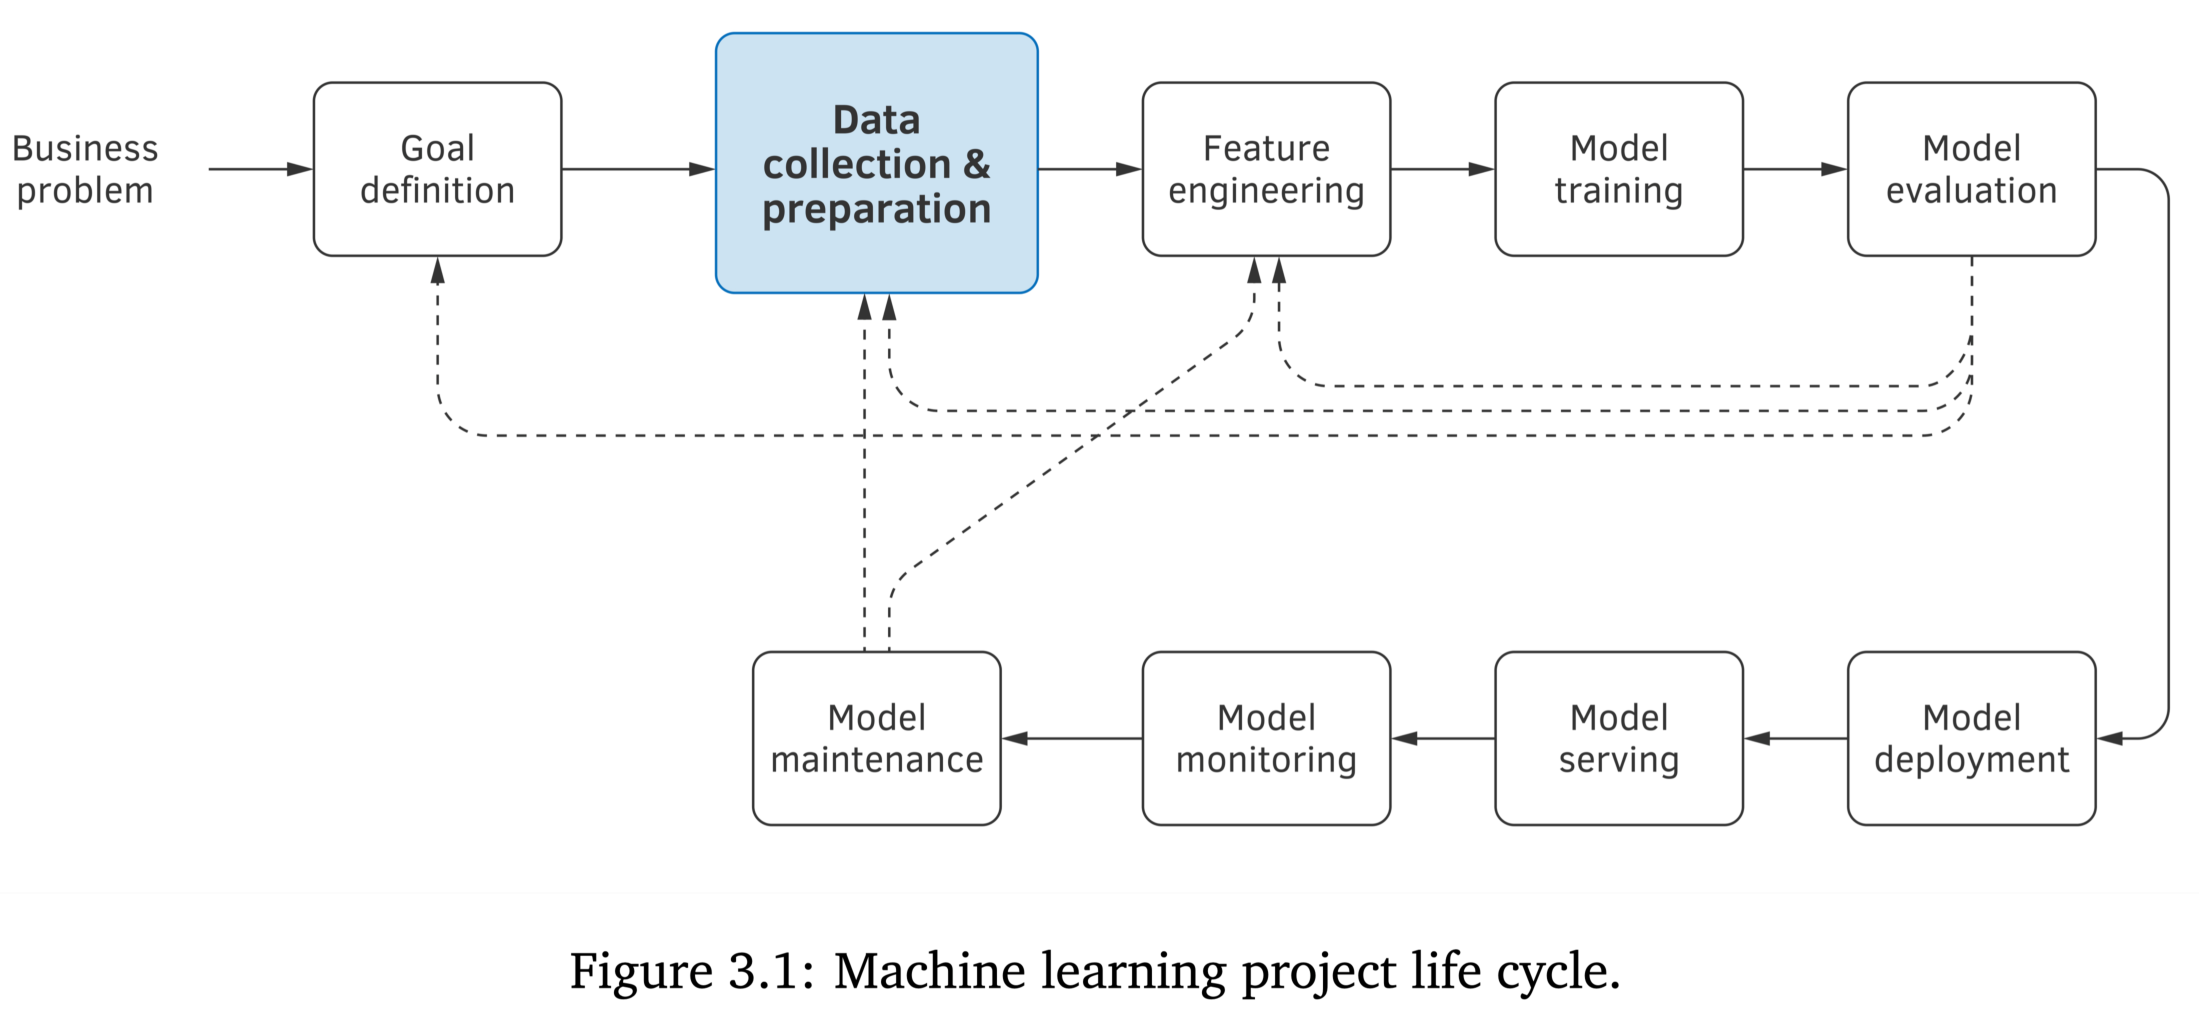
Encodage
Pourquoi?
Après avoir terminé le devoir 1, vous avez produit un fichier .csv contenant des données nettoyées.
Pourquoi d’autres étapes seraient-elles nécessaires?
Jeu de données Adult
Jeu de données Adult
Author: Ronny Kohavi and Barry Becker
Source: UCI - 1996
Please cite: Ron Kohavi, “Scaling Up the Accuracy of Naive-Bayes Classifiers: a Decision-Tree Hybrid”, Proceedings of the Second International Conference on Knowledge Discovery and Data Mining, 1996
Prediction task is to determine whether a person makes over 50K a year. Extraction was done by Barry Becker from the 1994 Census database. A set of reasonably clean records was extracted using the following conditions: ((AAGE>16) && (AGI>100) && (AFNLWGT>1)&& (HRSWK>0))
This is the original version from the UCI repository, with training and test sets merged.
Variable description
Variables are all self-explanatory except fnlwgt. This is a proxy for the demographic background of the people: “People with similar demographic characteristics should have similar weights”. This similarity-statement is not transferable across the 51 different states.
Description from the donor of the database:
The weights on the CPS files are controlled to independent estimates of the civilian noninstitutional population of the US. These are prepared monthly for us by Population Division here at the Census Bureau. We use 3 sets of controls. These are: 1. A single cell estimate of the population 16+ for each state. 2. Controls for Hispanic Origin by age and sex. 3. Controls by Race, age and sex.
We use all three sets of controls in our weighting program and “rake” through them 6 times so that by the end we come back to all the controls we used. The term estimate refers to population totals derived from CPS by creating “weighted tallies” of any specified socio-economic characteristics of the population. People with similar demographic characteristics should have similar weights. There is one important caveat to remember about this statement. That is that since the CPS sample is actually a collection of 51 state samples, each with its own probability of selection, the statement only applies within state.
Relevant papers
Ronny Kohavi and Barry Becker. Data Mining and Visualization, Silicon Graphics.
e-mail: ronnyk ‘@’ live.com for questions.
Downloaded from openml.org.
Adult - Workclass
Adult - Education
Adult - Marital Status
['Never-married', 'Married-civ-spouse', 'Widowed', 'Divorced', 'Separated', 'Married-spouse-absent', 'Married-AF-spouse']
Categories (7, str): ['Divorced', 'Married-AF-spouse', 'Married-civ-spouse', 'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed']
Données catégorielles
Principes de représentation des données
Représentation numérique : de nombreux algorithmes d’apprentissage exigent des vecteurs d’attributs numériques.
La signification compte : la représentation doit respecter le caractère non ordonné ou ordonné des catégories.
Méthodes d’encodage
Considérons l’attribut workclass, qui possède huit valeurs distinctes, telles que ‘Federal-gov’ et ‘Local-gov’.
- Quelle méthode d’encodage faut-il privilégier et pourquoi?
w= 1, 2, 3, 4, 5, 6, 7 ou 8w= [0,0,0], [0,0,1], [0,1,0], \ldots ou [1,1,1]w= [1,0,0,0,0,0,0,0], [0,1,0,0,0,0,0,0], \ldots ou [0,0,0,0,0,0,0,1]
Encodage des données nominales
L’encodage one-hot (one-hot encoding) constitue un choix courant pour les catégories non ordonnées, ou nominales.
- Augmentation de la dimension : l’encodage one-hot crée un attribut de sortie pour chaque catégorie conservée.
- Absence d’ordre artificiel : les codes entiers peuvent introduire des distances et un ordre que les catégories ne possèdent pas.
- Exemple de biais : la première méthode,
w= 1, 2, 3, etc., laisse croire que ‘Federal-gov’ et ‘Local-gov’ sont semblables, tandis que ‘Federal-gov’ et ‘Without-pay’ ne le sont pas. - Similarité trompeuse : la deuxième méthode,
w= [0,0,0], [0,0,1], etc., peut induire l’algorithme en erreur en suggérant une similarité fondée sur des motifs numériques.
Définition
L’encodage one-hot transforme une variable catégorielle en vecteur binaire. Chaque catégorie est représentée par un vecteur qui contient un seul « 1 » et des « 0 » partout ailleurs.
OneHotEncoder
array([[0., 0., 0., 1., 0., 0., 0., 0., 0.],
       [0., 0., 0., 1., 0., 0., 0., 0., 0.],
       [0., 1., 0., 0., 0., 0., 0., 0., 0.],
       [0., 0., 0., 1., 0., 0., 0., 0., 0.],
[0., 0., 0., 0., 0., 0., 0., 0., 1.]])Étude de cas
- Jeu de données : Heart Disease
- Exemples : 303, attributs : 13
- Cible : 0 indique l’absence de maladie; les valeurs 1 à 4 indiquent sa présence
- Données catégorielles :
- sex : 1 = homme, 0 = femme
- cp (type de douleur thoracique) :
- 1 : angine typique
- 2 : angine atypique
- 3 : douleur non angineuse
- 4 : asymptomatique
- Autres : ‘fbs’, ‘restecg’, ‘exang’, ‘slope’, ‘thal’
Étude de cas
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import fetch_openml
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.compose import ColumnTransformer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report
from sklearn.pipeline import Pipeline

# Charger le jeu de données 'Heart-Disease' depuis OpenML
data = fetch_openml(name='Heart-Disease', version=1, as_frame=True)
df = data.frame

# Remplacer '?' par NaN et convertir les colonnes en valeurs numériques
for col in df.columns:
    df[col] = pd.to_numeric(df[col], errors='coerce')

# Supprimer les lignes qui contiennent des valeurs manquantes
df.dropna(inplace=True)

# Définir les attributs et convertir la cible en absence ou présence
X = df.drop(columns=['target'])
y = (df['target'] > 0).astype(int)

# Colonnes à encoder avec OneHotEncoder
columns_to_encode = ['sex', 'cp', 'fbs', 'restecg', 'exang', 'slope', 'thal']

# Repérer les colonnes numériques
numerical_columns = X.columns.difference(columns_to_encode)

# Diviser les données avant d'appliquer les transformations
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Appliquer OneHotEncoder et StandardScaler avec ColumnTransformer
preprocessor = ColumnTransformer(
    transformers=[
        (
            'onehot',
            OneHotEncoder(drop='first', handle_unknown='ignore'),
            columns_to_encode,
        ),
        ('scaler', StandardScaler(), numerical_columns)
    ]
)

# Le pipeline ajuste le prétraitement et le classificateur sur l'entraînement
heart_pipeline = Pipeline([
    ('preprocessor', preprocessor),
    ('classifier', LogisticRegression()),
])
heart_pipeline.fit(X_train, y_train)Étude de cas - résultats
Étude de cas - douleur thoracique (cp)
# Récupérer les noms des attributs et les coefficients du pipeline ajusté
feature_names = heart_pipeline[
    'preprocessor'
].get_feature_names_out()

coefficients = heart_pipeline['classifier'].coef_[0]

# Créer un DataFrame qui associe les attributs et les coefficients
coef_df = pd.DataFrame({
    'Attribut': feature_names,
    'Coefficient': coefficients
})

# Afficher les coefficients associés à 'cp'
cp_features = coef_df[coef_df['Attribut'].str.contains('_cp')]
print("\nCoefficients associés à 'cp' :")
print(cp_features)
Coefficients associés à 'cp' :
         Attribut  Coefficient
1  onehot__cp_1.0     0.754906
2  onehot__cp_2.0     1.440017
3  onehot__cp_3.0     1.255102
Étude de cas - coefficients
Code
# Visualiser les coefficients ajustés

coef_plot_df = coef_df.sort_values(by='Coefficient')
plt.figure(figsize=(8, 6))
plt.barh(coef_plot_df['Attribut'], coef_plot_df['Coefficient'])
plt.title('Coefficients des attributs')
plt.xlabel('Valeur du coefficient')
plt.ylabel('Attribut')
plt.tight_layout()
plt.show()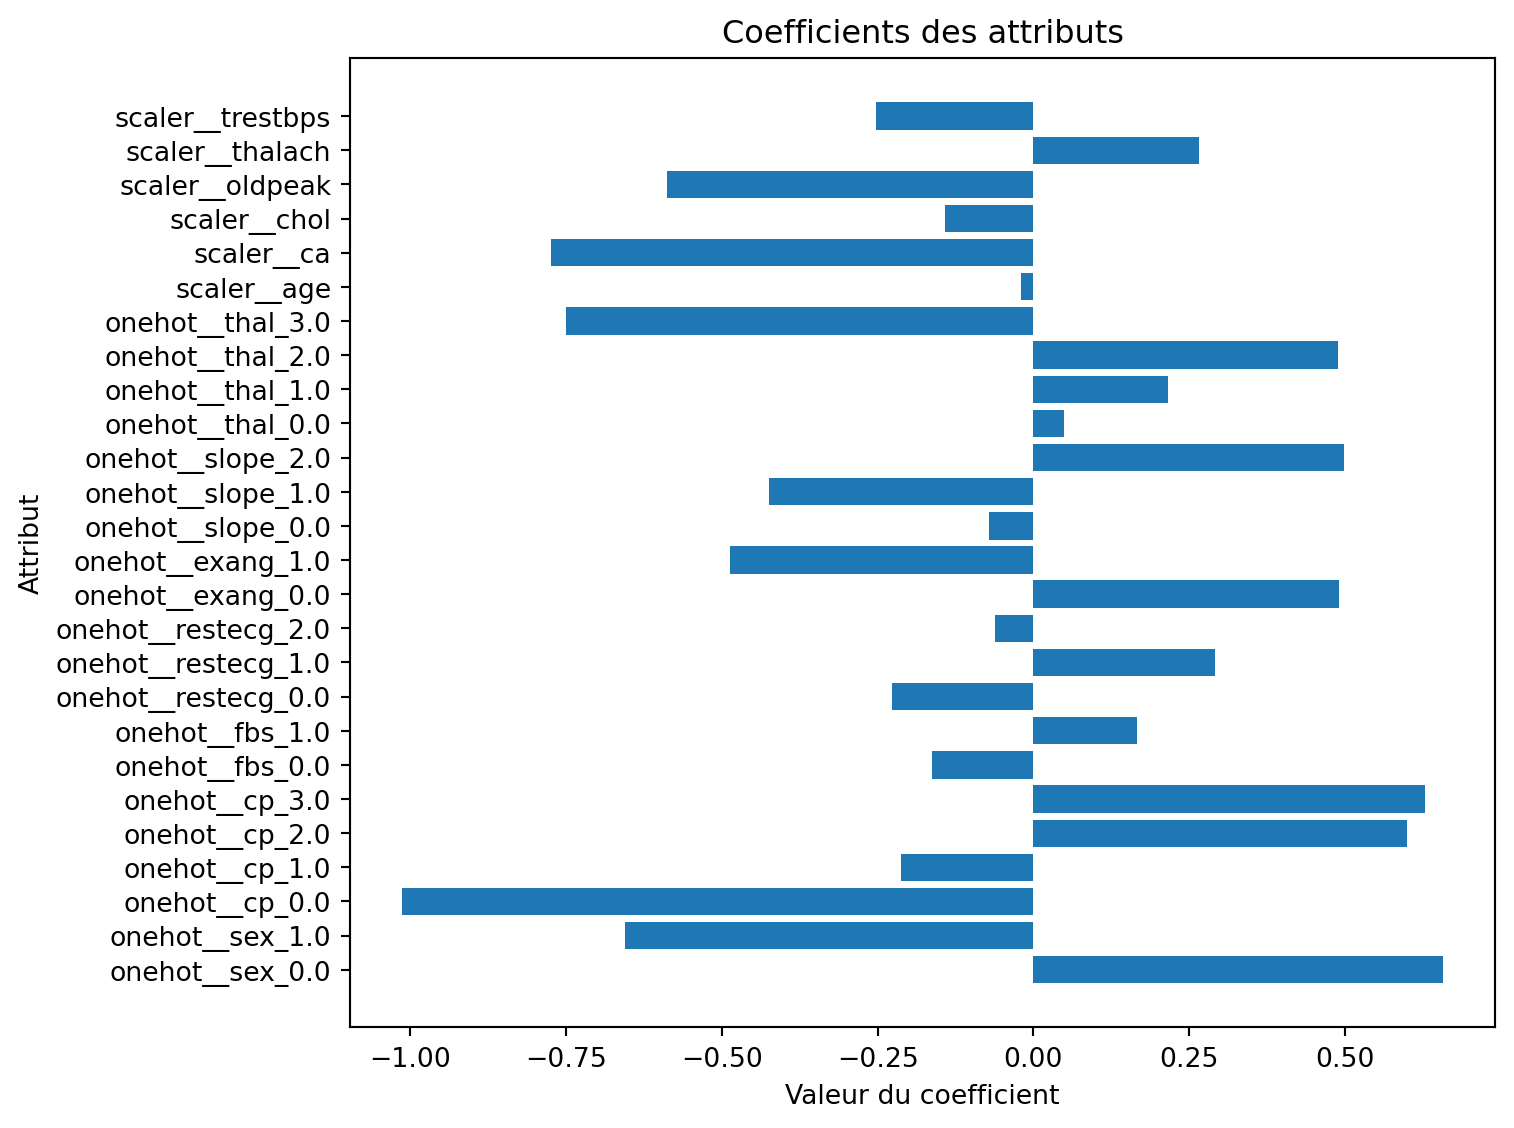
Définition
L’encodage ordinal attribue des valeurs numériques à des catégories selon leur ordre ou leur rang intrinsèque.
Ingénierie des attributs - données ordinales
Pour des valeurs comme « faible », « moyen » et « bon », un encodage ordinal peut préserver l’ordre.
OrdinalEncoder (révisé)
Définition
La discrétisation transforme un attribut numérique continu ou finement gradué en un ensemble fini d’intervalles.
Ingénierie des attributs : discrétisation
Exemple : regrouper les âges en catégories comme « nourrisson », « enfant », « adolescent », « adulte » et « personne âgée ».
Avantage possible :
- encode des seuils pertinents du domaine et peut réduire la complexité du modèle.
Inconvénients :
- élimine les différences à l’intérieur de chaque intervalle et introduit des frontières abruptes;
- exige des seuils justifiables. Par exemple, la catégorie « personne âgée » pourrait commencer à 60, 65 ou 70 ans1.
FunctionTransformer
import pandas as pd
import numpy as np
from sklearn.preprocessing import FunctionTransformer

bins = [0, 1, 13, 20, 60, np.inf]
labels = ['nourrisson', 'enfant', 'adolescent', 'adulte', 'personne âgée']

transformer = FunctionTransformer(
    pd.cut, kw_args={'bins': bins, 'labels': labels, 'retbins': False}
)

X = np.array([0.5, 2, 15, 25, 97])
transformer.fit_transform(X)
['nourrisson', 'enfant', 'adolescent', 'adulte', 'personne âgée']
Categories (5, str): ['nourrisson' < 'enfant' < 'adolescent' < 'adulte' < 'personne âgée']Mise à l’échelle
Qu’est-ce que c’est?
La mise à l’échelle des attributs (feature scaling) place leurs valeurs dans des plages comparables.
Pourquoi?
Pourquoi certains estimateurs exigent-ils des attributs d’échelles comparables?
Scénario
Nous voulons prédire le prix d’une maison par régression des k plus proches voisins (KNN) à partir de deux attributs :
- x_1 : nombre de pièces (petite échelle)
- x_2 : superficie en pieds carrés (grande échelle)
Données (trois maisons)
import numpy as np
import pandas as pd

# Trois exemples (pièces, pieds carrés); prix pour b et c seulement
point_names = ["a", "b", "c"]
X = np.array([
    [4, 1500.0],  # a (requête)
    [8, 1520.0],  # b (entraînement)
    [4, 1300.0],  # c (entraînement)
], dtype=float)

prices = pd.Series([np.nan, 520_000, 390_000], index=point_names, name="prix")

df = pd.DataFrame(X, columns=["pièces", "pieds_carrés"], index=point_names)
display(df)
display(prices.to_frame())
Remarque. Les exemples b et c forment l’ensemble d’entraînement. L’exemple a constitue la requête dont nous voulons prédire le prix.
Données (trois maisons)
| pièces | pieds_carrés | |
|---|---|---|
| a | 4.0 | 1500.0 |
| b | 8.0 | 1520.0 |
| c | 4.0 | 1300.0 |
| prix | |
|---|---|
| a | NaN |
| b | 520000.0 |
| c | 390000.0 |
Distances euclidiennes (sans mise à l’échelle)
Lorsqu’un attribut possède une échelle beaucoup plus grande, comme la superficie, il peut dominer la somme.
Distances euclidiennes (sans mise à l’échelle)
| a | b | c | |
|---|---|---|---|
| a | 0.000000 | 20.396078 | 200.000000 |
| b | 20.396078 | 0.000000 | 220.036361 |
| c | 200.000000 | 220.036361 | 0.000000 |
Mise à l’échelle appropriée
Pour éviter toute fuite de données, calculons les paramètres de mise à l’échelle à partir des seules données d’entraînement (b et c), puis transformons les données d’entraînement et la requête :
Mise à l’échelle appropriée
| pièces | pieds_carrés | |
|---|---|---|
| a | -1.0 | 0.818182 |
| b | 1.0 | 1.000000 |
| c | -1.0 | -1.000000 |
Distances euclidiennes (après mise à l’échelle)
| a | b | c | |
|---|---|---|---|
| a | 0.000000 | 2.008247 | 1.818182 |
| b | 2.008247 | 0.000000 | 2.828427 |
| c | 1.818182 | 2.828427 | 0.000000 |
Régression KNN
Un régresseur 1-NN prédit le prix de l’exemple d’entraînement le plus proche. Comparons le même estimateur avec et sans mise à l’échelle.
from sklearn.neighbors import KNeighborsRegressor

X_train = df.loc[train_idx].values
y_train = prices.loc[train_idx].values
X_query = df.loc[query_idx].values

knn_plain = KNeighborsRegressor(n_neighbors=1, metric="euclidean")
knn_plain.fit(X_train, y_train)

knn_scaled = Pipeline([
    ("scaler", StandardScaler()),
    ("knn", KNeighborsRegressor(n_neighbors=1, metric="euclidean"))
])

knn_scaled.fit(X_train, y_train)Régression KNN : résultats
Code
pred_plain = knn_plain.predict(X_query)[0]
pred_scaled = knn_scaled.predict(X_query)[0]

plain_index = knn_plain.kneighbors(
    X_query, return_distance=False
)[0, 0]
scaled_query = knn_scaled["scaler"].transform(X_query)
scaled_index = knn_scaled["knn"].kneighbors(
    scaled_query, return_distance=False
)[0, 0]

knn_comparison = pd.DataFrame(
    {
        "prédiction": [pred_plain, pred_scaled],
        "plus proche voisin": [
            train_idx[plain_index], train_idx[scaled_index]
        ],
    },
    index=["sans mise à l'échelle", "avec mise à l'échelle"],
)| Prédiction | Plus proche voisin | |
|---|---|---|
| Sans mise à l’échelle | 520 000 $ | b |
| Avec mise à l’échelle | 390 000 $ | c |
Mise à l’échelle min-max
La mise à l’échelle min-max transforme chaque attribut dans un intervalle choisi, habituellement [0,1].
\frac{x_i^{(j)} - \min^{(j)}}{\max^{(j)} - \min^{(j)}}
Le minimum et le maximum doivent être appris à partir des données d’entraînement.
Standardisation
La standardisation soustrait la moyenne d’entraînement et divise par l’écart-type d’entraînement.
\frac{x_i^{(j)} - \mu^{(j)}}{\sigma^{(j)}}
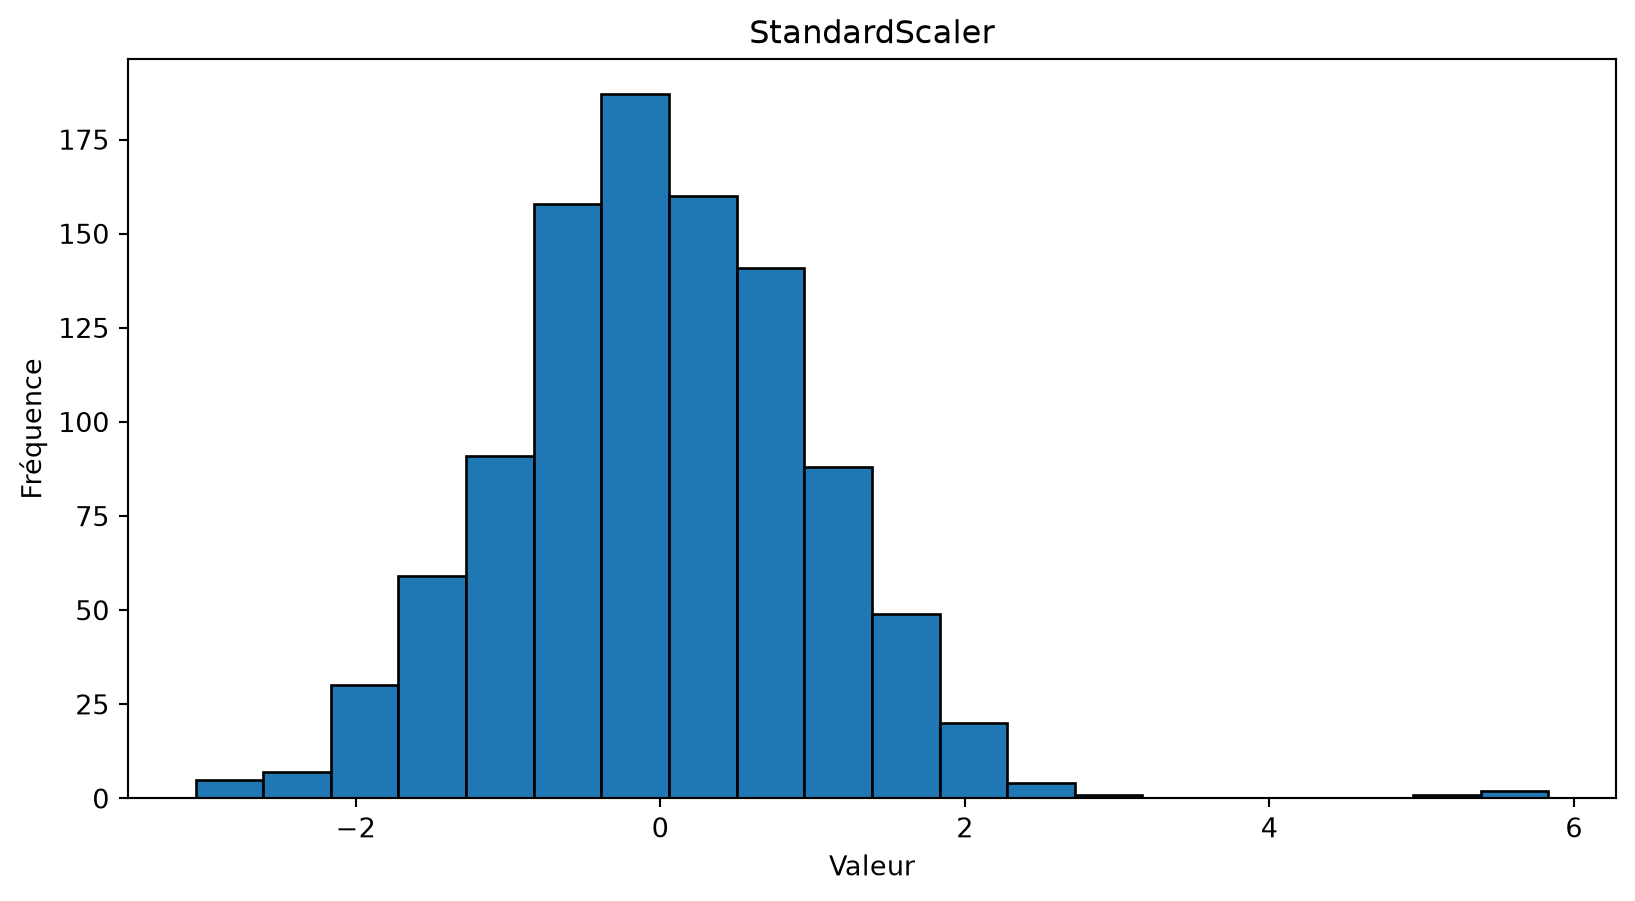
L’attribut d’entraînement transformé possède une moyenne de 0 et une variance de 1, mais sa distribution ne devient pas normale et son étendue n’est pas bornée.
Choisir une méthode de mise à l’échelle
- La standardisation constitue un choix courant pour les méthodes fondées sur les distances, les modèles linéaires régularisés et l’optimisation par gradient.
- La mise à l’échelle min-max convient lorsqu’une plage d’entrée bornée est exigée.
- Les deux méthodes sont sensibles aux valeurs aberrantes : la mise à l’échelle min-max utilise les extrêmes, tandis que la standardisation utilise la moyenne et l’écart-type.
- Pour les attributs très asymétriques ou qui contiennent des valeurs aberrantes, examinez le processus de production des données et envisagez une transformation justifiée, une règle d’écrêtage ou
RobustScaler. - Lorsque plusieurs choix sont plausibles et importants, comparez-les au moyen de la validation croisée.
Comparaison des méthodes
| Propriété | Standardisation | Mise à l’échelle min-max |
|---|---|---|
| Plage de sortie | Non bornée | Habituellement [0, 1] |
| Centre | Moyenne à 0 | Non centrée |
| Sensibilité aux valeurs aberrantes | Par la moyenne et l’écart-type | Par le minimum et le maximum |
| Usage typique | Variances comparables et attributs centrés à zéro | Plage bornée prescrite |
Éviter les fuites de données!
Le flux de travail correct :
- diviser les exemples avant d’apprendre tout paramètre de prétraitement;
- ajuster l’outil de mise à l’échelle sur les données d’entraînement;
- réutiliser cet outil ajusté pour transformer les données de validation, de test et de production;
- pendant la validation croisée, ajuster le prétraitement séparément dans chaque pli d’entraînement, normalement à l’aide d’un
Pipeline.
Échantillon normal avec valeurs aberrantes
Distribution originale
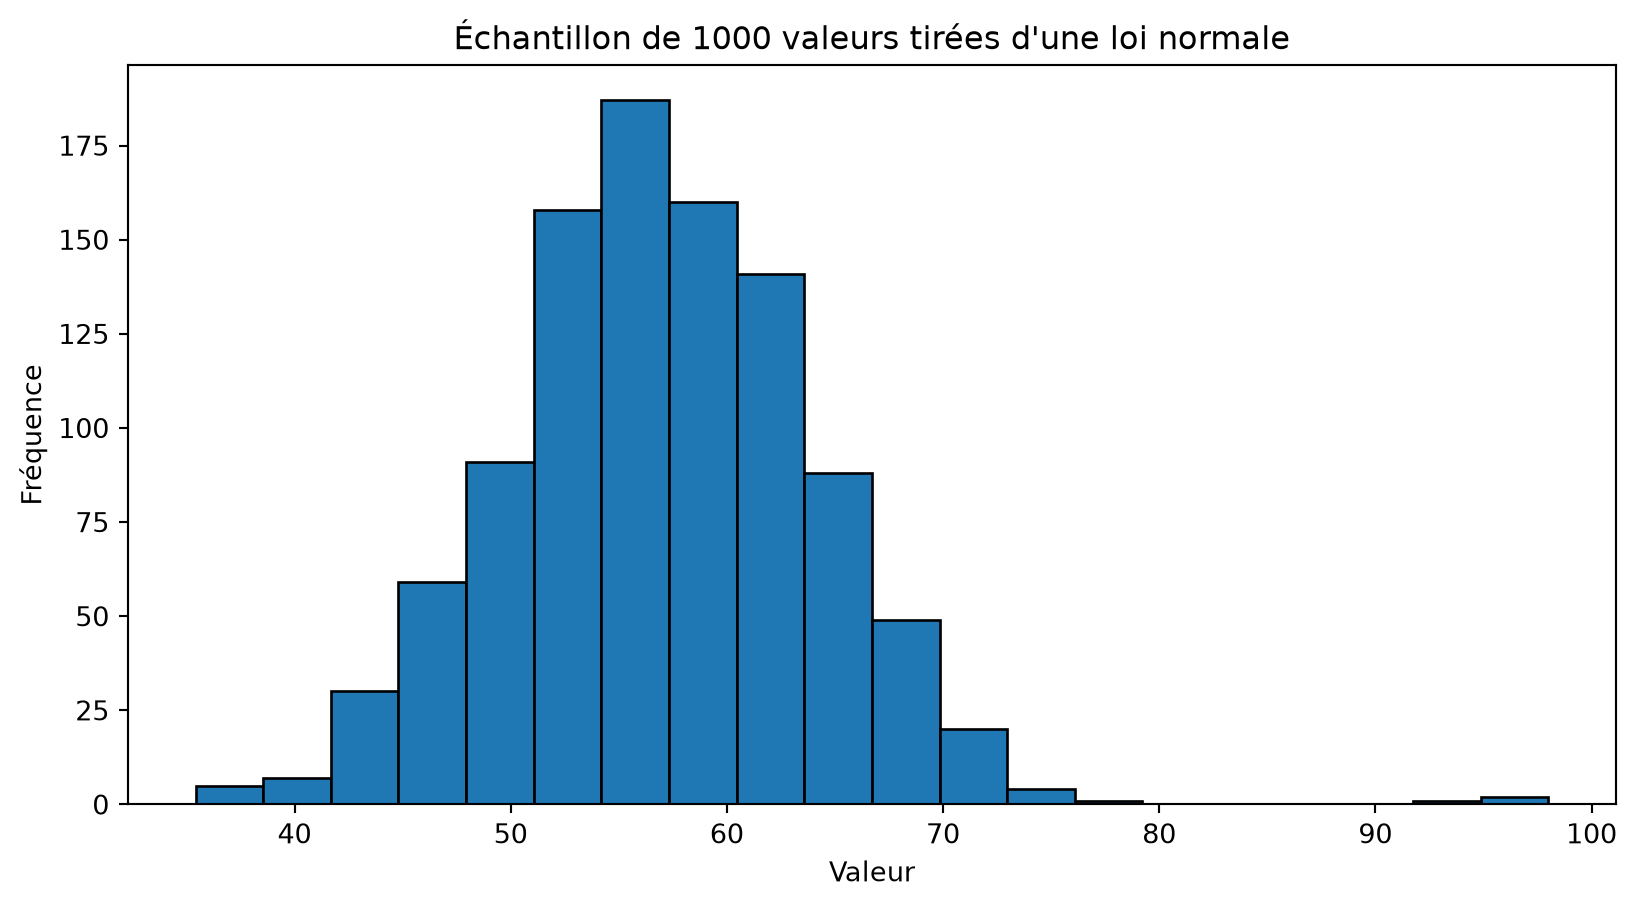
Mise à l’échelle min-max
Code
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()

minmax_norm_values = scaler.fit_transform(norm_values.reshape(-1, 1))

# Tracer l'histogramme
plt.hist(minmax_norm_values, bins=20, edgecolor='black')

plt.title('MinMaxScaler')

plt.xlabel('Valeur')
plt.ylabel('Fréquence')

plt.show()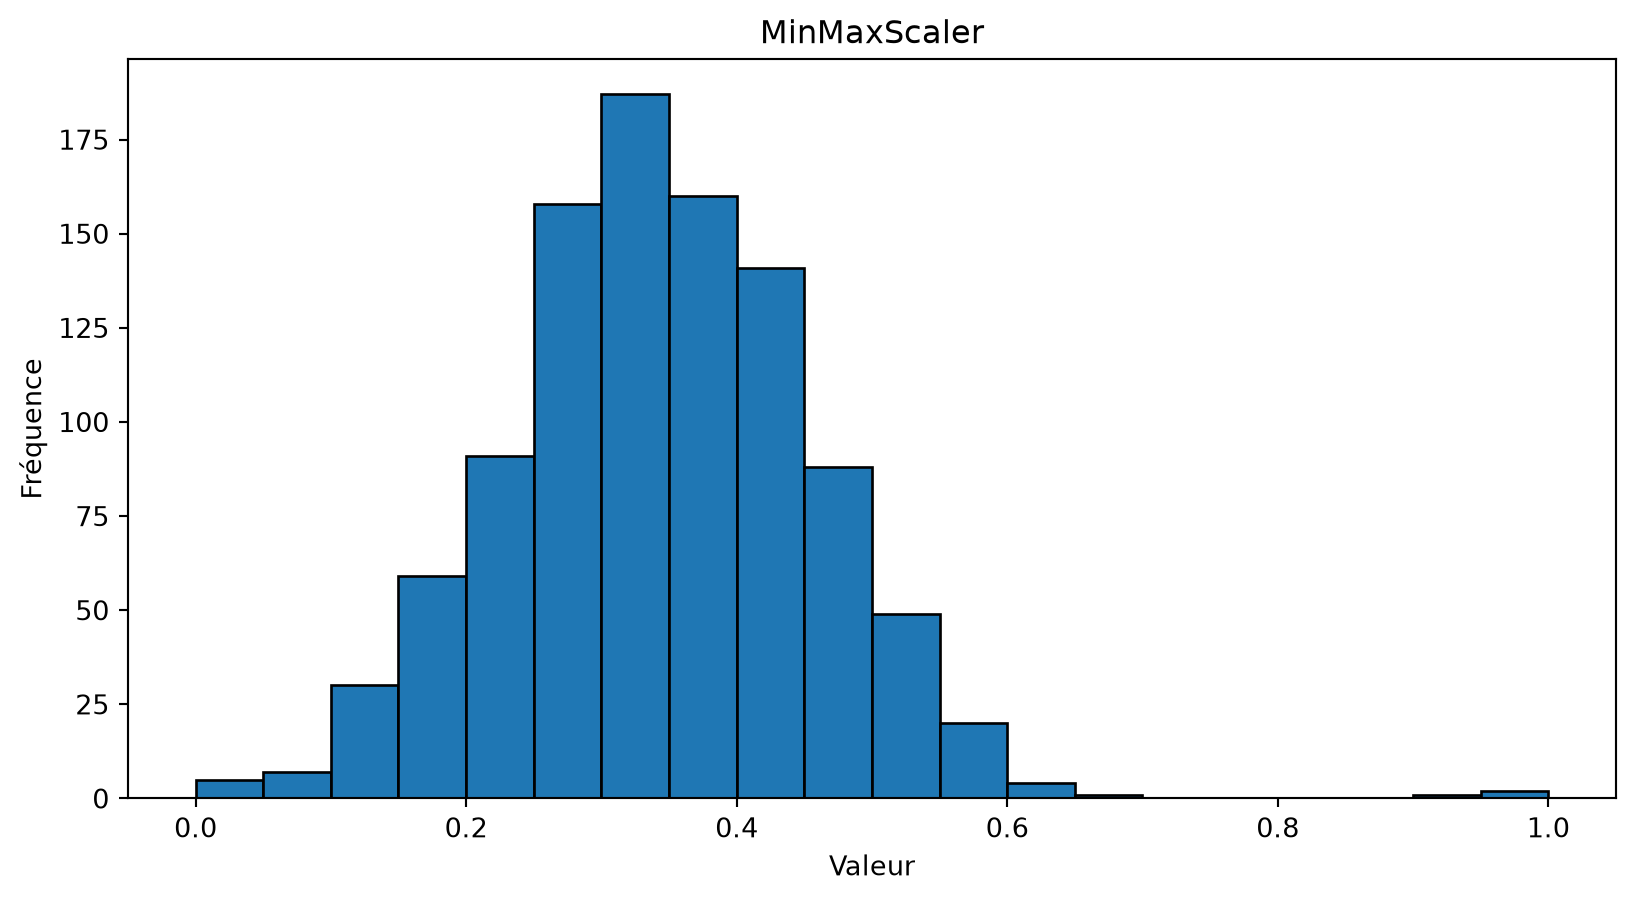
Standardisation
Valeurs manquantes
Définition
Les valeurs manquantes désignent l’absence d’une donnée à un endroit où une valeur est attendue dans un jeu de données.
Traiter les valeurs manquantes
- Supprimer des exemples
- Ce choix est raisonnable seulement s’il reste assez de données et si les lignes incomplètes ne diffèrent pas systématiquement des autres.
- Supprimer des attributs
- Ce choix convient lorsqu’un attribut n’est pas essentiel et qu’il reste trop peu d’information fiable.
- Employer un algorithme qui accepte les valeurs manquantes
- Certains estimateurs les modélisent directement; beaucoup d’autres ne les acceptent pas.
- Effectuer une imputation
- Remplacer les valeurs manquantes à l’aide de statistiques ou d’un modèle appris sur les données d’entraînement.
Définition
L’imputation des données consiste à remplacer les valeurs manquantes par des valeurs de substitution, généralement calculées à l’aide de méthodes statistiques ou d’apprentissage automatique.
Stratégie d’imputation
Remplaçons une valeur numérique manquante par la moyenne ou la médiane d’entraînement de l’attribut.
array([[ 4., 11.]])Limite : l’imputation univariée ignore les relations entre les attributs et réduit la variabilité observée.
Attributs catégoriels : utilisez la catégorie la plus fréquente ou une catégorie explicite
"manquant"lorsque cette représentation convient.
Préserver l’information de valeurs manquantes
Une valeur imputée peut être accompagnée d’un attribut binaire qui indique que la valeur originale était manquante.
Prédire un attribut manquant
- Choisir comme cible de prédiction un attribut qui contient des valeurs manquantes.
- Utiliser comme exemples d’entraînement les lignes où cet attribut est observé.
- Utiliser les autres attributs observés comme entrées.
- Prédire les valeurs manquantes au moyen d’un modèle de régression ou de classification.
Apprentissage automatique et imputation
Méthode fondée sur les voisins :
- employer les k plus proches voisins pour repérer les k exemples les plus semblables et imputer à partir des valeurs non manquantes dans ce voisinage.
Méthodes itératives fondées sur des modèles :
- prédire chaque attribut incomplet à partir des autres, puis répéter le processus pour les différents attributs.
Pourquoi utiliser ces méthodes?
- Avantage possible :
- exploiter les relations entre les attributs que l’imputation univariée ignore.
- Limites :
- l’augmentation du calcul et du nombre de choix de modélisation ne garantit pas de meilleures prédictions;
- l’outil d’imputation doit tout de même être ajusté dans chaque partition d’entraînement ou pli de validation croisée.
Remèdes au déséquilibre des classes
De l’évaluation à l’intervention
La leçon 7 a montré que le déséquilibre des classes peut masquer une mauvaise performance sur une classe peu fréquente et que l’évaluation doit refléter le problème de décision.
Cette leçon pose une question différente :
Comment la procédure d’entraînement peut-elle répondre au déséquilibre des classes sans contaminer l’évaluation?
Remèdes durant l’entraînement
- Poids de classes ou d’exemples : faire contribuer davantage les erreurs commises sur certains exemples à l’objectif d’entraînement.
- Suréchantillonnage aléatoire : répéter des exemples d’entraînement de la classe minoritaire.
- Sous-échantillonnage aléatoire : conserver moins d’exemples d’entraînement de la classe majoritaire.
- SMOTE : interpoler des exemples synthétiques de la classe minoritaire à partir d’exemples d’entraînement voisins.
- Seuil de décision : choisir un point de fonctionnement à l’aide des données de validation, comme à la leçon 7.
Garder l’évaluation intacte
- Préserver la distribution naturelle des classes dans les données de validation et de test.
- Appliquer le rééchantillonnage uniquement à une partition d’entraînement.
- Durant la validation croisée, rééchantillonner séparément dans chaque pli d’entraînement.
- Placer le rééchantillonnage et l’estimateur dans un pipeline d’
imbalanced-learn. - Réserver l’ensemble de test à l’évaluation finale, après avoir choisi le remède et tout seuil de décision.
Nouveaux attributs
Définition
L’ingénierie des attributs (feature engineering) consiste à créer, à transformer et à sélectionner des variables à partir des données brutes afin d’améliorer la performance des modèles d’apprentissage automatique.
Exploration
Code
import numpy as np

np.random.seed(42)

X = 6 * np.random.rand(100, 1) - 3
y = 0.5 * X ** 2 - X + 2 + np.random.randn(100, 1)

import matplotlib as mpl
import matplotlib.pyplot as plt

plt.figure(figsize=(6,4))

plt.plot(X, y, "b.")
plt.xlabel("$x$", fontsize=18)
plt.ylabel("$y$", rotation=0, fontsize=18)
plt.axis([-3, 3, 0, 10])
plt.grid(True)
plt.show()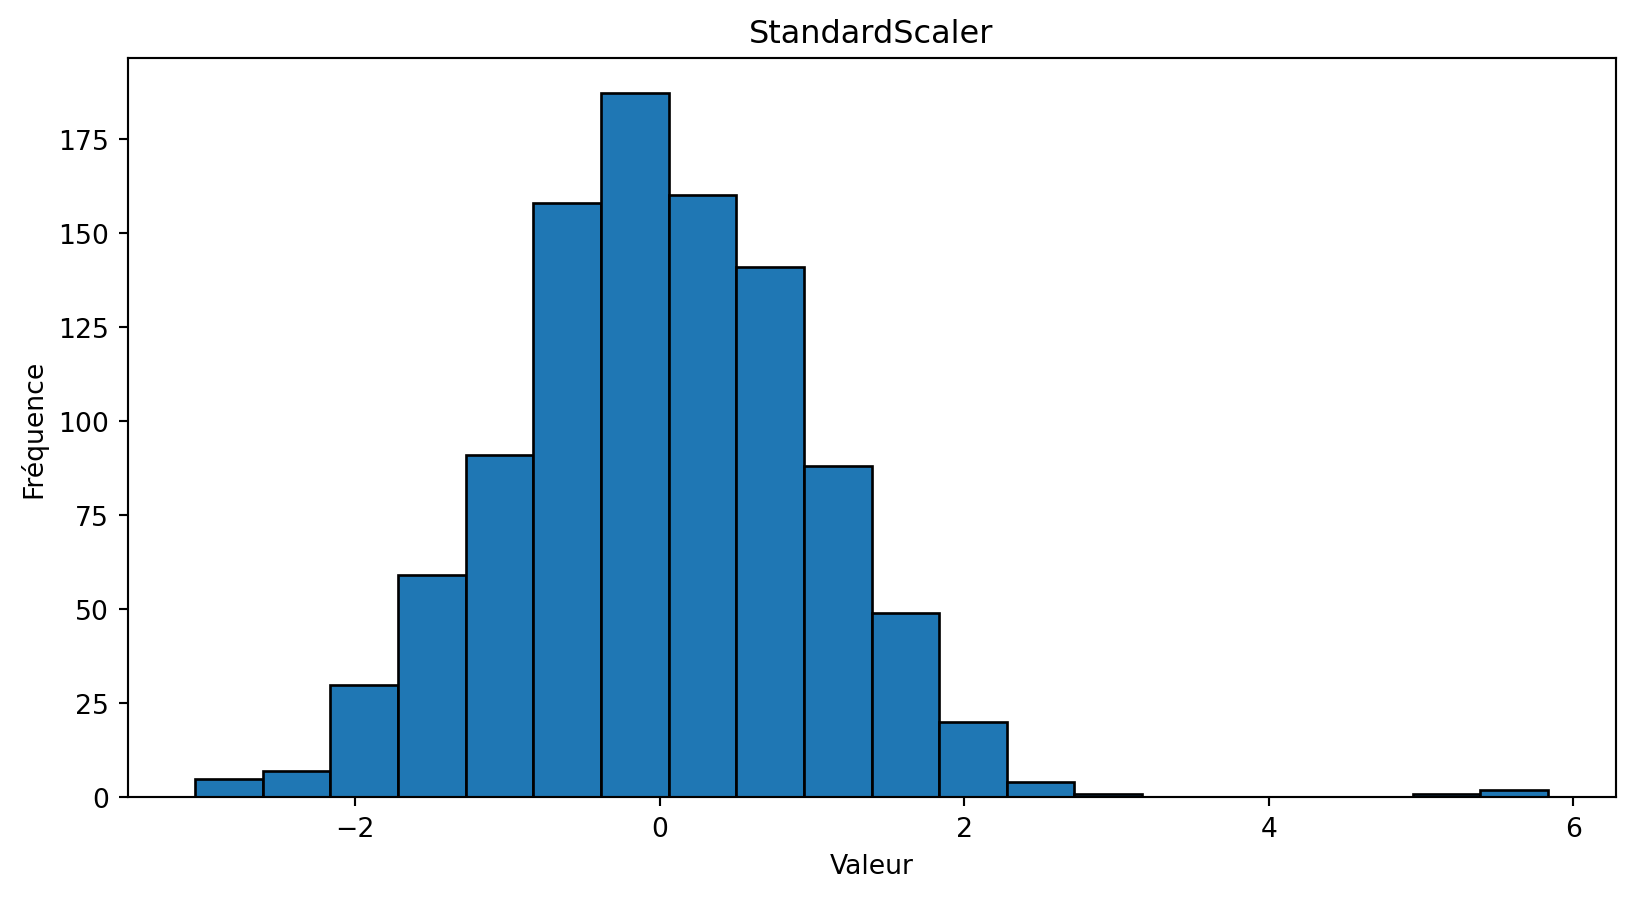
Régression linéaire
Code
from sklearn.linear_model import LinearRegression

lin_reg = LinearRegression()
lin_reg.fit(X, y)

X_new = np.array([[-3], [3]])
y_pred = lin_reg.predict(X_new)

plt.figure(figsize=(6,4))

plt.plot(X, y, "b.")
plt.plot(X_new, y_pred, "r-")
plt.xlabel("$x$", fontsize=18)
plt.ylabel("$y$", rotation=0, fontsize=18)
plt.axis([-3, 3, 0, 10])
plt.show()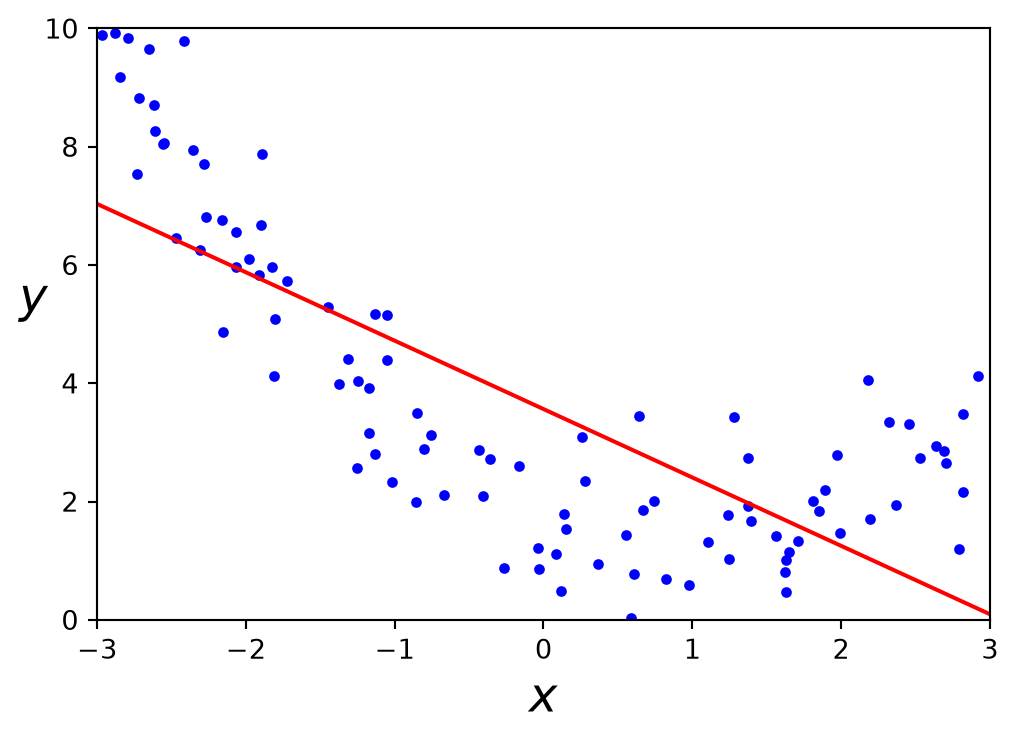
Un modèle linéaire représente mal ce jeu de données.
PolynomialFeatures
Produit une nouvelle matrice d’attributs composée de toutes les combinaisons polynomiales dont le degré est inférieur ou égal au degré indiqué. Par exemple, pour un échantillon d’entrée bidimensionnel de la forme [a, b], les attributs polynomiaux de degré 2 sont [1, a, b, a^2, ab, b^2].
PolynomialFeatures
Avec deux attributs a et b, PolynomialFeatures et degree=3 ajoutent a^2, a^3, b^2, b^3, ainsi que ab, a^2b et ab^2.
Avertissement
Avec include_bias=True, le nombre total d’attributs de sortie est
\binom{D+d}{d} = \frac{(D+d)!}{d!D!},
où D est le nombre d’attributs d’entrée. Avec include_bias=False, il faut en soustraire un.
Régression polynomiale
Code
lin_reg = LinearRegression()
lin_reg = lin_reg.fit(X_poly, y)

X_new = np.linspace(-3, 3, 100).reshape(100, 1)
X_new_poly = poly_features.transform(X_new)
y_new = lin_reg.predict(X_new_poly)

plt.figure(figsize=(5, 3))
plt.plot(X, y, "b.")
plt.plot(X_new, y_new, "r-", linewidth=2, label="Prédictions")
plt.xlabel("$x_1$")
plt.ylabel("$y$", rotation=0)
plt.legend(loc="upper left")
plt.axis([-3, 3, 0, 10])
plt.grid()
plt.show()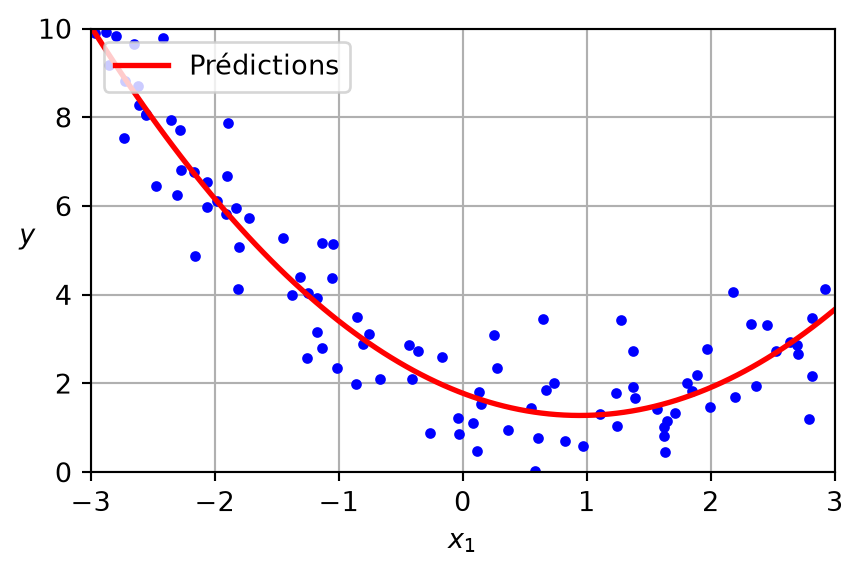
Polynôme appris
Les données ont été produites par l’équation suivante, à laquelle un bruit gaussien a été ajouté.
y = 0.5 x^2 - 1.0 x + 2.0
Voici le modèle appris.
\hat{y} = 0.56 x^2 + (-1.06) x + 1.78
Quantité et augmentation des données
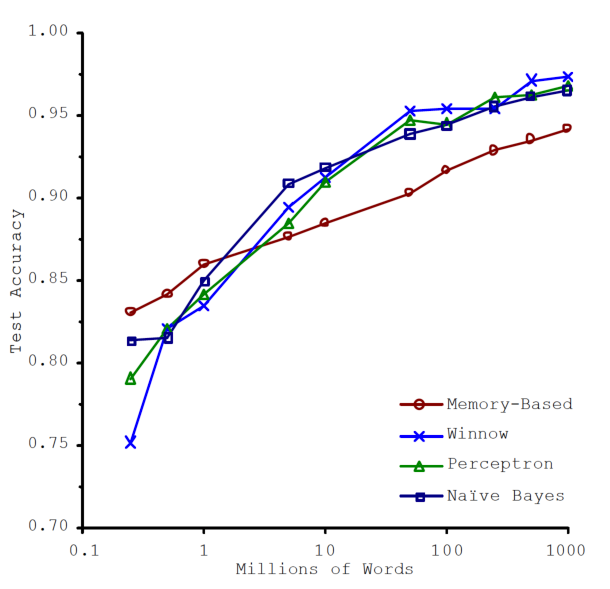
La taille compte
Pour la tâche langagière étudiée par Banko et Brill, l’augmentation de la taille du corpus d’entraînement a produit des gains importants pour plusieurs algorithmes d’apprentissage.
Définition
L’augmentation des données (data augmentation) crée des exemples d’entraînement supplémentaires au moyen de transformations qui devraient préserver l’étiquette cible.
Augmentation des données
- Images : rotations, translations, recadrages, symétries ou bruit, lorsque ces transformations préservent l’étiquette.
- Texte : paraphrases ou modifications soigneusement contrôlées qui préservent le sens et l’étiquette attribuée.
Conclusion
Lectures complémentaires

- Machine Learning Engineering, par Andriy Burkov (Burkov 2020).
- Traite de la collecte, du stockage et du prétraitement des données, de l’ingénierie des attributs, des tests et du débogage, ainsi que du déploiement, du retrait et de l’entretien des modèles.
- Écrit par l’auteur de The Hundred-Page Machine Learning Book (Burkov 2019).
- Offert selon une formule « lire d’abord, acheter ensuite ».
Résumé
- Faire correspondre l’encodage catégoriel au caractère nominal ou ordinal des données.
- Ajuster la mise à l’échelle, l’encodage et l’imputation sur les données d’entraînement au moyen d’un pipeline.
- Choisir la mise à l’échelle selon l’estimateur; elle ne rend pas un attribut normalement distribué.
- Appliquer les remèdes au déséquilibre des classes seulement dans les partitions d’entraînement et évaluer sur la distribution naturelle.
- Utiliser des attributs polynomiaux et des interactions pour enrichir la représentation d’un modèle tout en contrôlant sa complexité.
- Privilégier des données représentatives et correctement étiquetées, et n’utiliser que des augmentations qui préservent l’étiquette.
Prochaine leçon
- Prochaine étape : les réseaux de neurones artificiels.
Références
Annexe : vidéo
Unreasonable Effectiveness of Data
Annexe : pipeline
Pipeline
from sklearn.compose import ColumnTransformer, make_column_selector
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

numeric_pipeline = Pipeline([
    ('imputer', SimpleImputer(strategy="median", add_indicator=True)),
    ('scaler', StandardScaler()),
])

preprocessor = ColumnTransformer([
    (
        "numeric",
        numeric_pipeline,
        make_column_selector(dtype_include=np.number),
    ),
    (
        "categorical",
        OneHotEncoder(handle_unknown="ignore"),
        make_column_selector(dtype_exclude=np.number),
    ),
])

full_pipeline = Pipeline([
    ("preprocessor", preprocessor),
    ("classifier", LogisticRegression()),
])Marcel Turcotte
École de science informatique et de génie électrique (ÉSIGÉ)
Université d’Ottawa