Introduction aux réseaux de neurones artificiels
CSI 4506 - automne 2026
Version : 20 oct. 2026 15h33
Préambule
Message du jour
Message du jour
Message du jour (suite)
Message du jour (2024)
Objectifs d’apprentissage
- Expliquer comment les poids, les biais et les activations déterminent le calcul de propagation avant d’un réseau.
- Expliquer pourquoi des couches cachées avec des activations non linéaires peuvent représenter XOR.
- Comparer la forme et l’ensemble des valeurs de sortie de la sigmoïde, de tanh et de ReLU.
- Énoncer les hypothèses et les limites du théorème d’approximation universelle.
- Construire et évaluer un classificateur Keras sur Fashion-MNIST avec un prétraitement cohérent et des ensembles d’entraînement, de validation et de test distincts.
Introduction
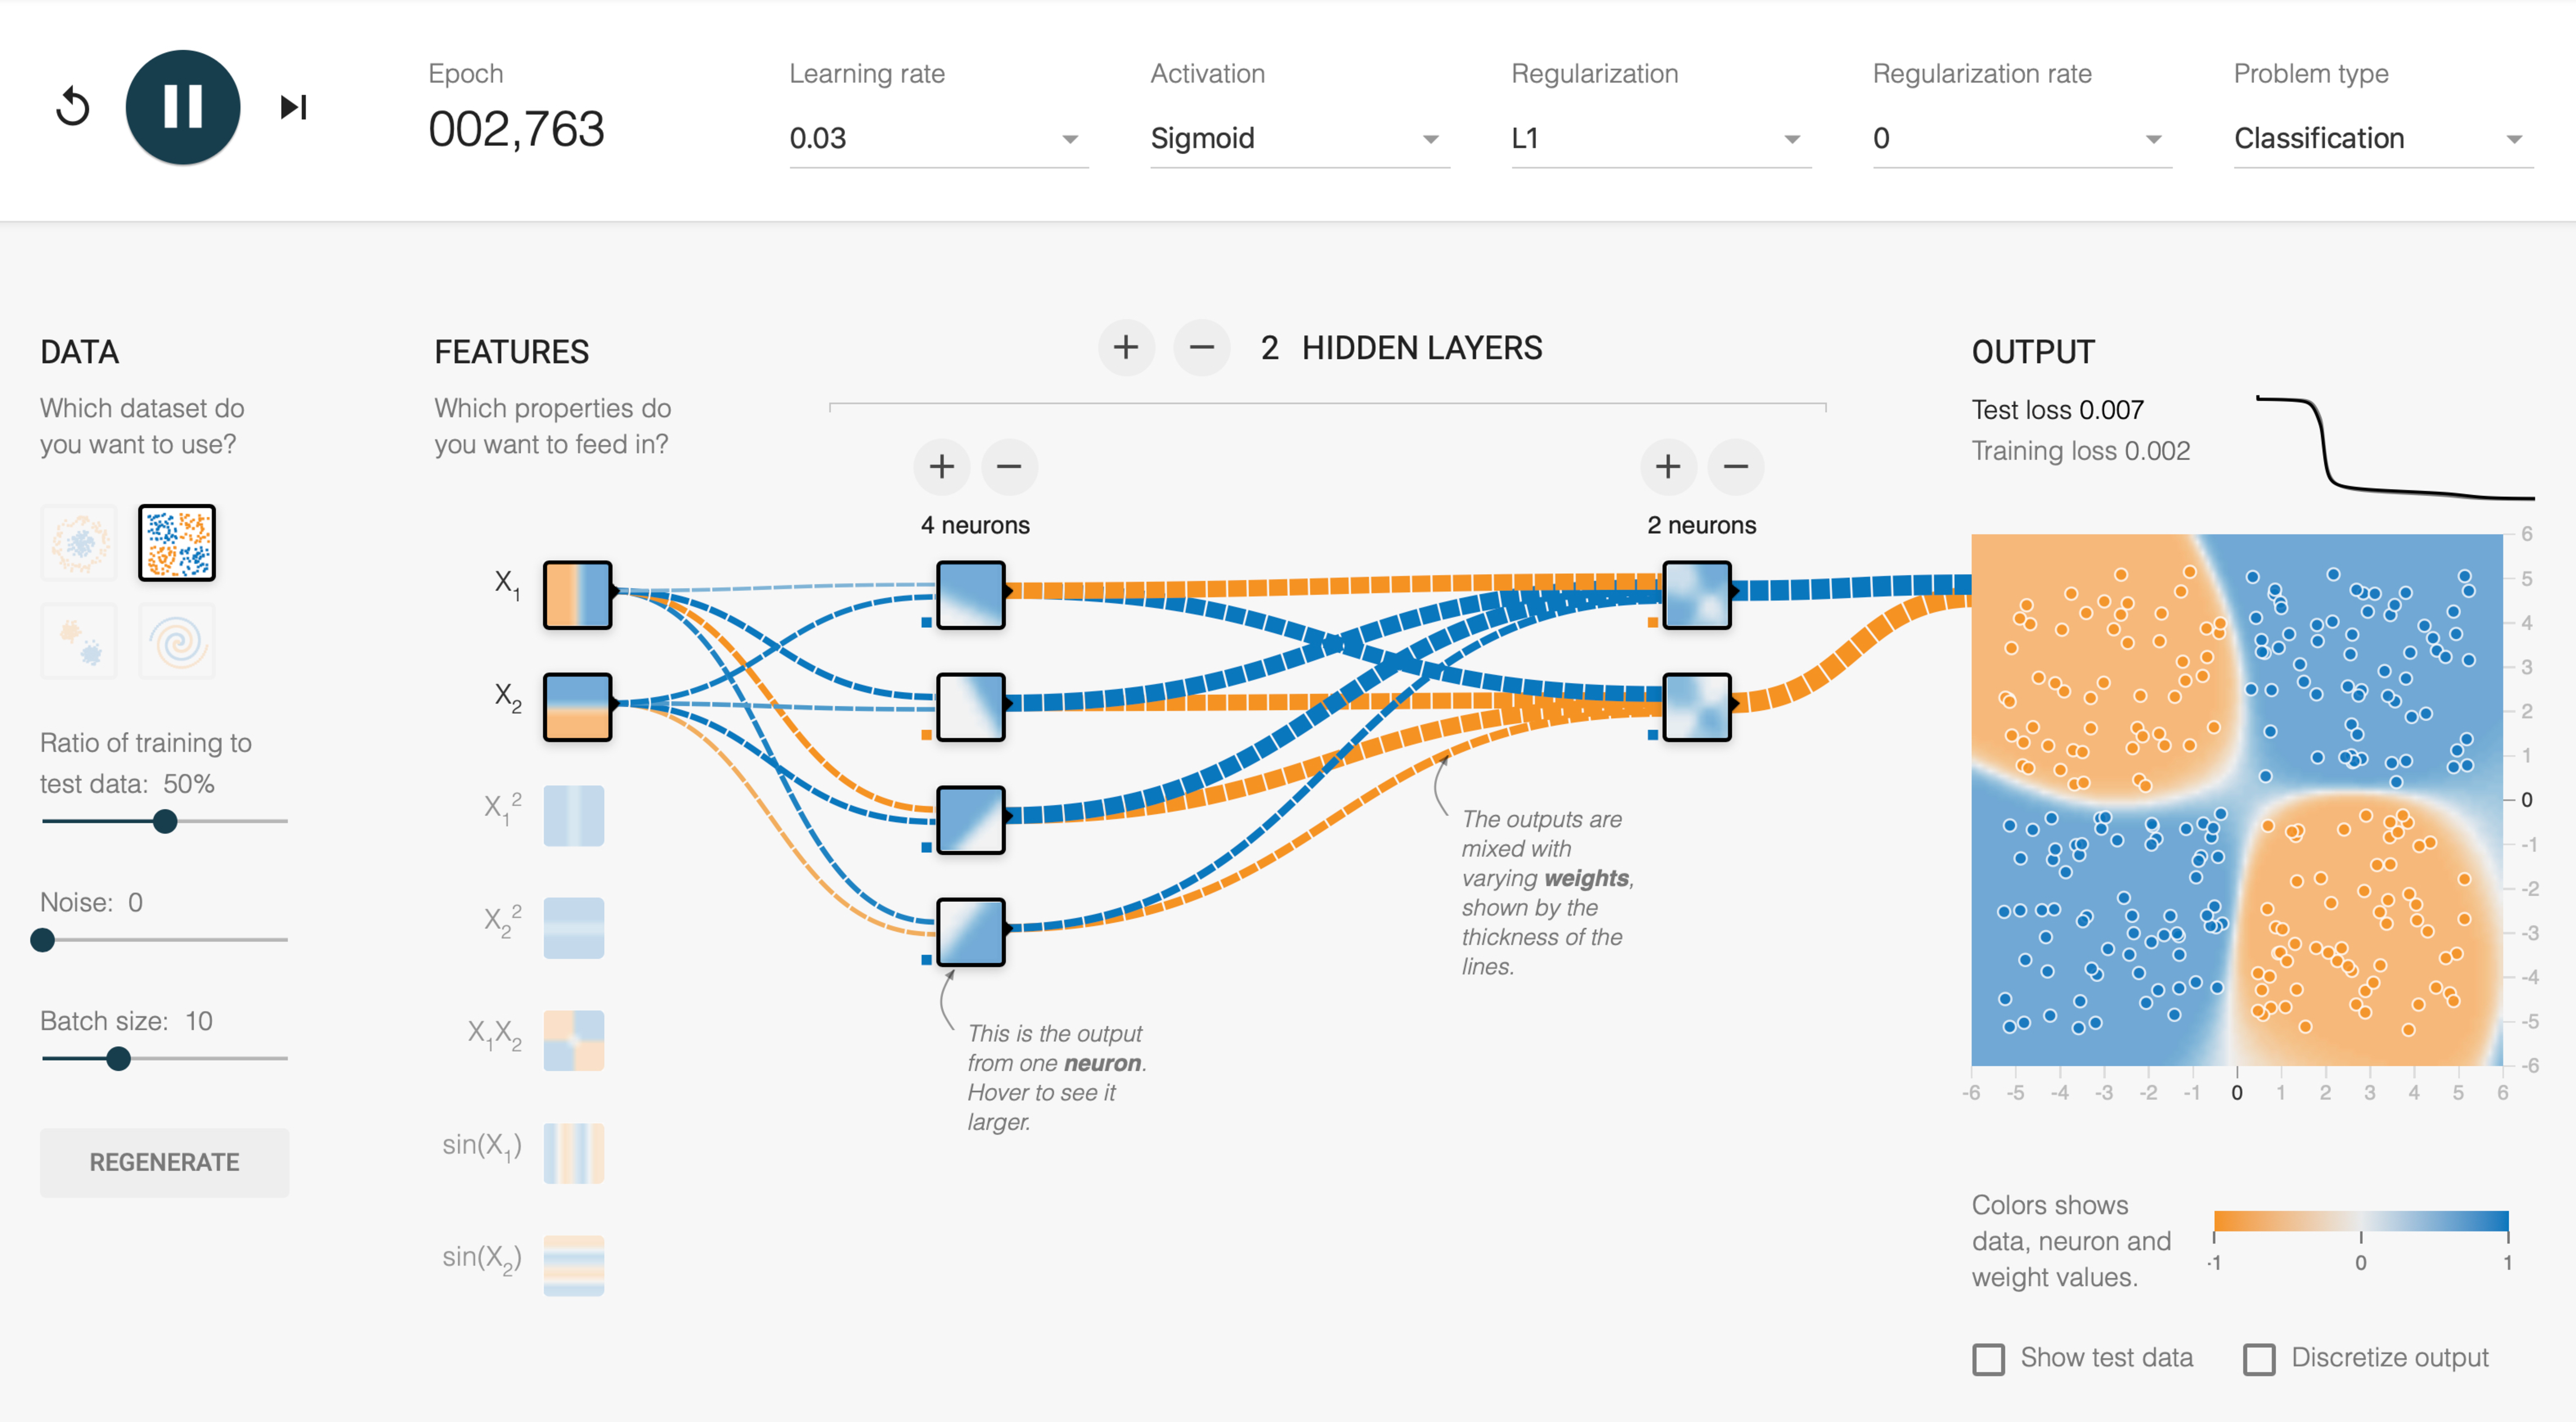
TensorFlow Playground
Réseaux de neurones (NN)
Les réseaux de neurones artificiels sont des modèles d’apprentissage automatique composés d’unités de calcul interconnectées, inspirées des neurones biologiques.
- Calcul : avec des paramètres fixés, un réseau associe des sorties aux entrées.
- Apprentissage : l’entraînement utilise des exemples pour ajuster les paramètres.
Problèmes d’apprentissage automatique
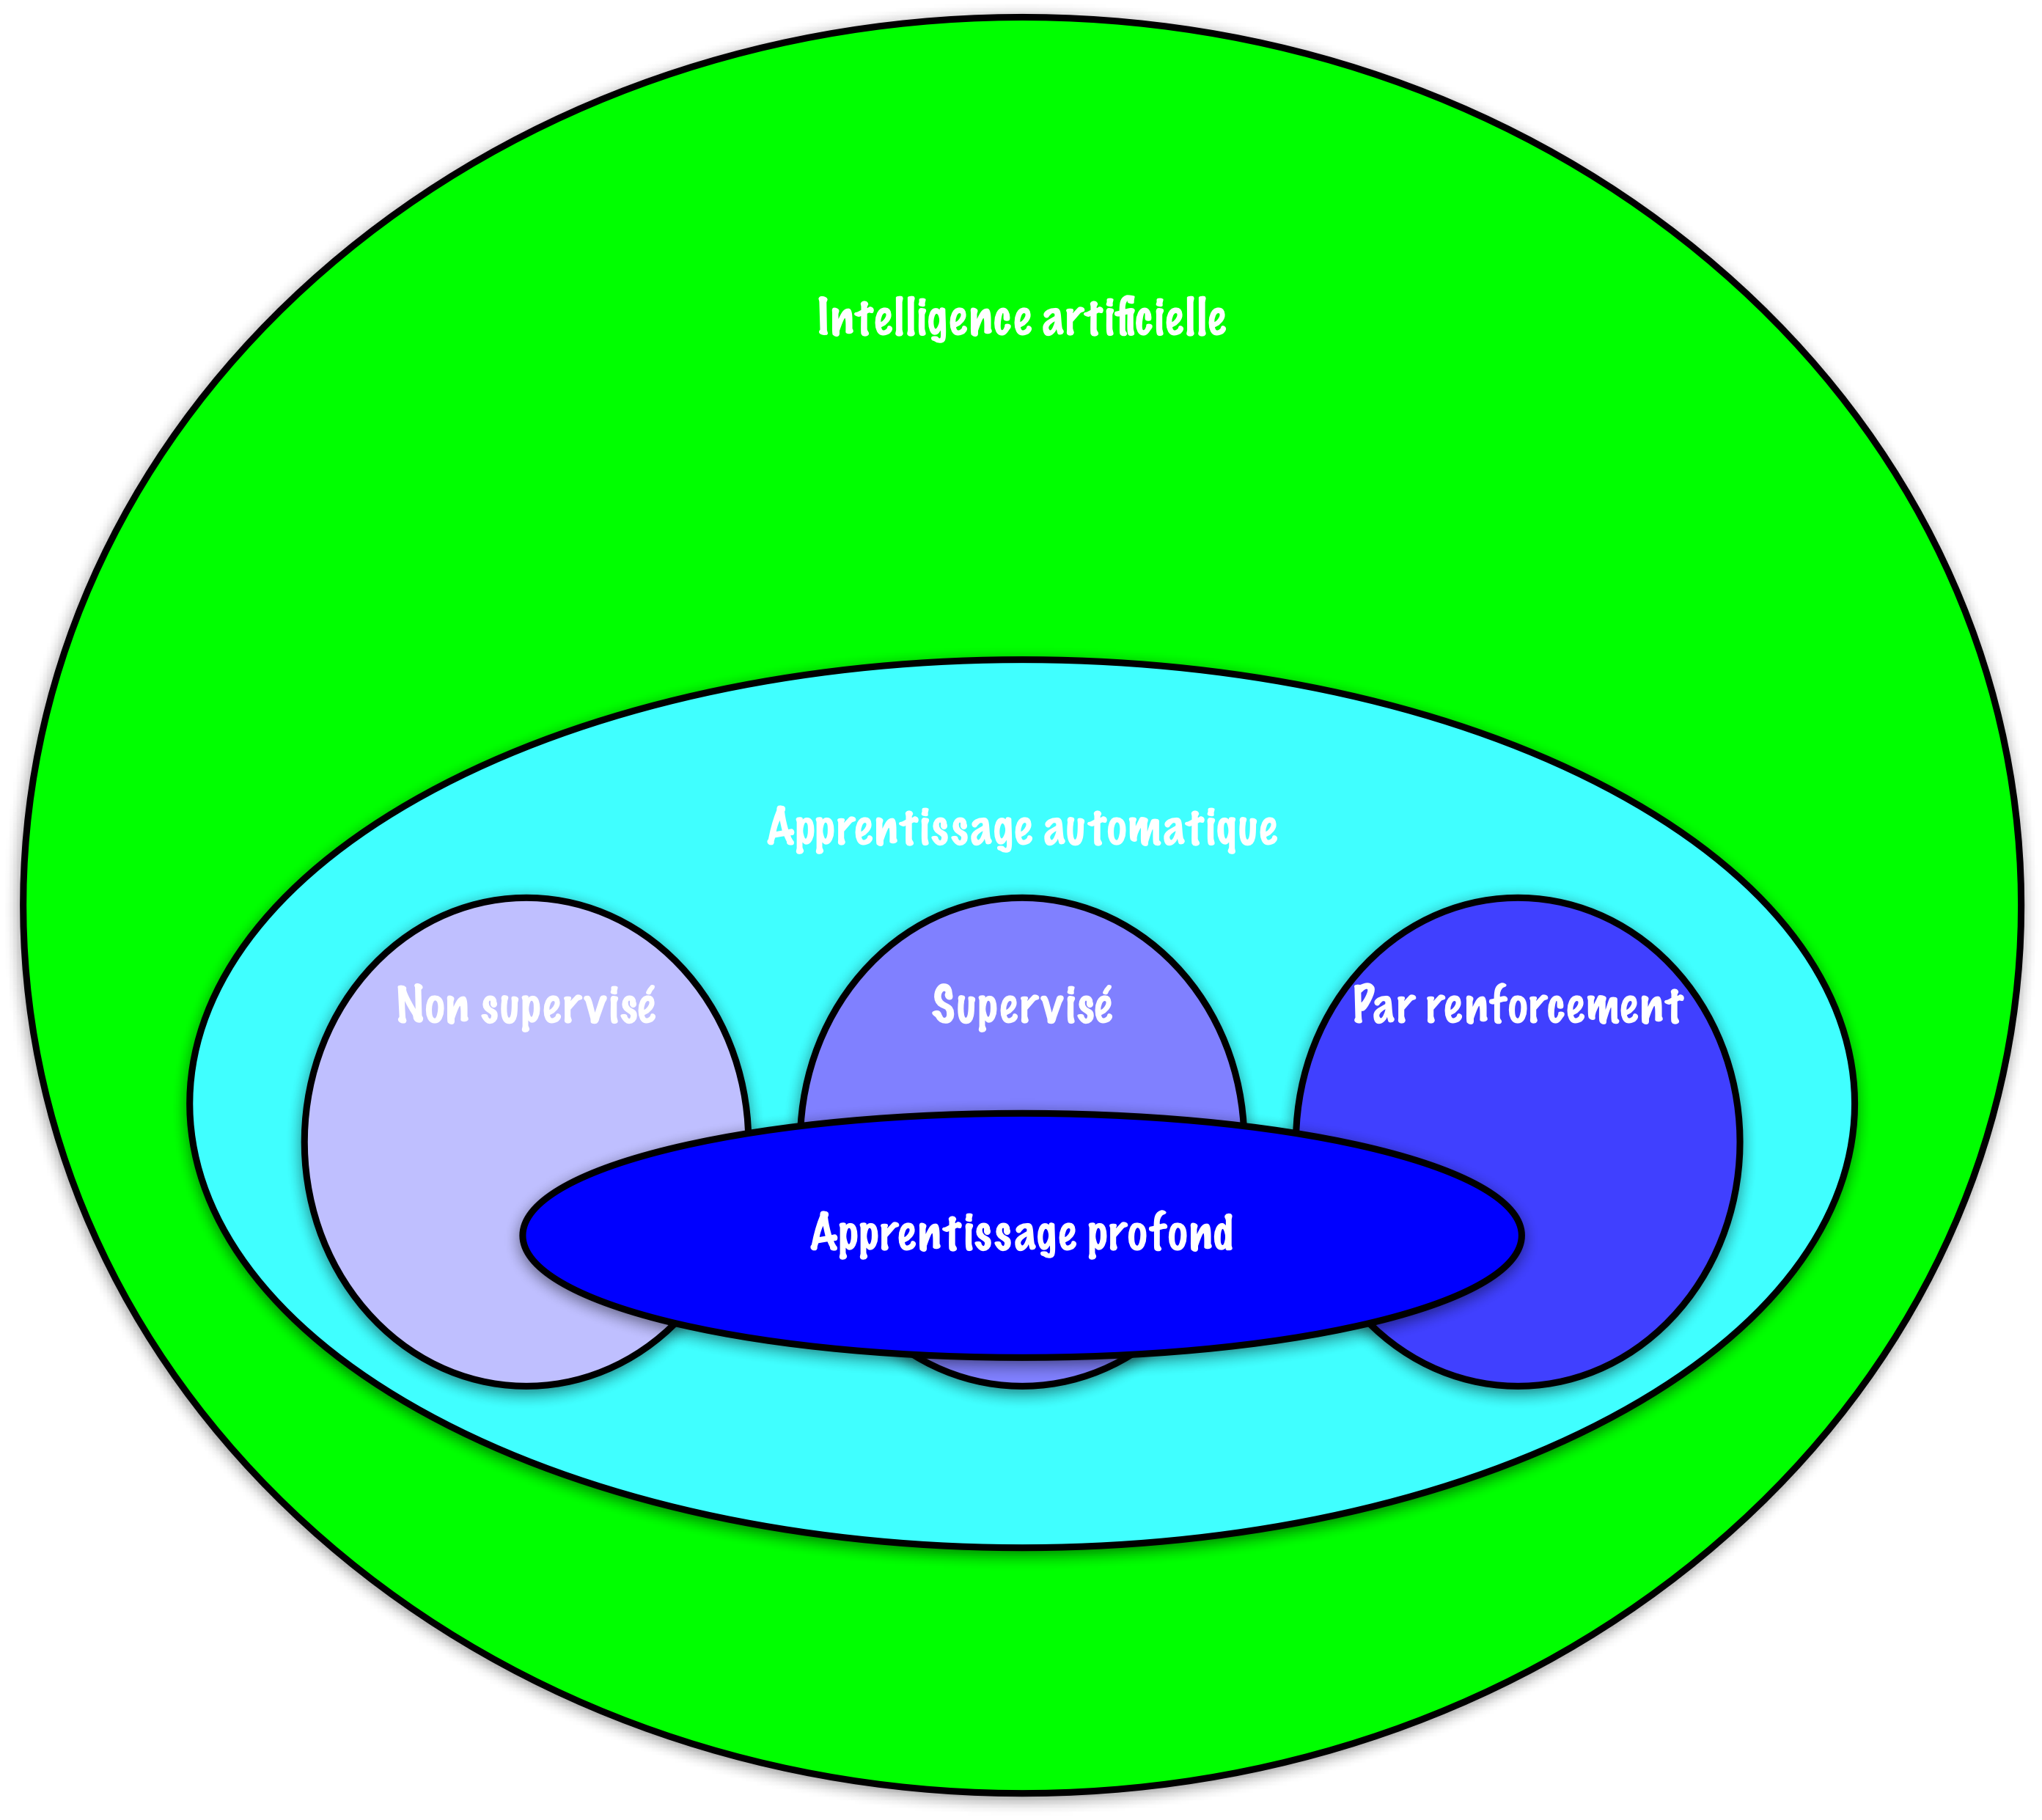
Apprentissage supervisé : classification, régression
Apprentissage non supervisé : autoencodeurs, apprentissage autosupervisé (self-supervised learning)
Apprentissage par renforcement : les réseaux y occupent désormais une place importante
Un neurone

Neurones interconnectés
Neural Mind
Lakoff et Narayanan (2025)
Les neurones ne sont que des cellules. Seuls, ils sont incapables de penser. Mais, réunis en circuits reliés à notre corps de manière appropriée, ils ont permis aux êtres humains de survivre, de penser, de communiquer et de créer toute la culture.
Connexionnisme
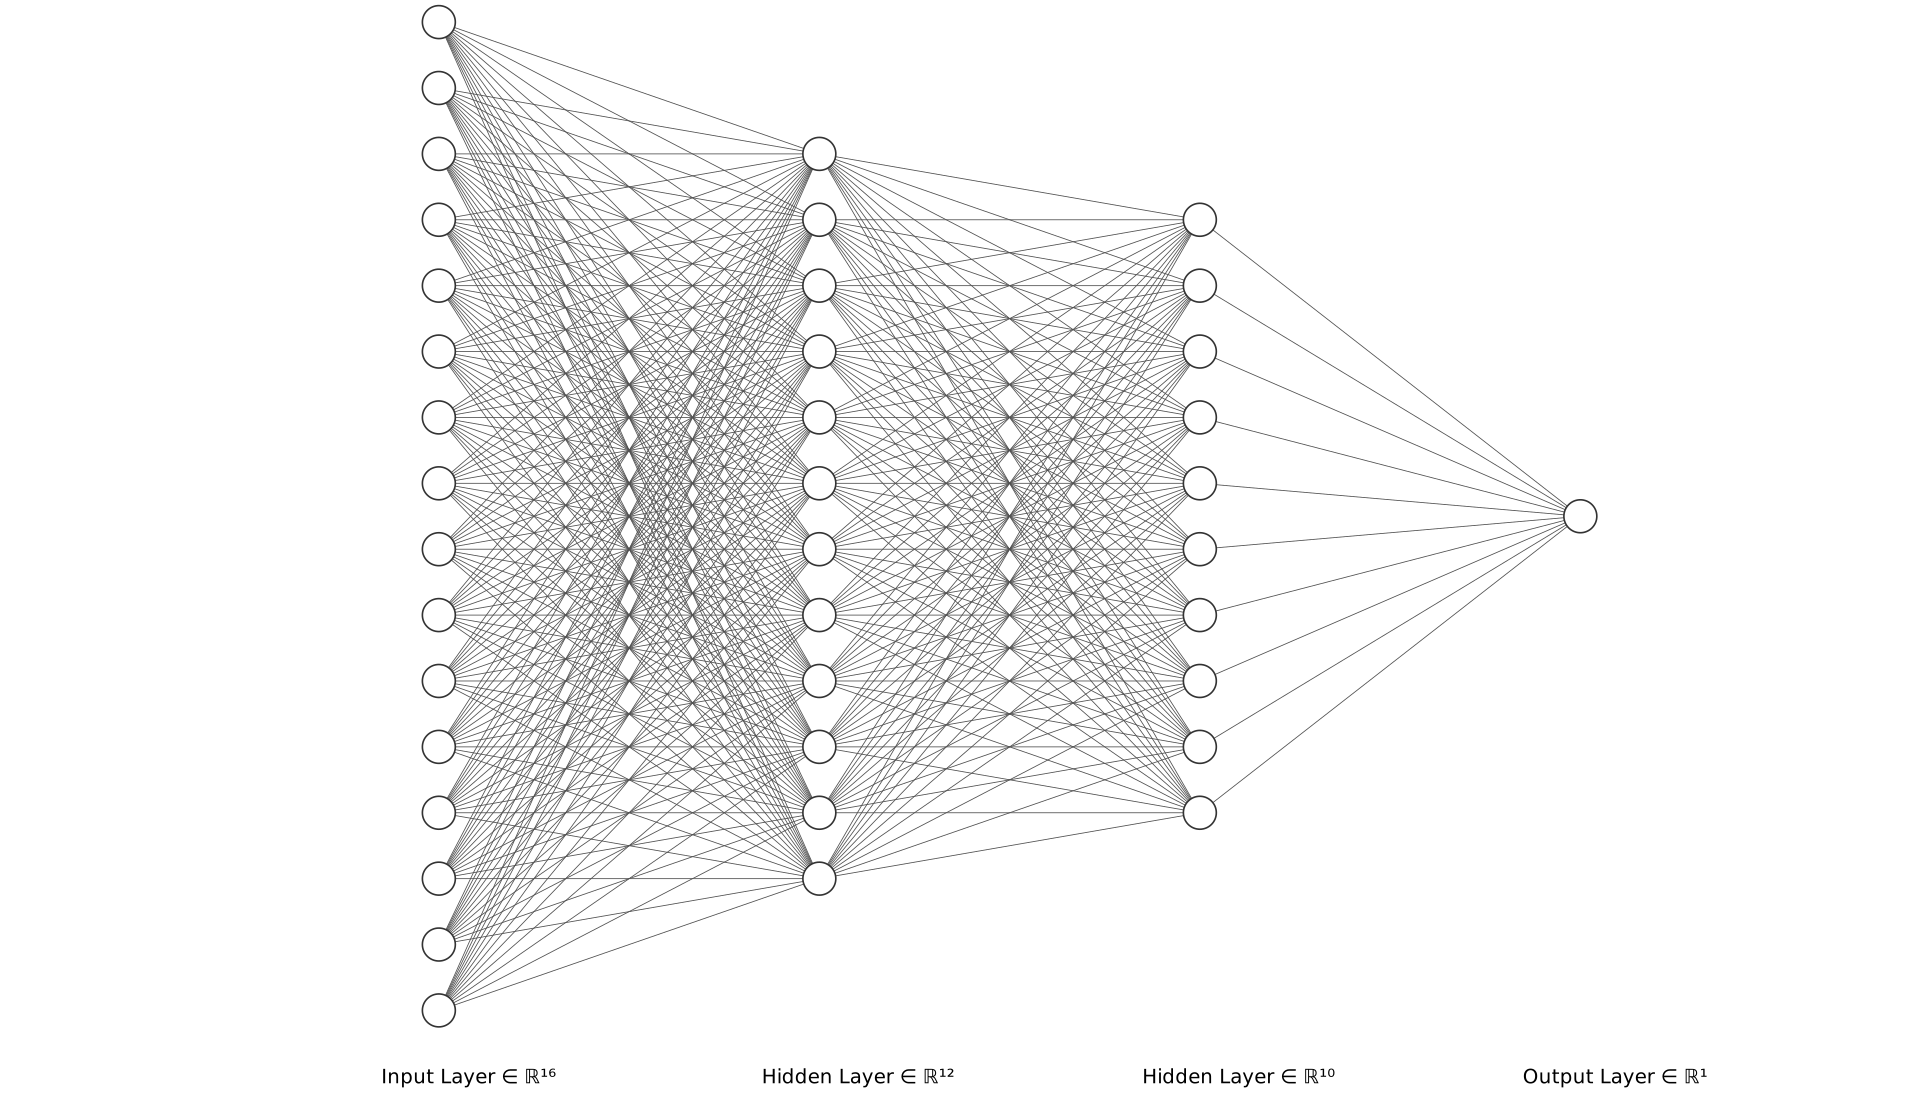
Hiérarchie des concepts
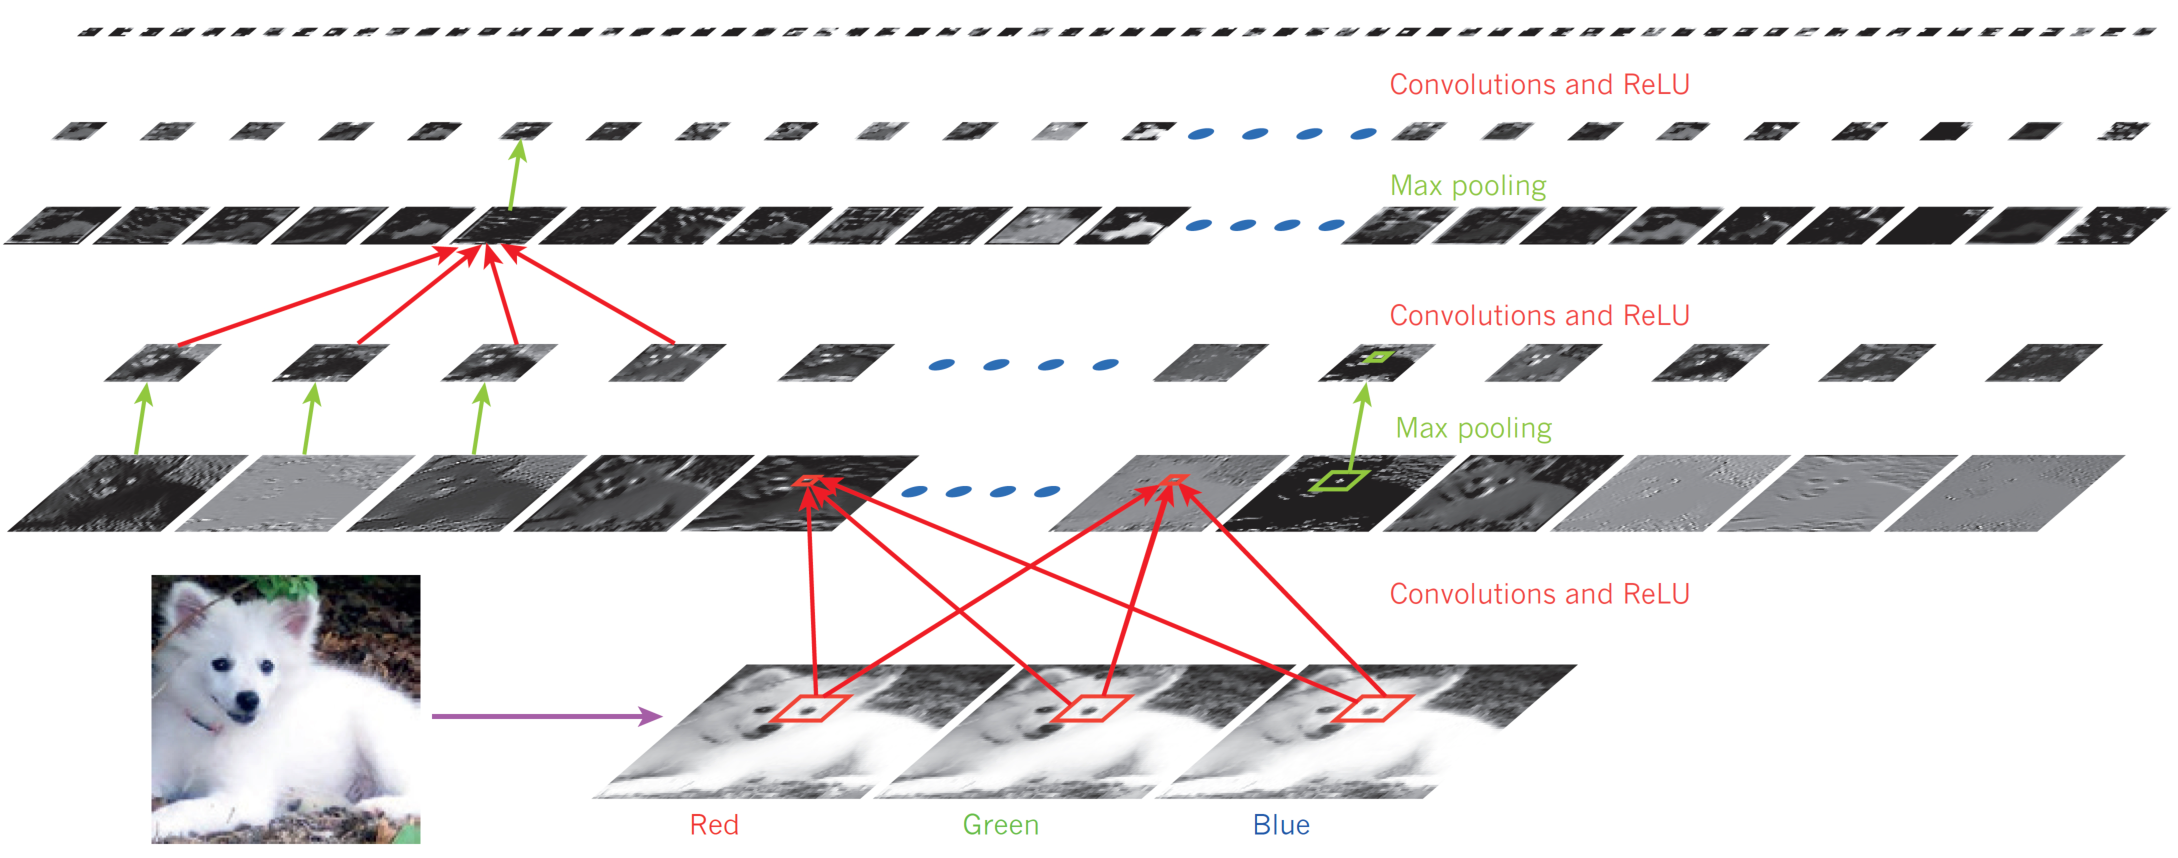
Notions de base
Calcul avec des unités à seuil
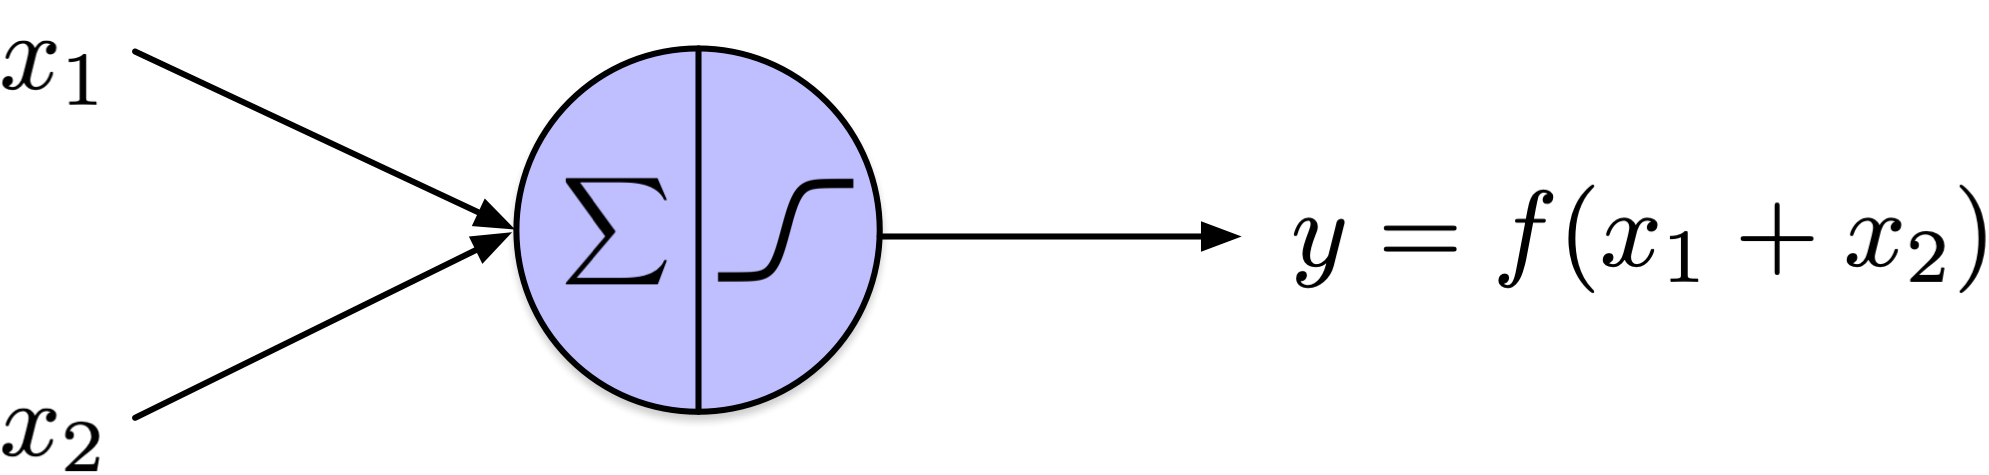
où x_1, x_2 \in \{0,1\} et f(z) est une fonction de seuil (step function) :
f(z)= \begin{cases}0, & z<\theta \\ 1, & z \geq \theta\end{cases}
Calcul avec des unités à seuil
f(x_1 + x_2)= \begin{cases}0, & x_1 + x_2 <\theta \\ 1, & x_1 + x_2 \geq \theta\end{cases}
Avec \theta = 2, l’unité réalise une porte logique ET.
Avec \theta = 1, l’unité réalise une porte logique OU.
Les réseaux calculent des fonctions
Des réseaux d’unités à seuil peuvent réaliser des fonctions booléennes en composant des opérations logiques.
Lorsque les connexions et les seuils sont fixés, le réseau effectue un calcul déterminé.
L’apprentissage pose une autre question : comment les données peuvent-elles déterminer les paramètres?
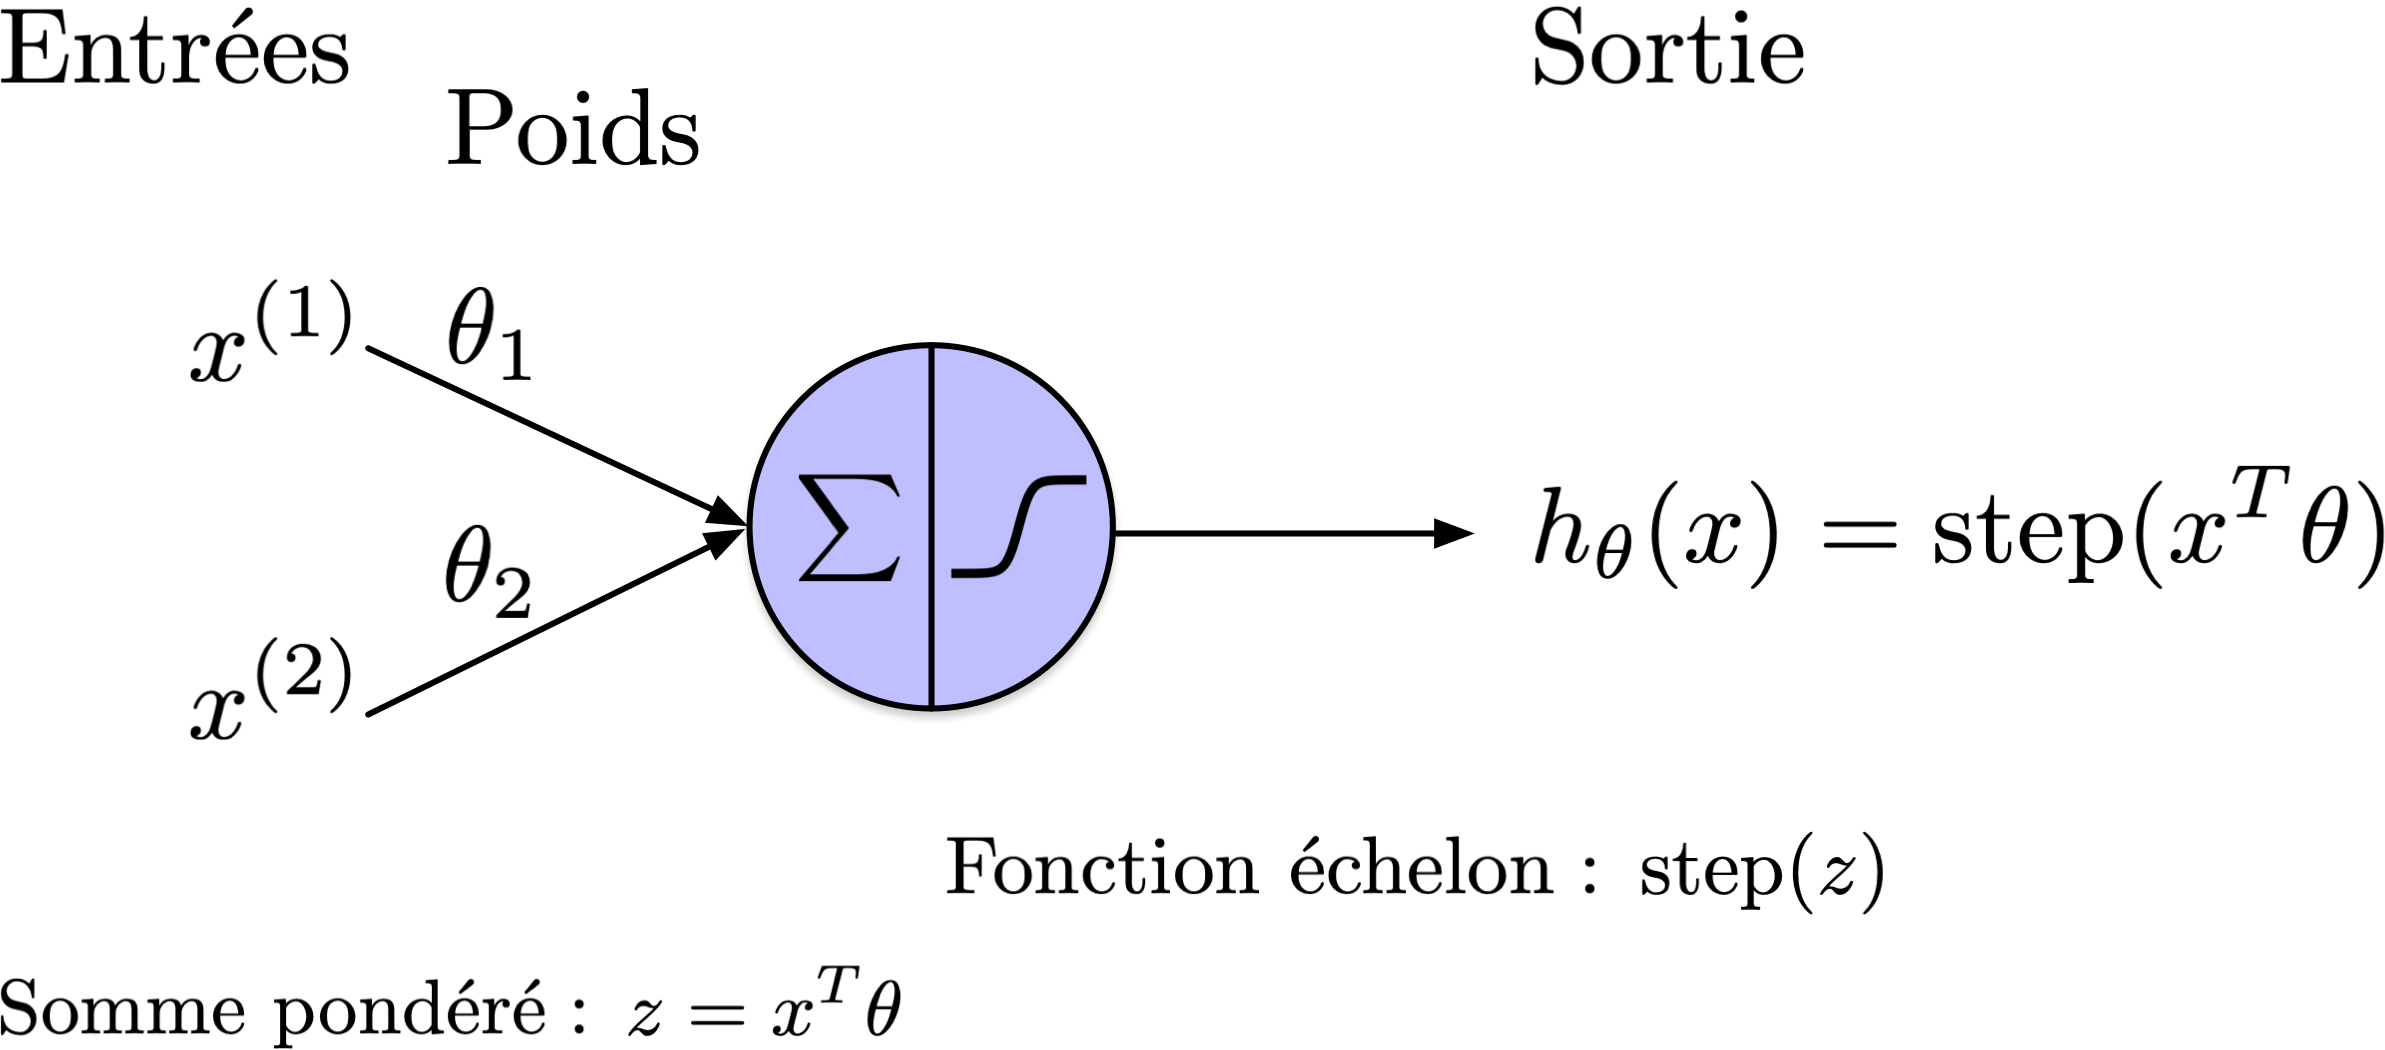
Perceptron
Perceptron
Unité logique à seuil
Fonctions de seuil simples
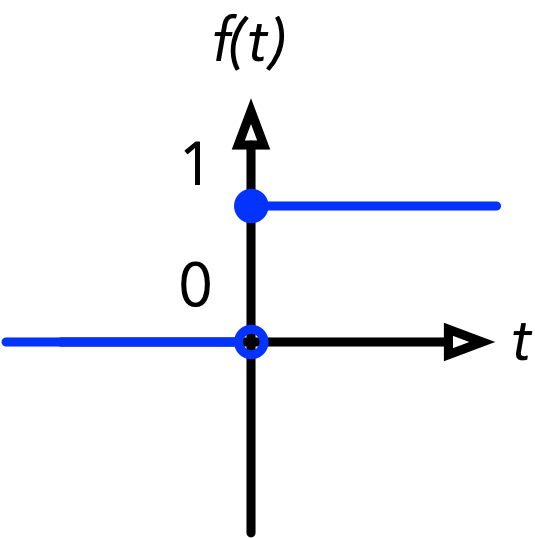
\text{Heaviside}(t) =
1, si t \geq 0
0, si t < 0
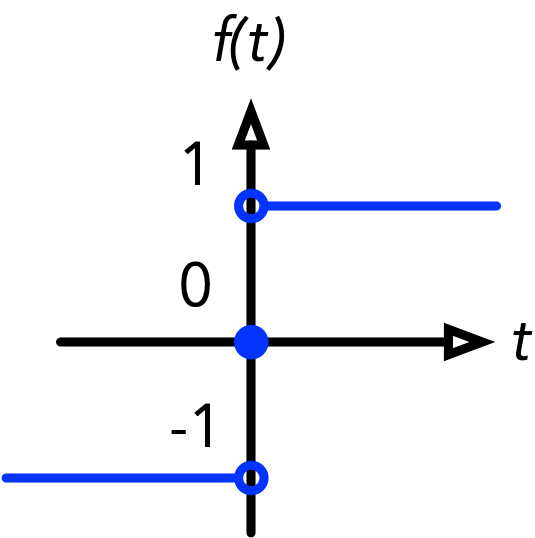
\text{sign}(t) =
1, si t > 0
0, si t = 0
-1, si t < 0
Notation
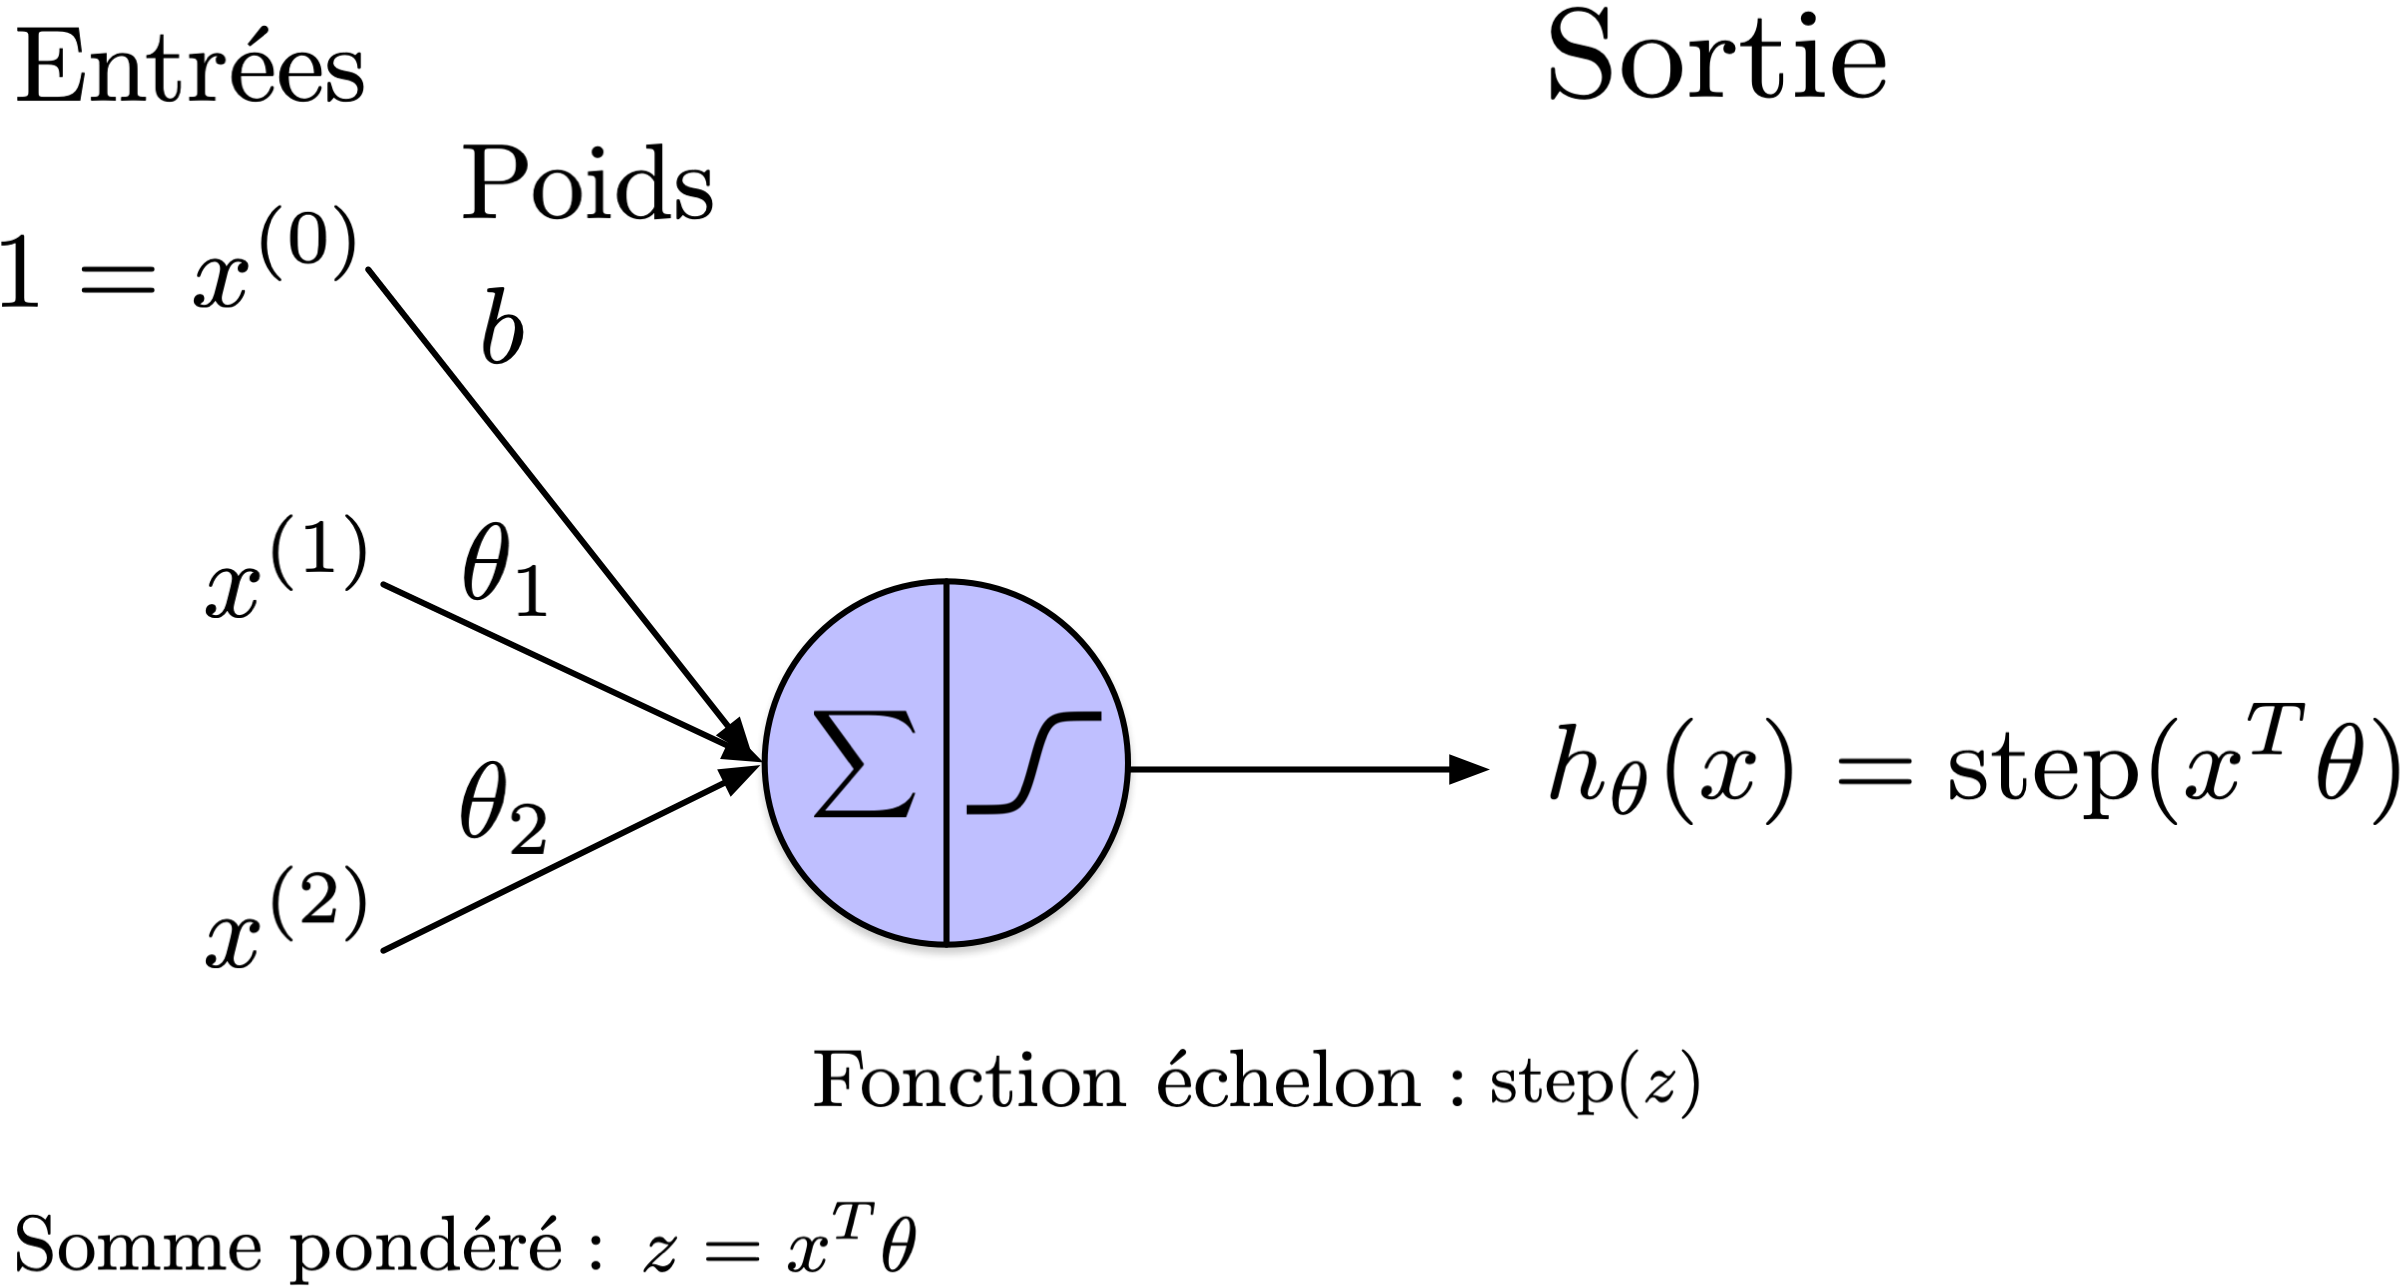
Notation
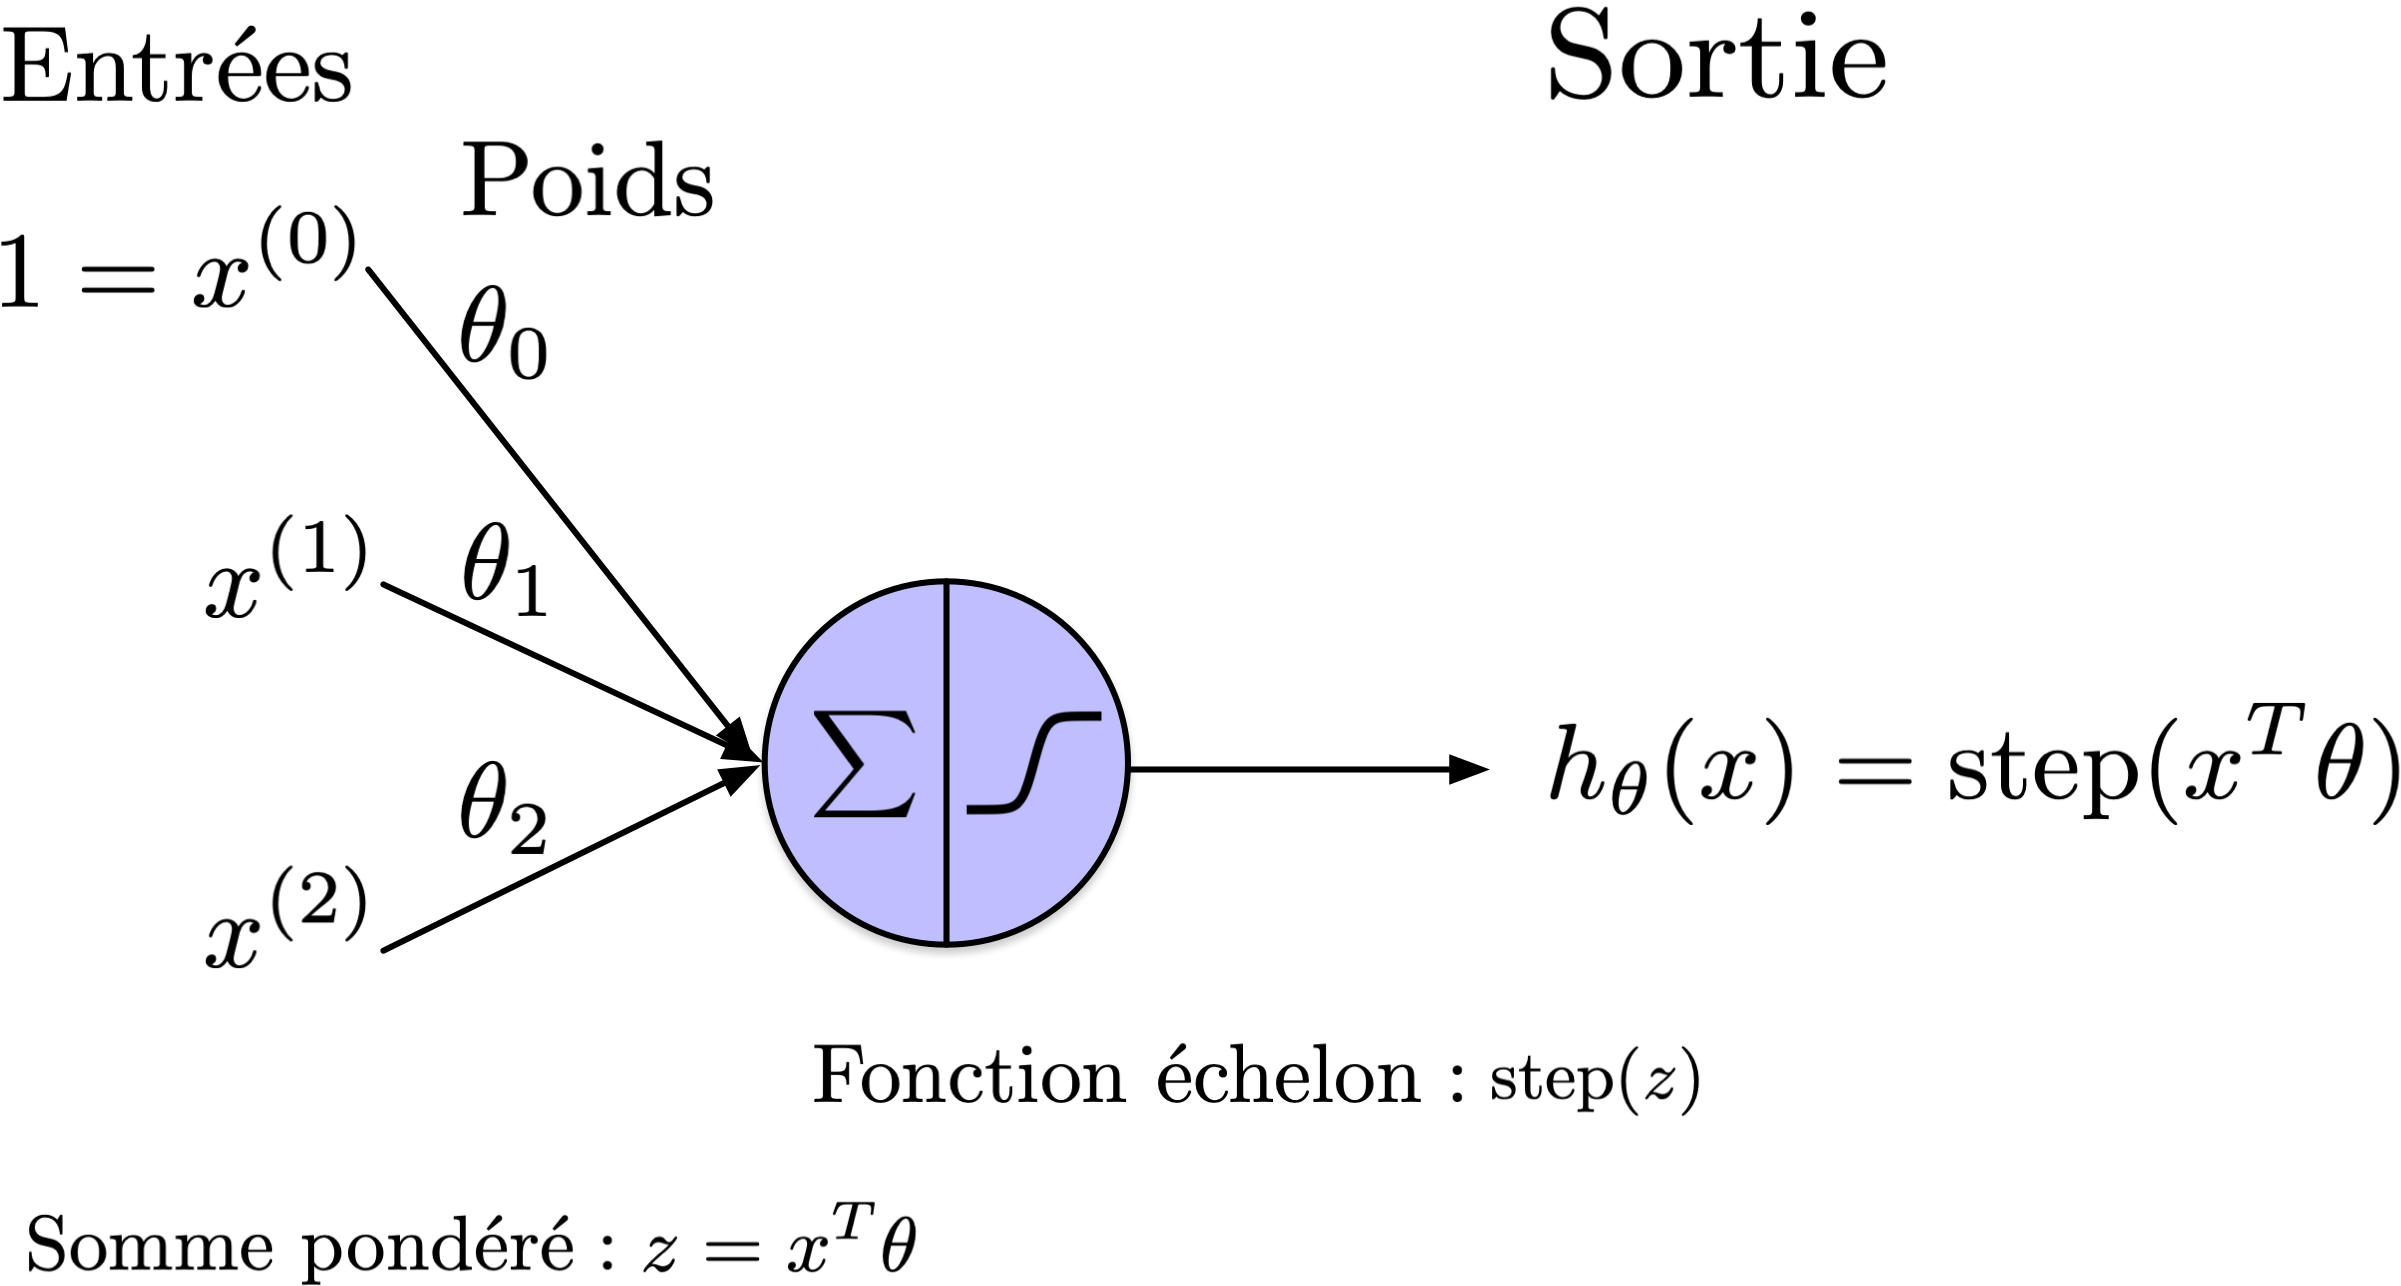
Perceptron
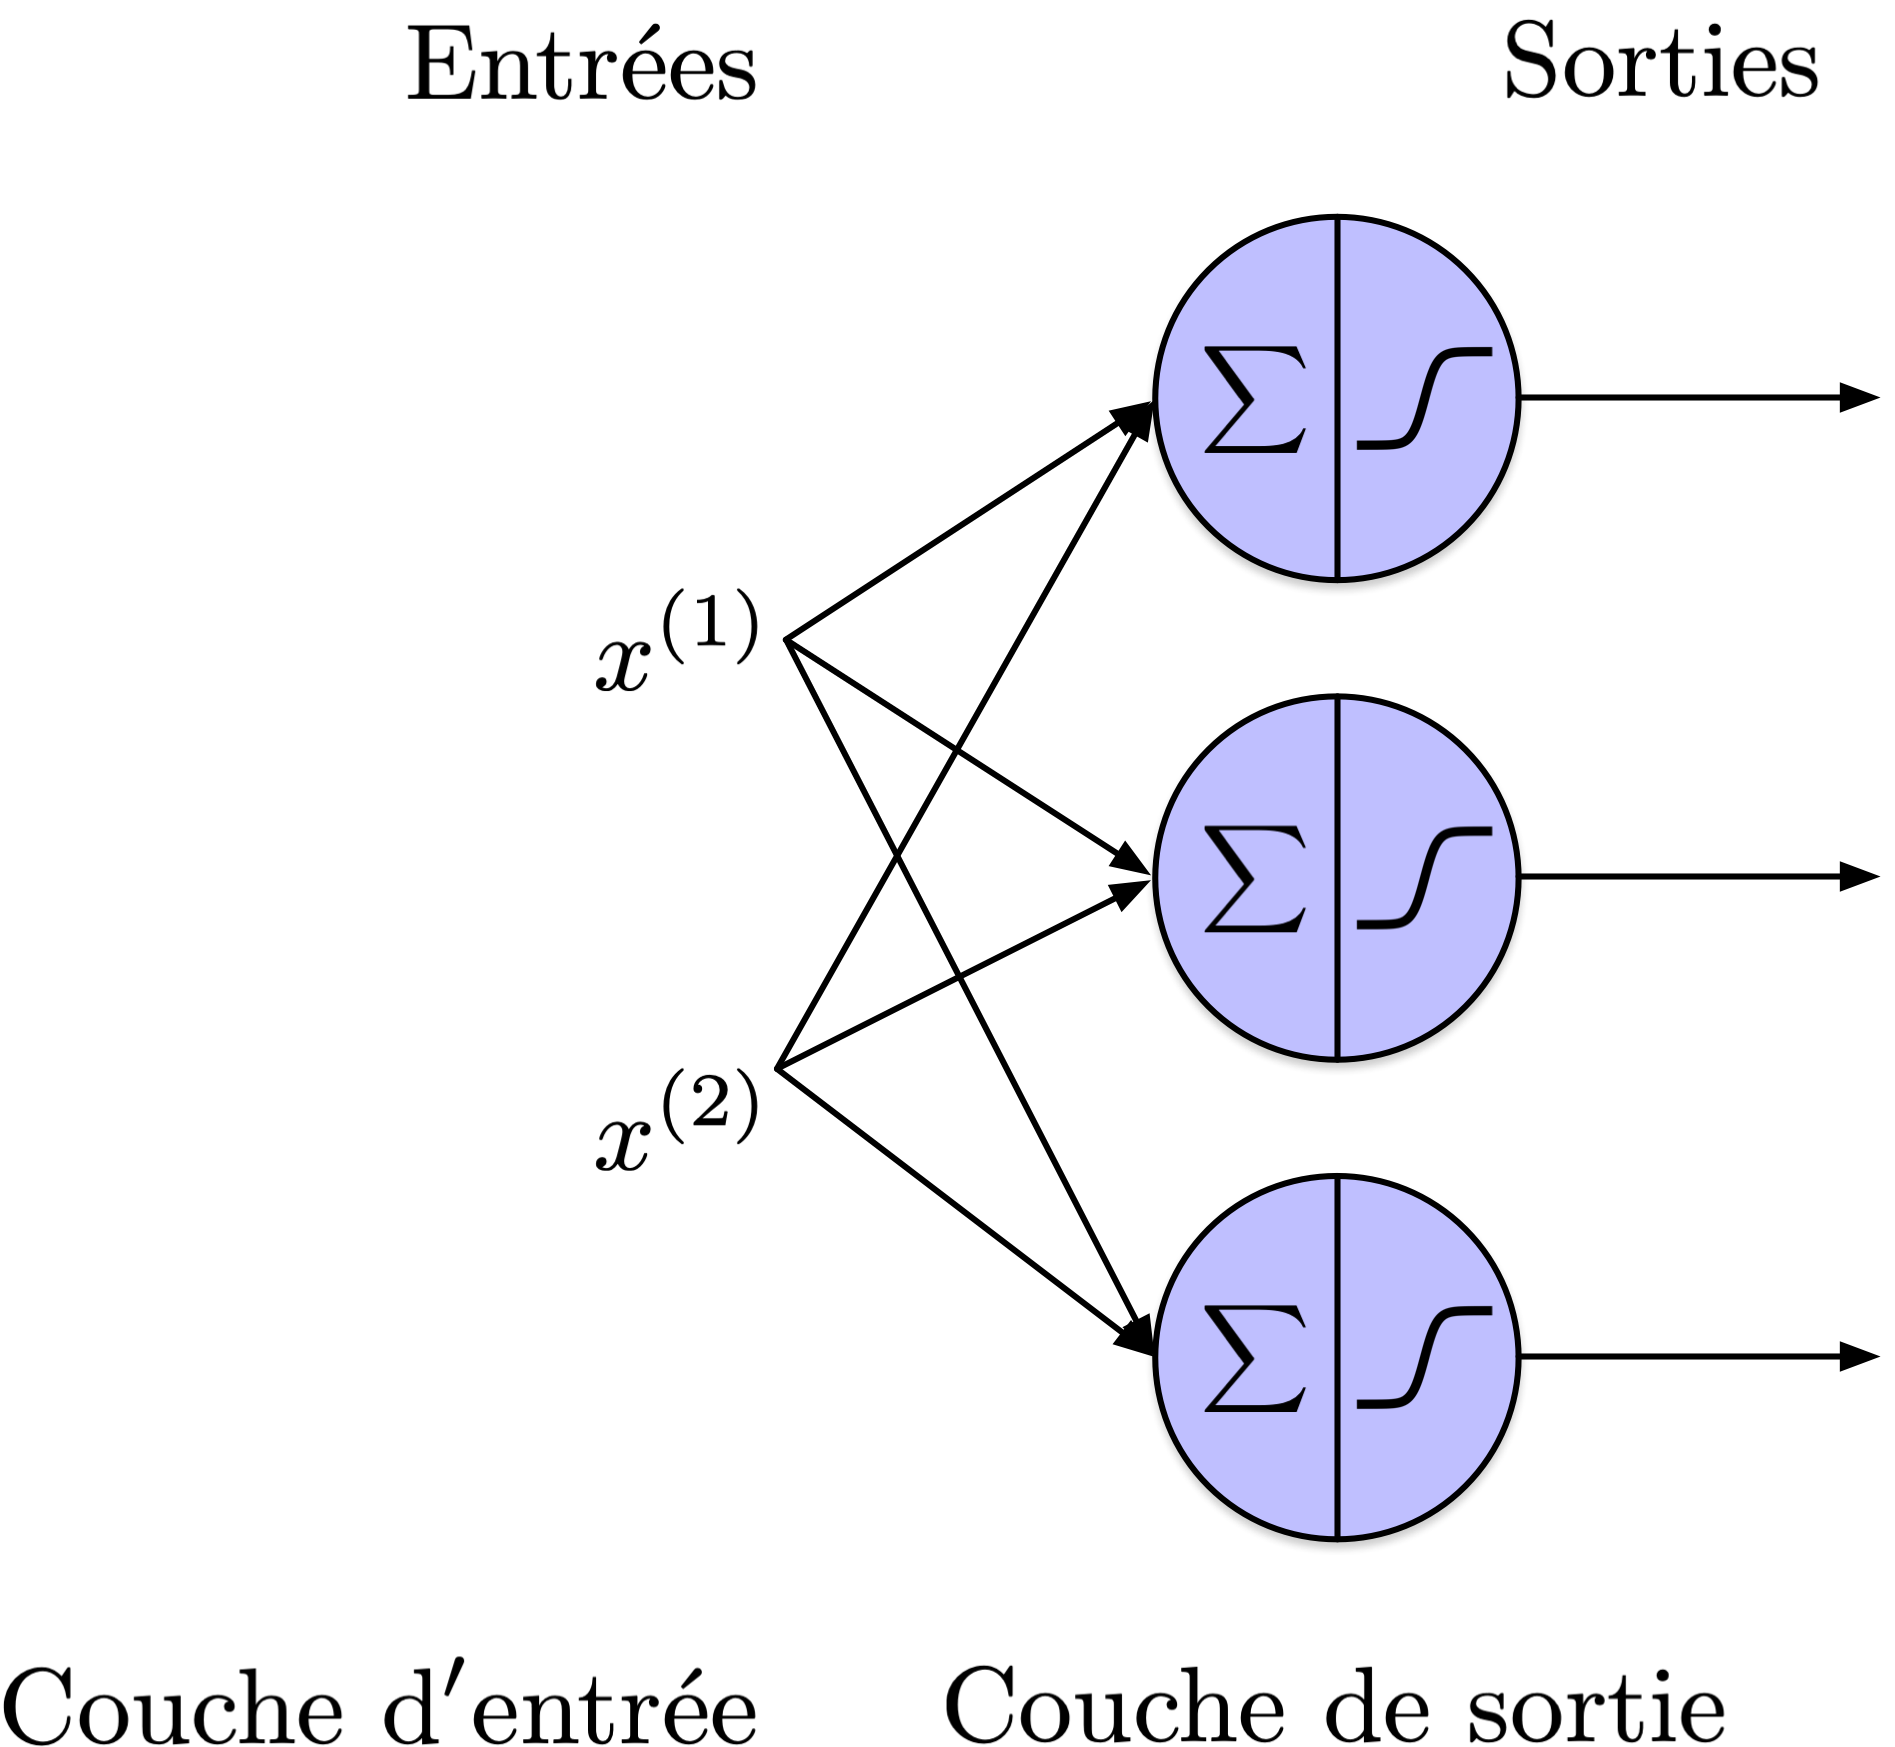
Perceptron
Notation
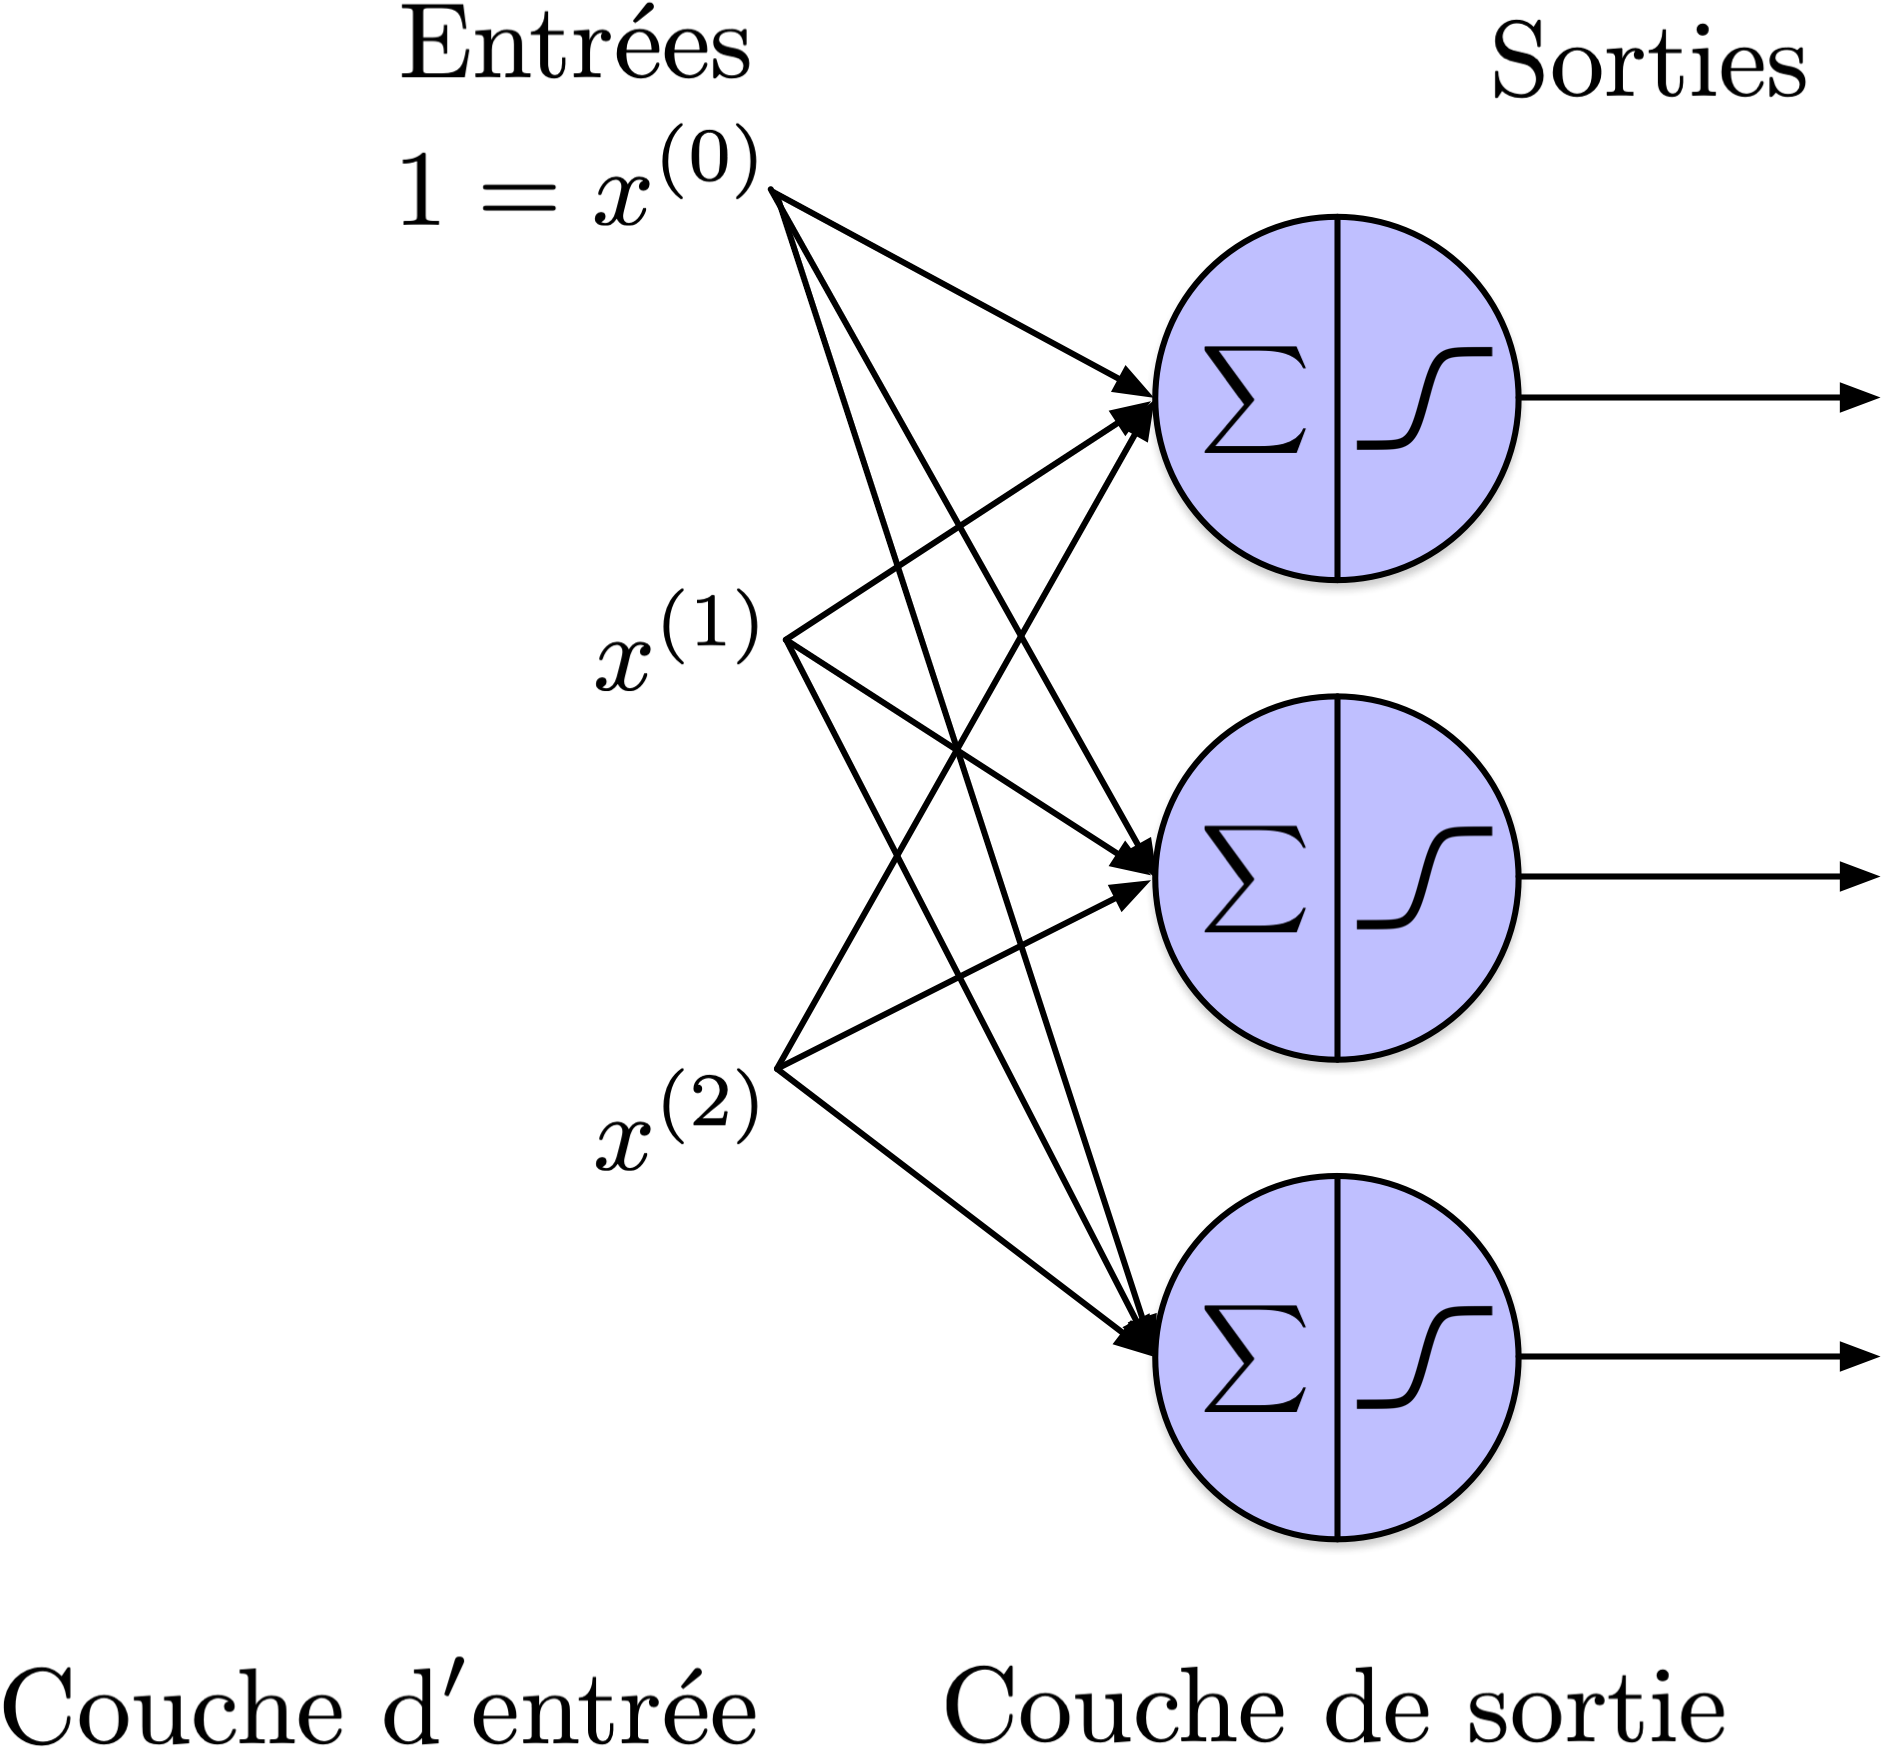
Notation
X est la matrice des données d’entrée : chaque ligne correspond à un exemple et chaque colonne représente l’un des D attributs.
W est la matrice des poids, avec une ligne par entrée (attribut) et une colonne par neurone.
Les biais peuvent être représentés séparément; les deux approches existent dans la littérature. Ici, b est un vecteur dont la longueur est égale au nombre de neurones.
Du calcul à l’apprentissage
- La propagation avant utilise les poids et les biais actuels pour produire une prédiction.
- L’entraînement ajuste ces paramètres à partir d’exemples et de leurs sorties cibles.
- Le perceptron de Rosenblatt a marqué ce passage vers l’apprentissage à partir des données.
Une limite : XOR
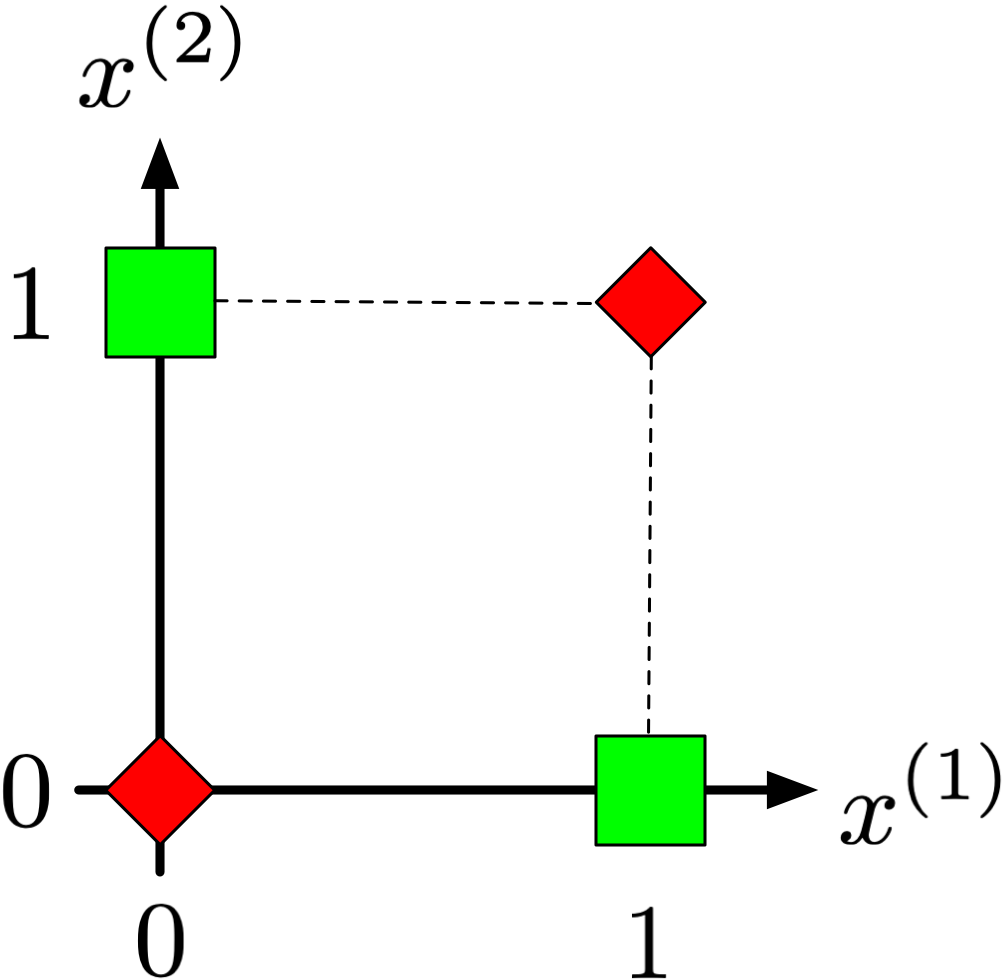
Composition de portes logiques
Au moins une entrée est vraie, et elles ne sont pas toutes les deux vraies :
A\oplus B=(A\lor B)\land\neg(A\land B)
- OU détecte si au moins une entrée est vraie.
- ET détecte si les deux entrées sont vraies.
- La combinaison de leurs sorties donne XOR.
Perceptron multicouche
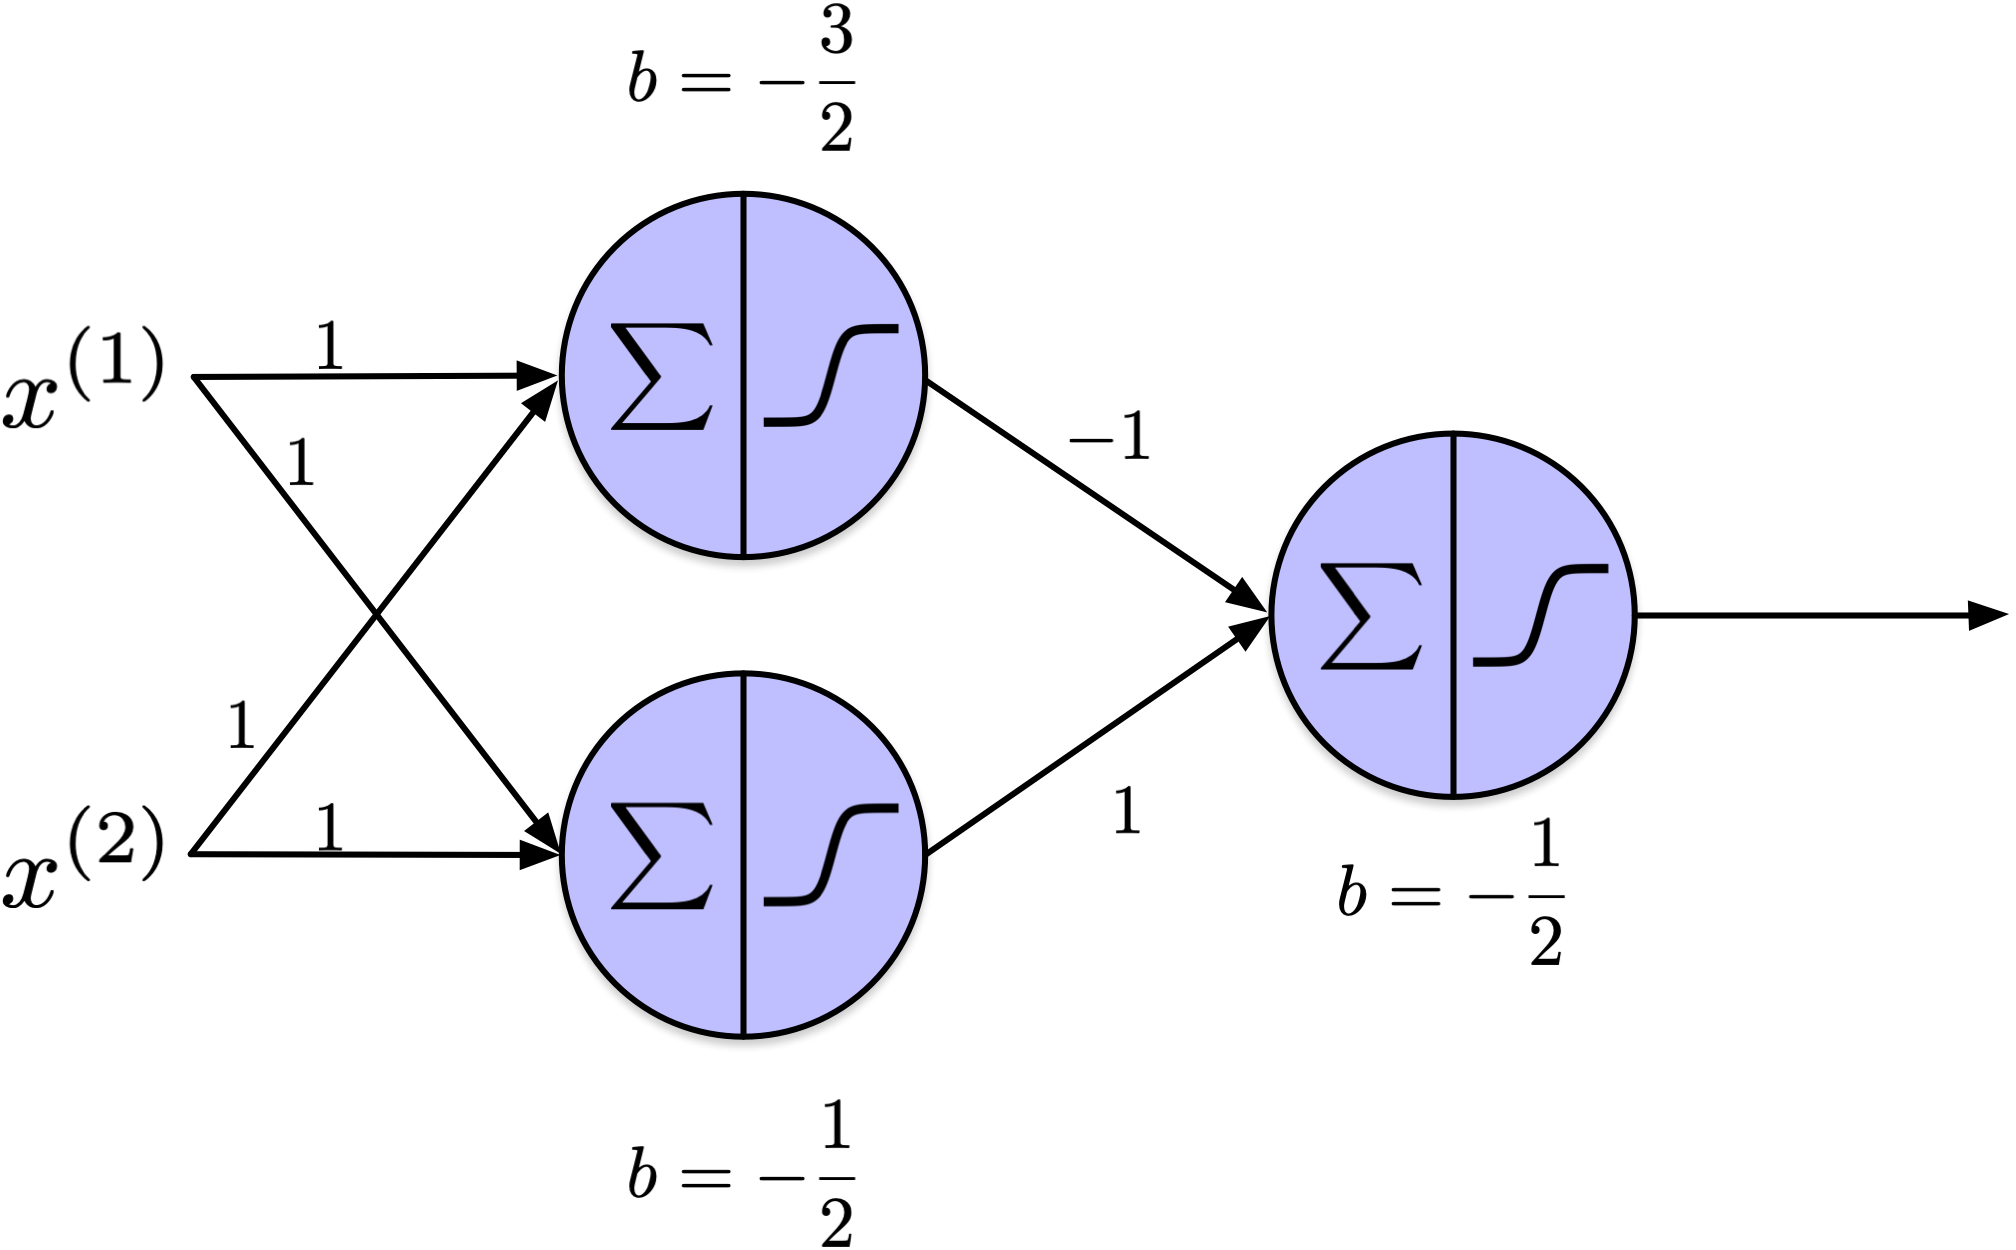
XOR : calculs intermédiaires
| A | B | Cible y | o_1 : ET | o_2 : OU | o_3 : XOR |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 | 1 | 1 |
| 1 | 0 | 1 | 0 | 1 | 1 |
| 1 | 1 | 0 | 1 | 1 | 0 |
RN à propagation avant (FNN)
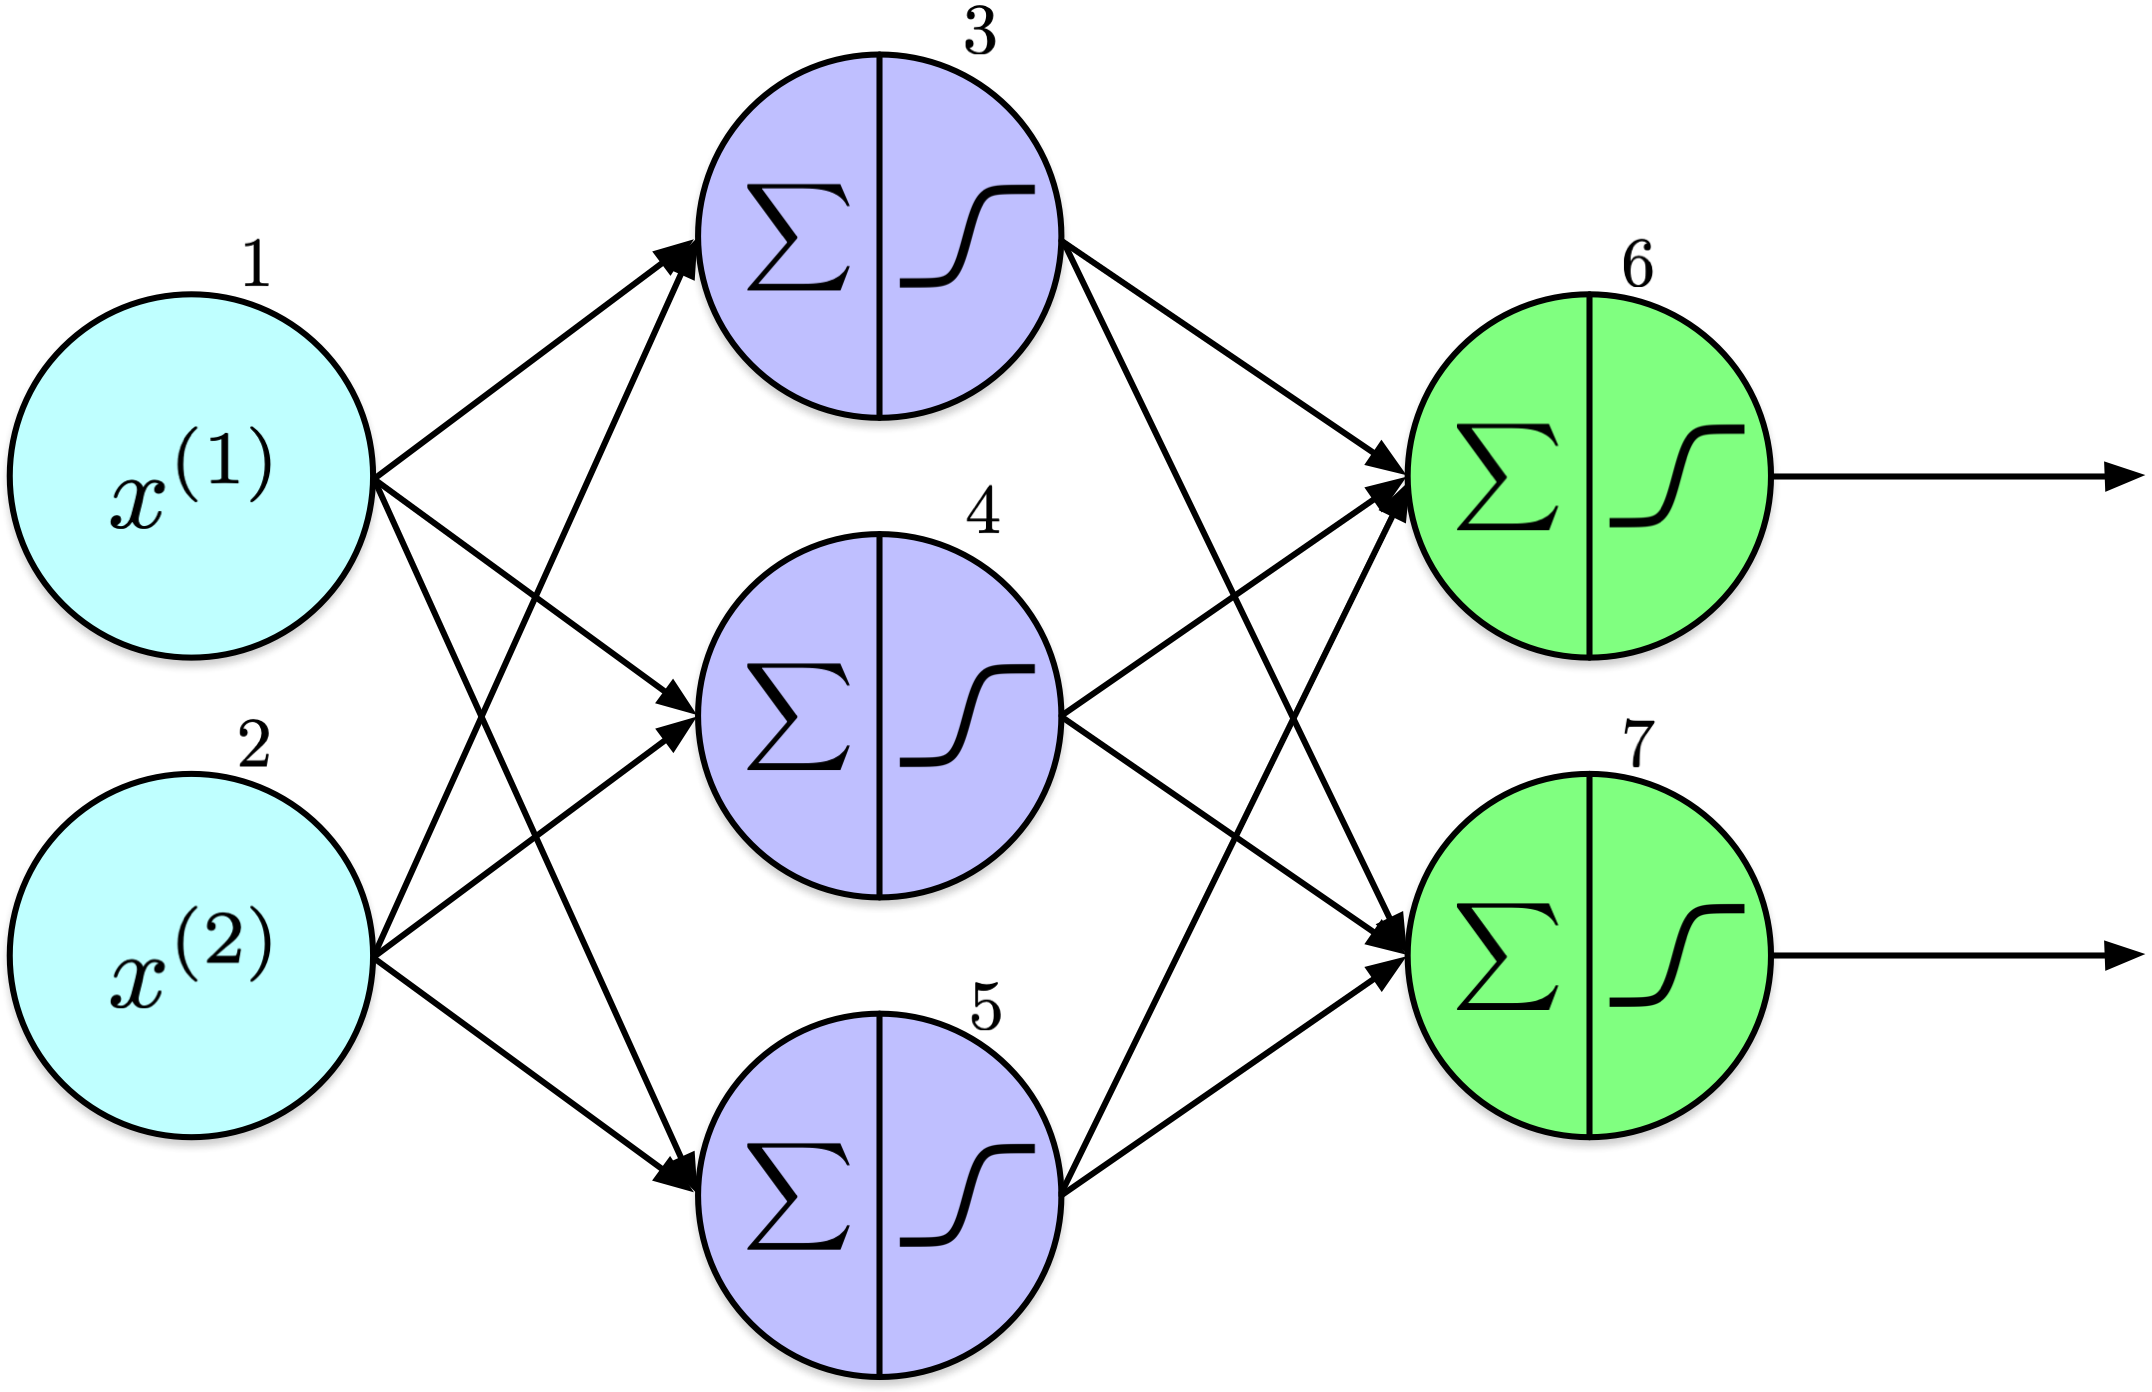
Somme pondérée et activation
Chaque unité de calcul effectue deux opérations :
z_j=\sum_{i\to j} w_{i,j}o_i+b_j, \qquad o_j=\varphi(z_j).
- z_j : somme pondérée plus biais, avant l’activation.
- o_j : sortie de l’unité, après application de l’activation \varphi.
Propagation avant (calcul)
o_3 = \sigma(w_{1,3}x^{(1)}+w_{2,3}x^{(2)}+b_3)
o_4 = \sigma(w_{1,4}x^{(1)}+w_{2,4}x^{(2)}+b_4)
o_5 = \sigma(w_{1,5}x^{(1)}+w_{2,5}x^{(2)}+b_5)
o_6 = \sigma(w_{3,6}o_3+w_{4,6}o_4+w_{5,6}o_5+b_6)
o_7 = \sigma(w_{3,7}o_3+w_{4,7}o_4+w_{5,7}o_5+b_7)
Exemple numérique
(np.float64(0.48638976530233274), np.float64(0.6254814695767328))Propagation avant
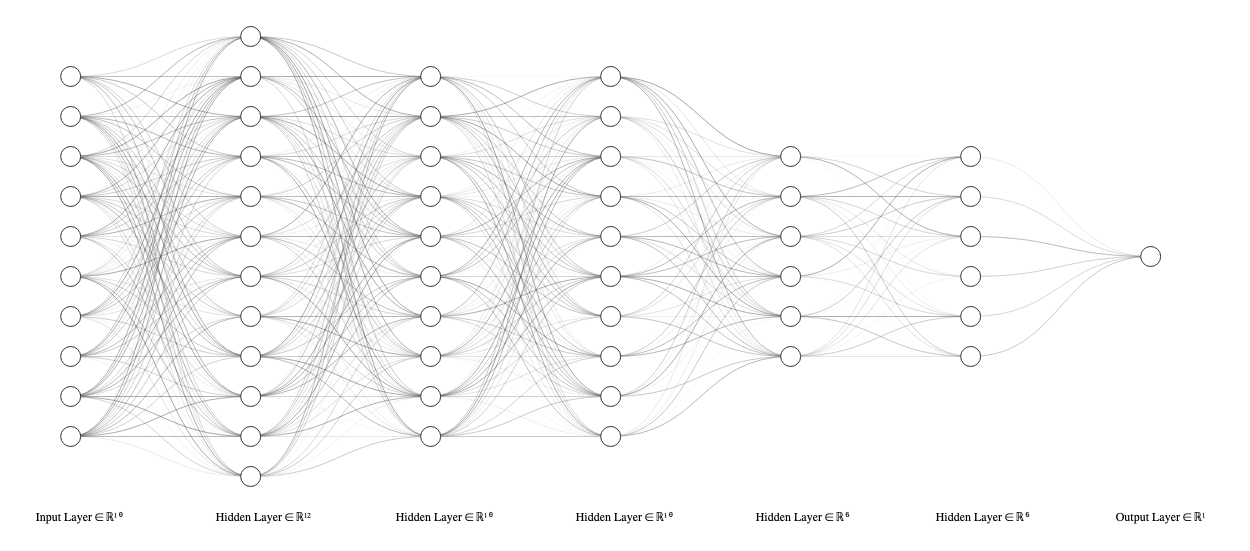
Propagation avant avec biais
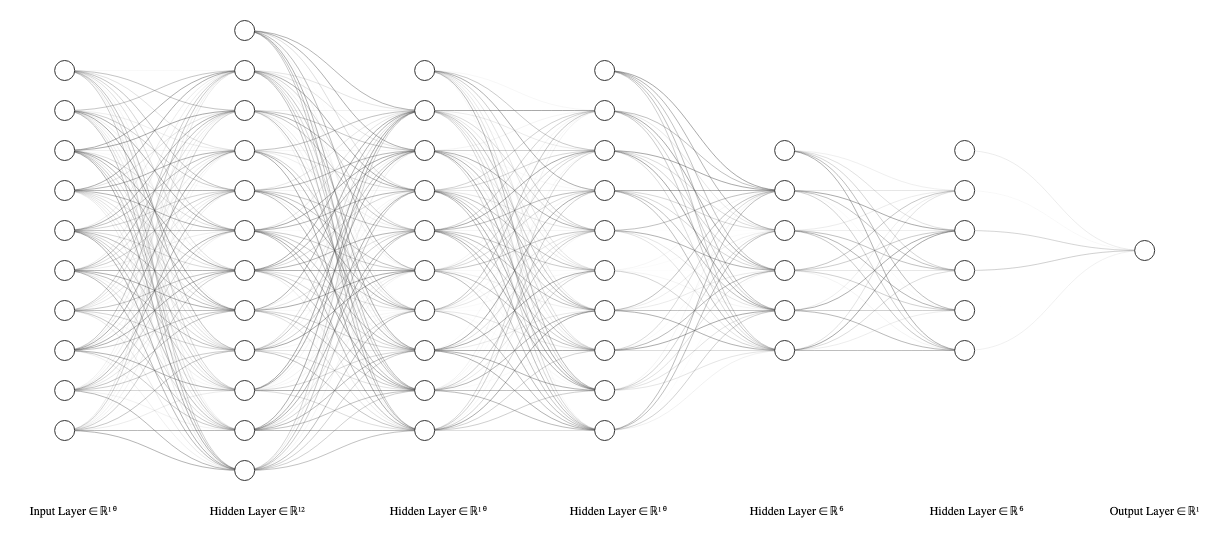
Pourquoi des activations non linéaires?
- Les couches cachées transforment leurs entrées en représentations intermédiaires.
- Sans activation non linéaire entre les couches, leur composition reste une seule transformation affine.
- Les activations non linéaires permettent au réseau de représenter des relations plus complexes entre les entrées et les sorties.
Activations et entraînement
- La rétropropagation (backpropagation) calcule les gradients; un optimiseur les utilise pour mettre à jour les paramètres.
- Les dérivées d’une fonction de seuil discontinue ne fournissent pas de signal utile pour l’entraînement usuel par gradient.
- Les réseaux modernes utilisent des activations comme la sigmoïde, tanh et ReLU.
Sigmoïde
\sigma(z)=\frac{1}{1+e^{-z}}
Ensemble des valeurs de sortie : (0,1).
Code
import matplotlib.pyplot as plt


def relu(z):
    return np.maximum(0, z)


def plot_activation(activation, name, output_limits):
    z = np.linspace(-6, 6, 400)
    fig, ax = plt.subplots(figsize=(5, 3.5))
    ax.plot(z, activation(z), color="black", linewidth=2)
    ax.set(xlabel="$z$", ylabel="Sortie", title=name, ylim=output_limits)
    ax.grid(True)
    fig.patch.set_alpha(0)
    plt.show()


plot_activation(sigmoid, "Sigmoïde", (-0.1, 1.1))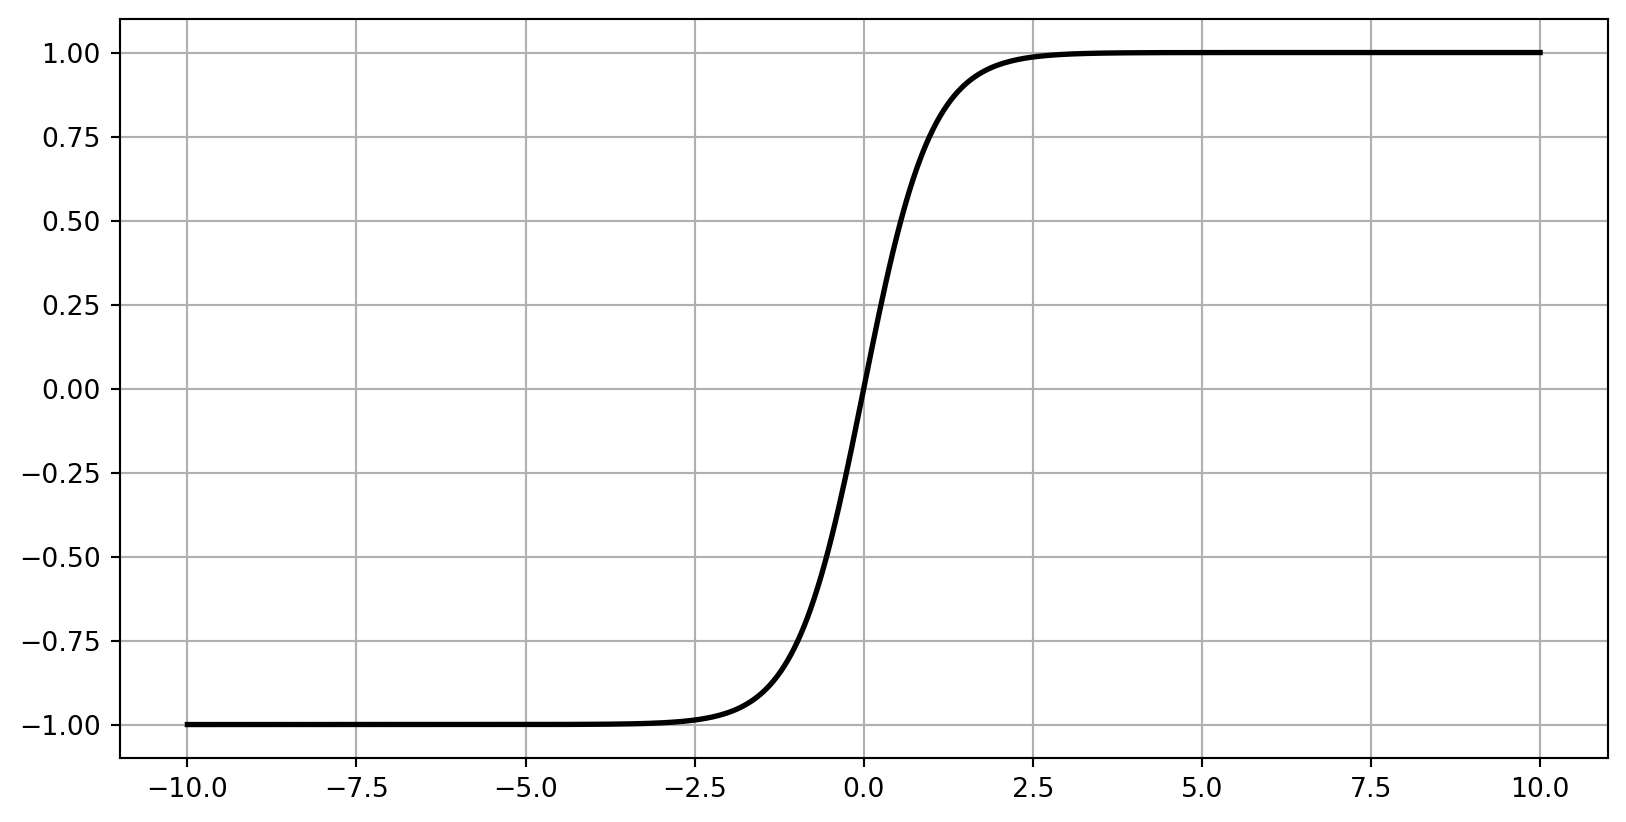
Tangente hyperbolique (tanh)
\tanh(z)=2\sigma(2z)-1
Ensemble des valeurs de sortie : (-1,1).
Unité linéaire rectifiée (ReLU)
\operatorname{ReLU}(z)=\max(0,z)
Ensemble des valeurs de sortie : [0,\infty).
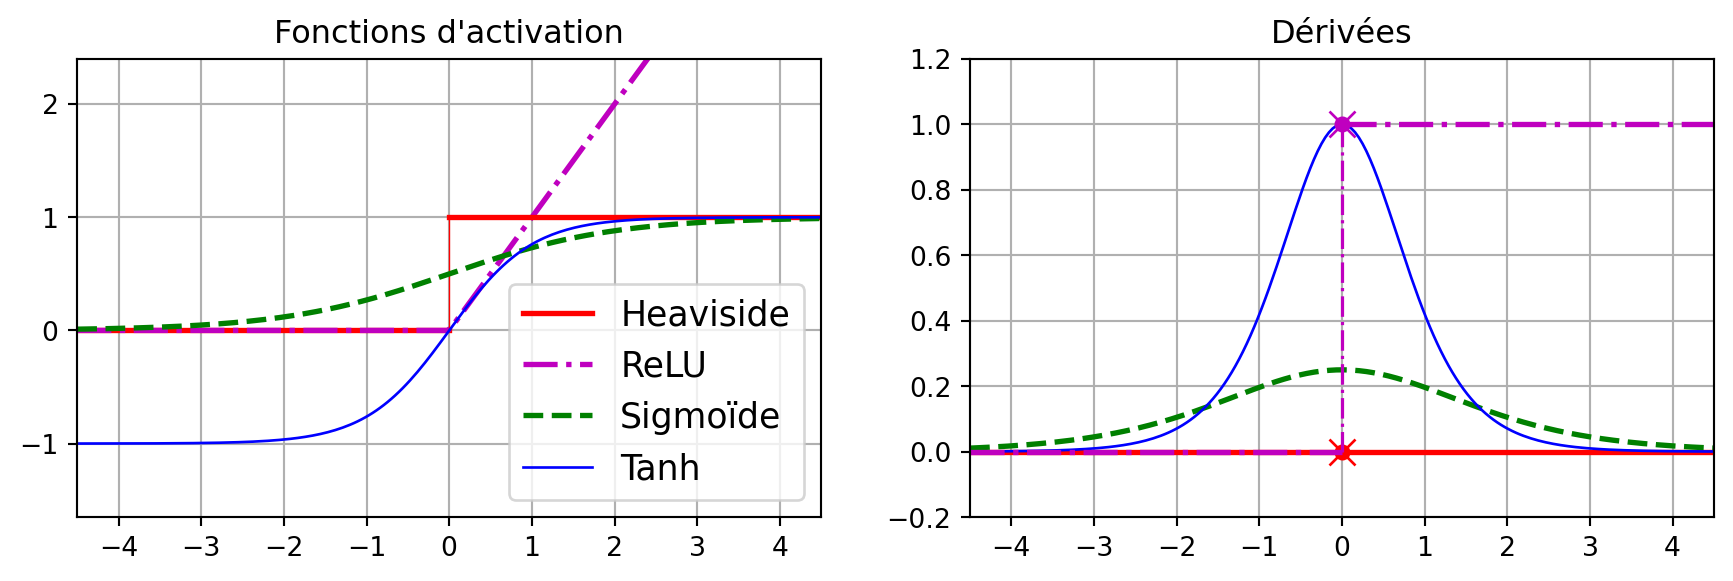
Comparaison des fonctions d’activation
Code
z = np.linspace(-4, 4, 401)
fig, ax = plt.subplots(figsize=(7, 4))
ax.step(z, (z >= 0).astype(int), where="post", label="Seuil")
ax.plot(z, sigmoid(z), label="Sigmoïde")
ax.plot(z, np.tanh(z), label="Tanh")
ax.plot(z, relu(z), label="ReLU")
ax.set(xlabel="$z$", ylabel="Sortie", ylim=(-1.2, 4.2))
ax.grid(True)
ax.legend()
plt.show()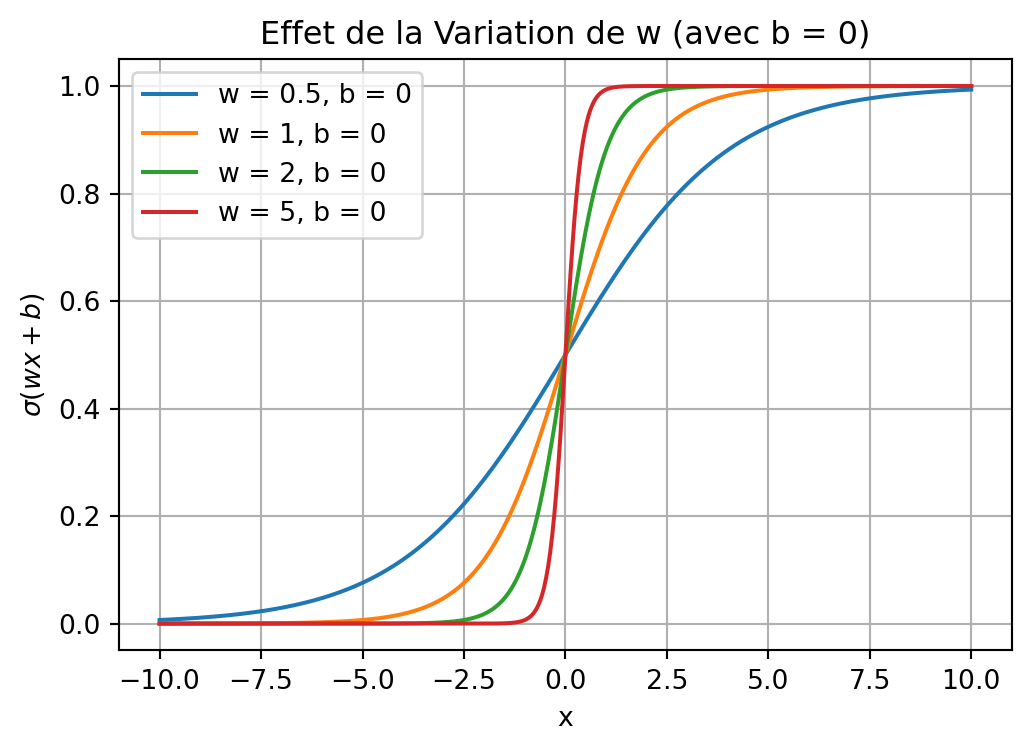
Approximation universelle
Définition
Le théorème d’approximation universelle (universal approximation theorem, UAT) établit que, sur un domaine d’entrée compact, un réseau ayant une seule couche cachée suffisamment large, des activations sigmoïdes et une sortie linéaire peut approximer toute fonction cible continue donnée avec la précision souhaitée.
Effet de w : sigmoïde
Code
def plot_parameter_effect(activation, name, weights, biases, title):
    x = np.linspace(-10, 10, 400)
    fig, ax = plt.subplots(figsize=(6, 4))
    for w in weights:
        for b in biases:
            ax.plot(x, activation(w * x + b), label=f"w = {w}, b = {b}")
    ax.set(xlabel="$x$", ylabel=f"{name}(wx + b)", title=title)
    ax.grid(True)
    ax.legend()
    plt.show()


plot_parameter_effect(sigmoid, "Sigmoïde", weights=[0.5, 1, 2, 5], biases=[0],
                      title="Variation de w, avec b = 0")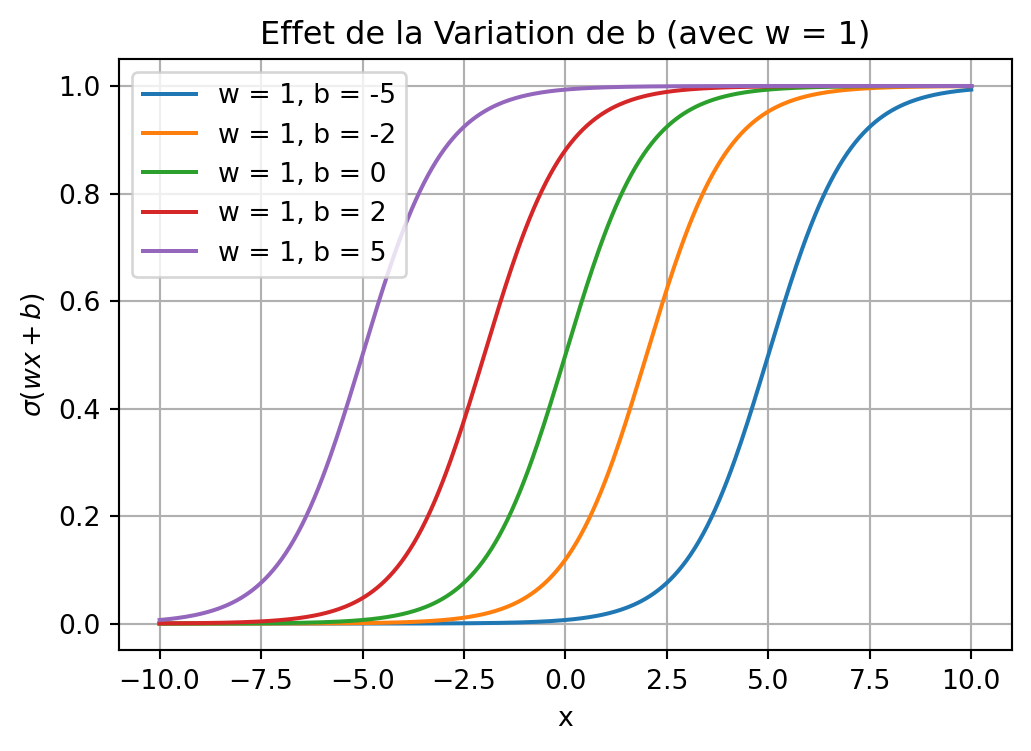
Effet de b : sigmoïde
Effet de w : ReLU
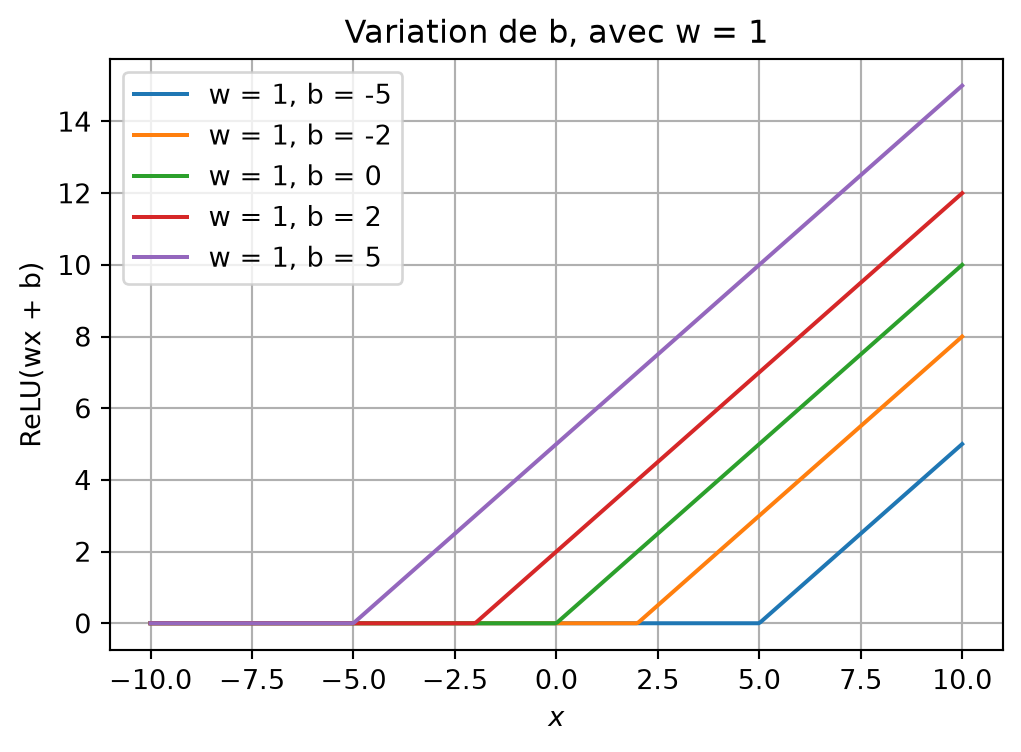
Effet de b : ReLU
Démonstration par le code
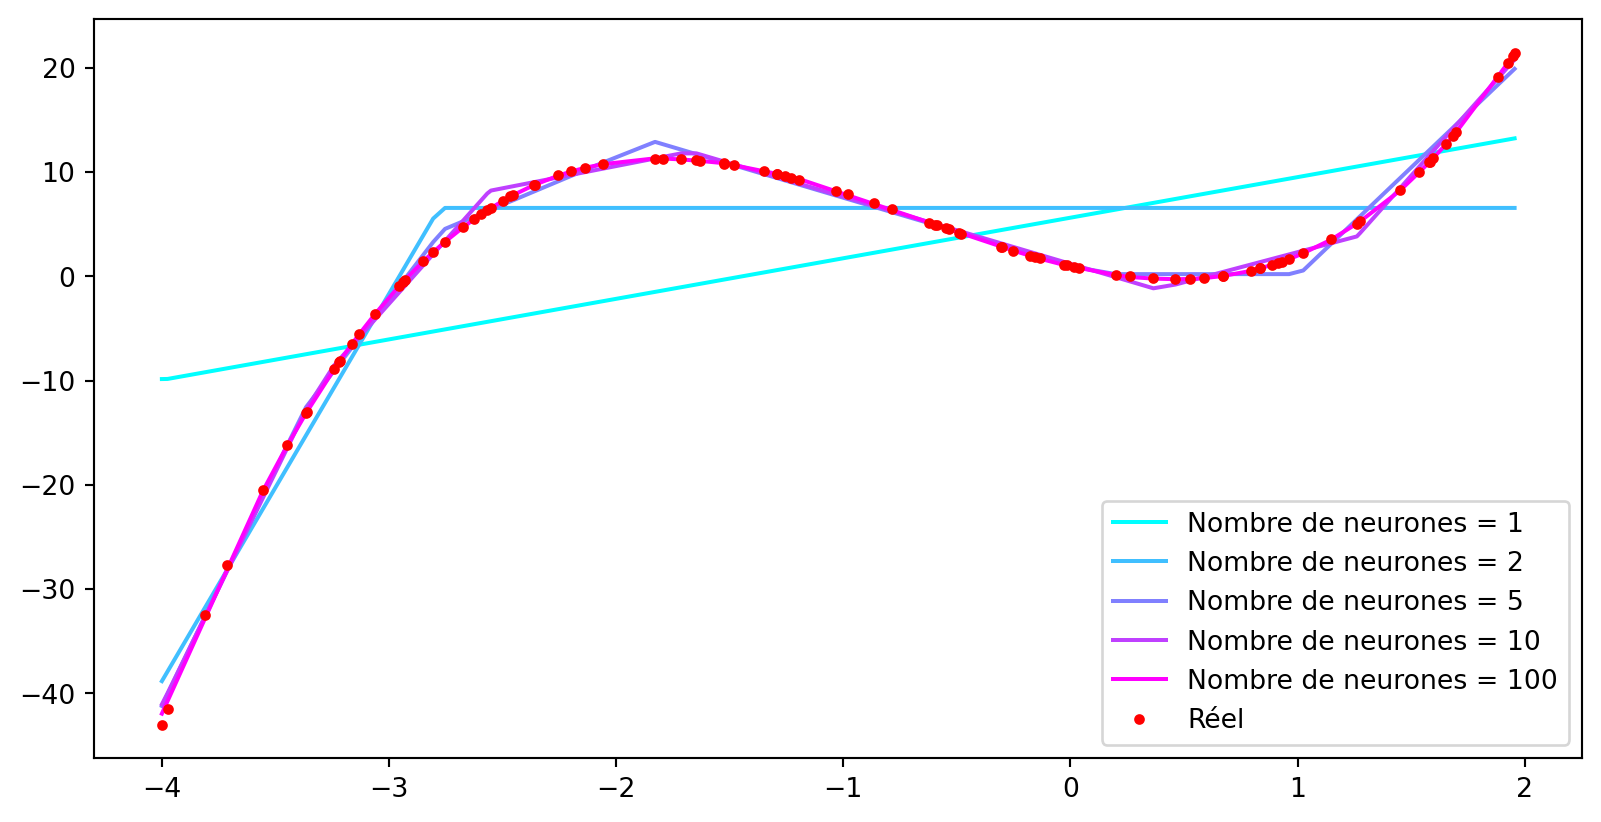
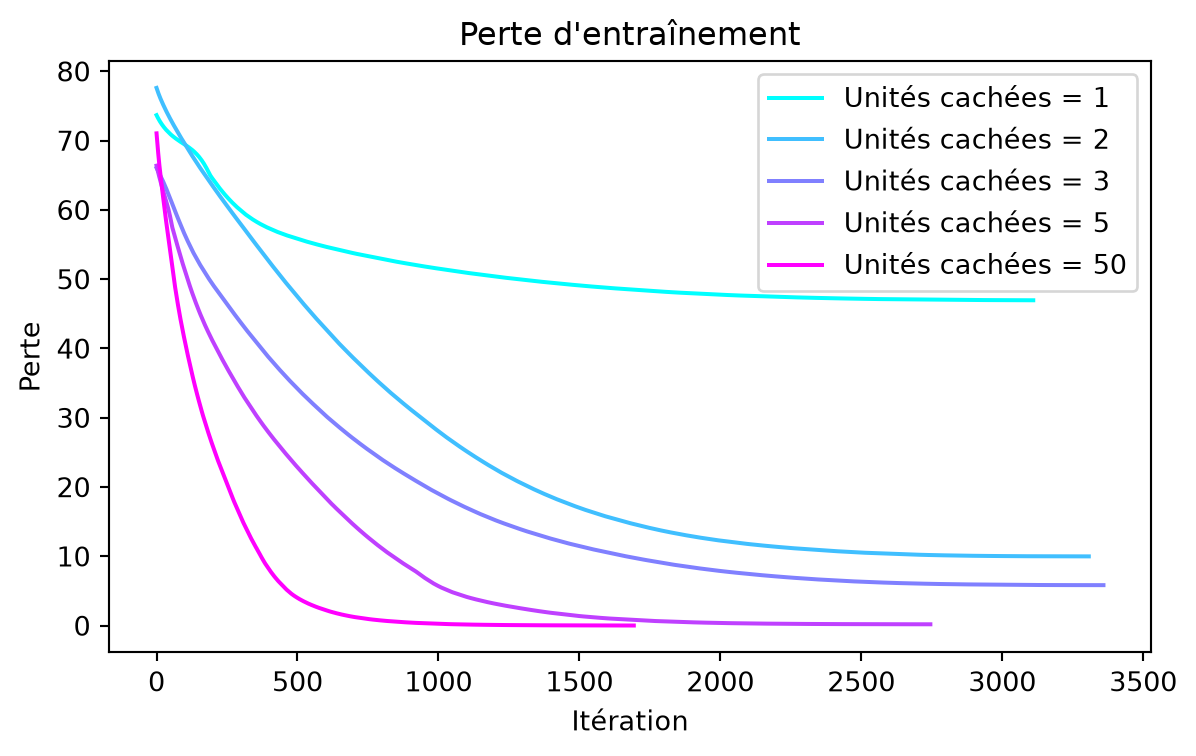
Approximer la même courbe cible avec des réseaux ayant des nombres différents d’unités cachées.
Augmenter le nombre de neurones
from sklearn.neural_network import MLPRegressor
from sklearn.model_selection import train_test_split

X_train, X_valid, y_train, y_valid = train_test_split(
    X, y, test_size=0.1, random_state=42
)

models = []

sizes = [1, 2, 3, 5, 50]

for n in sizes:
    regressor = MLPRegressor(
        hidden_layer_sizes=(n,), max_iter=5000, random_state=42
    )
    regressor.fit(X_train, y_train)
models.append(regressor) Comparaison des courbes ajustées
Code
colors = plt.colormaps["cool"].resampled(len(sizes))
plot_inputs = np.sort(X_valid, axis=0)

fig, ax = plt.subplots(figsize=(7, 4))
for i, n in enumerate(sizes):
    predictions = models[i].predict(plot_inputs)
    ax.plot(plot_inputs, predictions, color=colors(i),
            label=f"Unités cachées = {n}")
ax.plot(plot_inputs, f(plot_inputs), "r.", label="Cible")
ax.set(xlabel="$x$", ylabel="Sortie")
ax.legend()
plt.show()
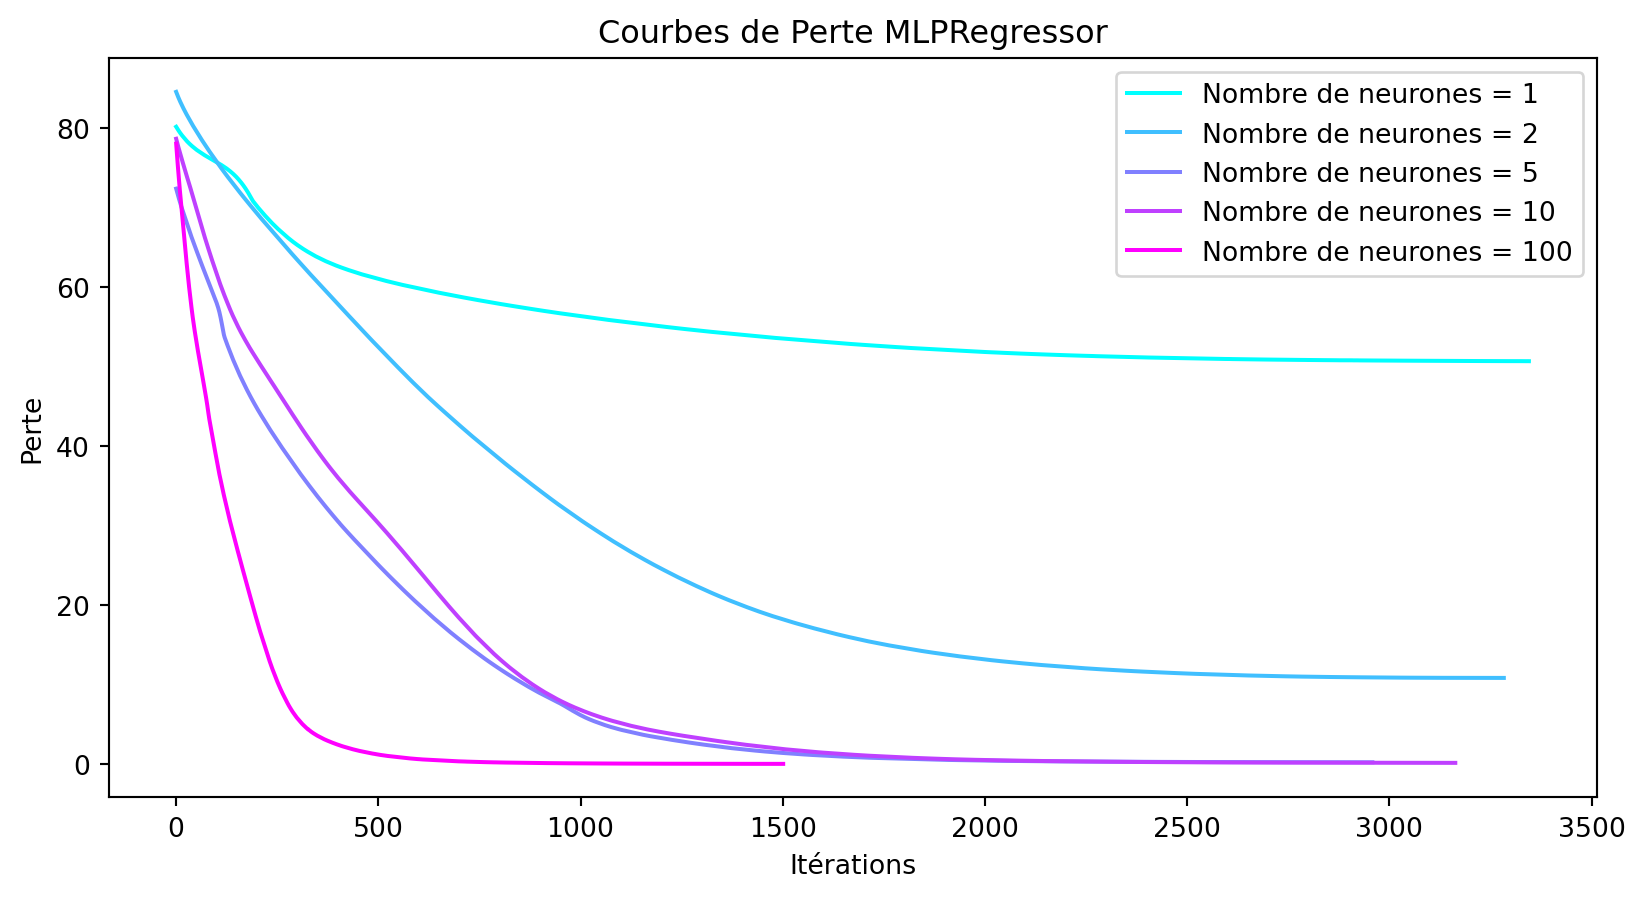
Comparaison des pertes d’entraînement
Approximation universelle
Codons
Bibliothèques et environnements
PyTorch, TensorFlow et JAX fournissent des outils de calcul numérique et de différentiation automatique.
Keras fournit une API de haut niveau pour construire et entraîner des modèles avec ces moteurs de calcul (backends).
Keras
Les principales étapes sont :
- Définir les couches du réseau.
- Compiler avec une perte, un optimiseur et des métriques d’évaluation.
- Ajuster le modèle aux données d’entraînement et suivre ses performances sur l’ensemble de validation.
- Évaluer le modèle sur l’ensemble de test et produire des prédictions.
Jeu de données Fashion-MNIST
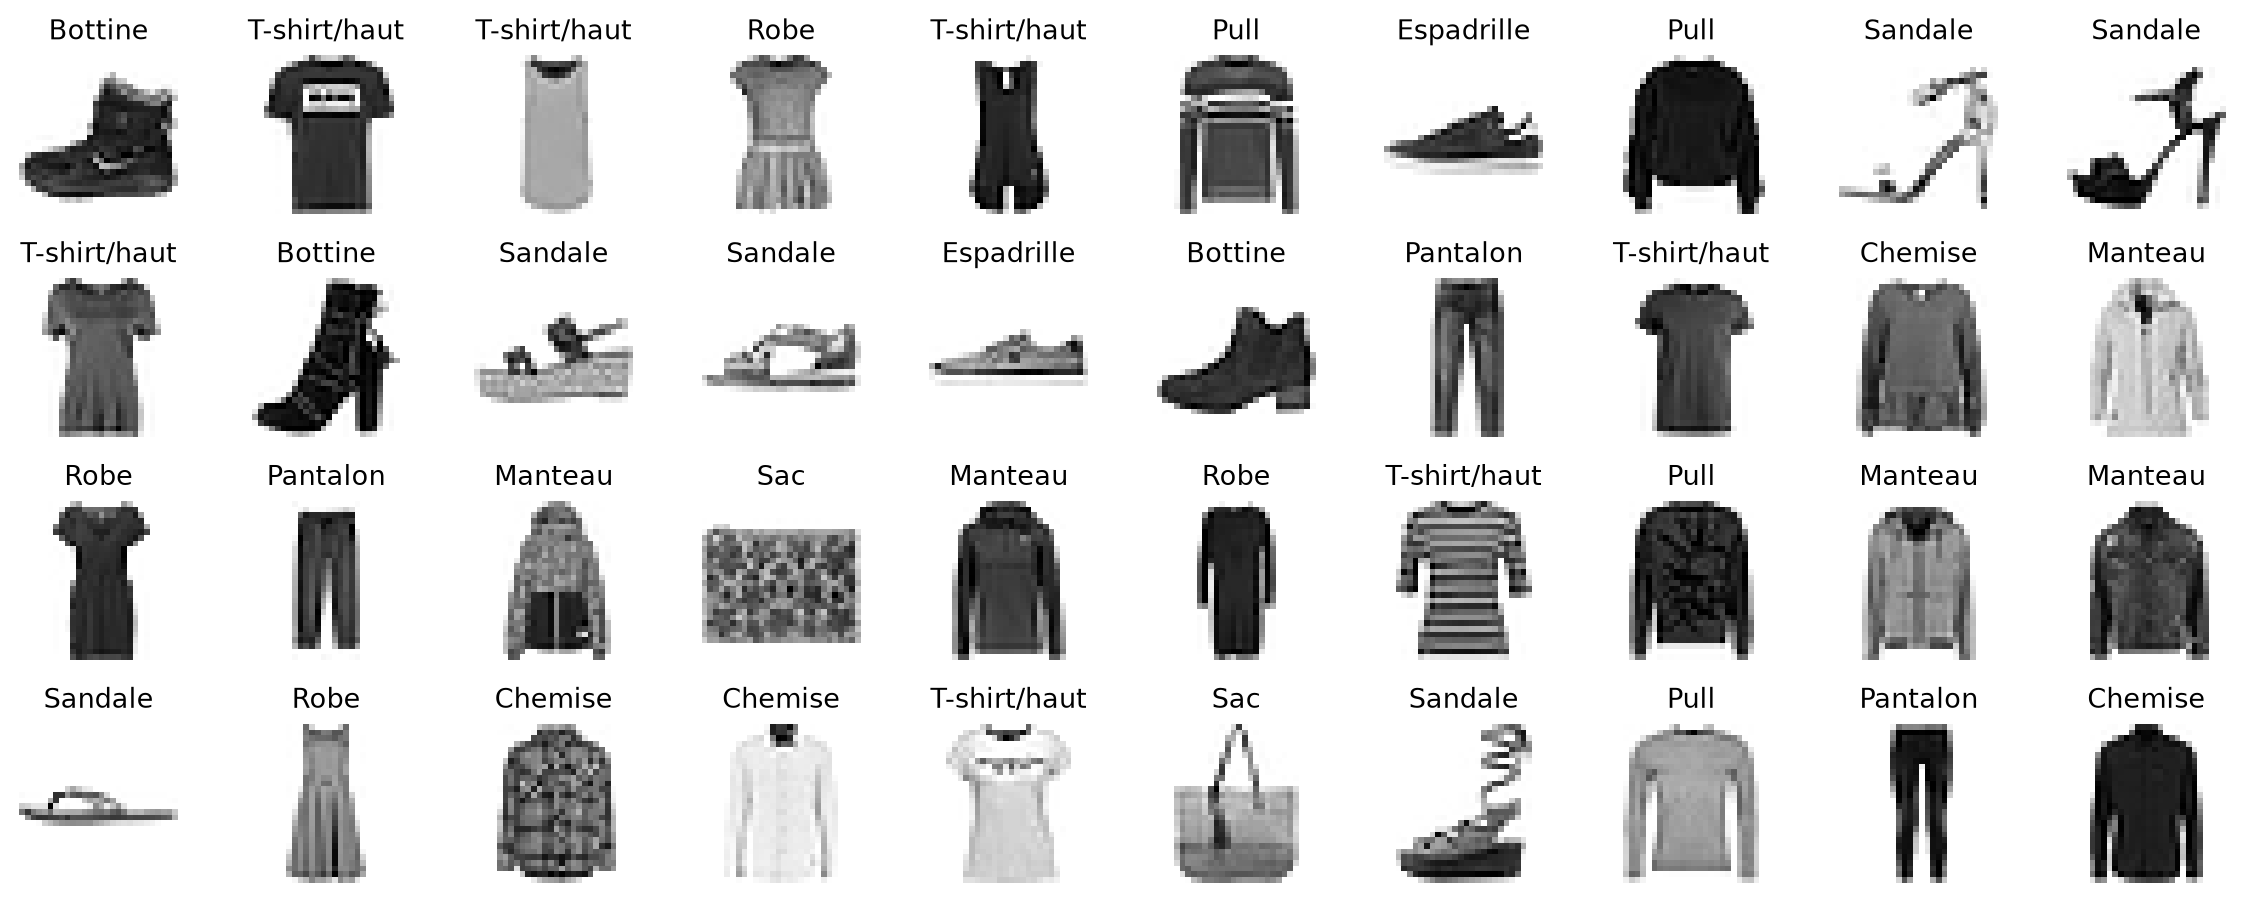
Fashion-MNIST contient des images de vêtements et d’accessoires :
- 60 000 images d’entraînement et 10 000 images de test.
- Chaque image comporte 28 × 28 pixels en niveaux de gris.
- Chaque image possède une étiquette entière, parmi 10 classes.
Chargement et partitionnement
Inspection et mise à l’échelle des entrées
Images et étiquettes
Les 40 premières images
Création d’un modèle
Structure du modèle et paramètres
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ flatten (Flatten)               │ (None, 784)            │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense (Dense)                   │ (None, 300)            │       235,500 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 100)            │        30,100 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_2 (Dense)                 │ (None, 10)             │         1,010 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
Total params: 266,610 (1.02 MB)
Trainable params: 266,610 (1.02 MB)
Non-trainable params: 0 (0.00 B)
Compilation du modèle
Entraînement du modèle
Epoch 1/30
1719/1719 - 1s - 825us/step - accuracy: 0.7616 - loss: 0.7239 - val_accuracy: 0.8298 - val_loss: 0.5026
Epoch 2/30
1719/1719 - 1s - 669us/step - accuracy: 0.8299 - loss: 0.4894 - val_accuracy: 0.8418 - val_loss: 0.4472
Epoch 3/30
1719/1719 - 1s - 685us/step - accuracy: 0.8448 - loss: 0.4434 - val_accuracy: 0.8480 - val_loss: 0.4233
Epoch 4/30
1719/1719 - 1s - 682us/step - accuracy: 0.8548 - loss: 0.4154 - val_accuracy: 0.8550 - val_loss: 0.4088
Epoch 5/30
1719/1719 - 1s - 673us/step - accuracy: 0.8607 - loss: 0.3951 - val_accuracy: 0.8584 - val_loss: 0.3970
Epoch 6/30
1719/1719 - 1s - 665us/step - accuracy: 0.8667 - loss: 0.3790 - val_accuracy: 0.8594 - val_loss: 0.3889
Epoch 7/30
1719/1719 - 1s - 673us/step - accuracy: 0.8713 - loss: 0.3656 - val_accuracy: 0.8616 - val_loss: 0.3824
Epoch 8/30
1719/1719 - 1s - 677us/step - accuracy: 0.8748 - loss: 0.3539 - val_accuracy: 0.8642 - val_loss: 0.3780
Epoch 9/30
1719/1719 - 1s - 680us/step - accuracy: 0.8783 - loss: 0.3432 - val_accuracy: 0.8666 - val_loss: 0.3740
Epoch 10/30
1719/1719 - 1s - 690us/step - accuracy: 0.8817 - loss: 0.3336 - val_accuracy: 0.8678 - val_loss: 0.3684
Epoch 11/30
1719/1719 - 1s - 674us/step - accuracy: 0.8851 - loss: 0.3247 - val_accuracy: 0.8702 - val_loss: 0.3641
Epoch 12/30
1719/1719 - 1s - 678us/step - accuracy: 0.8875 - loss: 0.3165 - val_accuracy: 0.8726 - val_loss: 0.3601
Epoch 13/30
1719/1719 - 1s - 664us/step - accuracy: 0.8898 - loss: 0.3089 - val_accuracy: 0.8736 - val_loss: 0.3578
Epoch 14/30
1719/1719 - 1s - 670us/step - accuracy: 0.8922 - loss: 0.3017 - val_accuracy: 0.8724 - val_loss: 0.3554
Epoch 15/30
1719/1719 - 1s - 667us/step - accuracy: 0.8942 - loss: 0.2951 - val_accuracy: 0.8736 - val_loss: 0.3543
Epoch 16/30
1719/1719 - 1s - 667us/step - accuracy: 0.8962 - loss: 0.2887 - val_accuracy: 0.8734 - val_loss: 0.3520
Epoch 17/30
1719/1719 - 1s - 674us/step - accuracy: 0.8983 - loss: 0.2829 - val_accuracy: 0.8738 - val_loss: 0.3522
Epoch 18/30
1719/1719 - 1s - 692us/step - accuracy: 0.9002 - loss: 0.2771 - val_accuracy: 0.8746 - val_loss: 0.3495
Epoch 19/30
1719/1719 - 1s - 684us/step - accuracy: 0.9021 - loss: 0.2717 - val_accuracy: 0.8758 - val_loss: 0.3478
Epoch 20/30
1719/1719 - 1s - 697us/step - accuracy: 0.9043 - loss: 0.2664 - val_accuracy: 0.8760 - val_loss: 0.3465
Epoch 21/30
1719/1719 - 1s - 665us/step - accuracy: 0.9060 - loss: 0.2615 - val_accuracy: 0.8754 - val_loss: 0.3465
Epoch 22/30
1719/1719 - 1s - 669us/step - accuracy: 0.9081 - loss: 0.2565 - val_accuracy: 0.8772 - val_loss: 0.3449
Epoch 23/30
1719/1719 - 1s - 686us/step - accuracy: 0.9102 - loss: 0.2519 - val_accuracy: 0.8782 - val_loss: 0.3454
Epoch 24/30
1719/1719 - 1s - 666us/step - accuracy: 0.9121 - loss: 0.2471 - val_accuracy: 0.8780 - val_loss: 0.3445
Epoch 25/30
1719/1719 - 1s - 678us/step - accuracy: 0.9145 - loss: 0.2427 - val_accuracy: 0.8790 - val_loss: 0.3437
Epoch 26/30
1719/1719 - 1s - 666us/step - accuracy: 0.9158 - loss: 0.2384 - val_accuracy: 0.8792 - val_loss: 0.3446
Epoch 27/30
1719/1719 - 1s - 662us/step - accuracy: 0.9172 - loss: 0.2341 - val_accuracy: 0.8810 - val_loss: 0.3445
Epoch 28/30
1719/1719 - 1s - 664us/step - accuracy: 0.9193 - loss: 0.2299 - val_accuracy: 0.8804 - val_loss: 0.3441
Epoch 29/30
1719/1719 - 1s - 677us/step - accuracy: 0.9210 - loss: 0.2260 - val_accuracy: 0.8808 - val_loss: 0.3445
Epoch 30/30
1719/1719 - 1s - 679us/step - accuracy: 0.9223 - loss: 0.2220 - val_accuracy: 0.8800 - val_loss: 0.3440Courbes d’entraînement et de validation
Code
epochs = np.arange(1, len(history.history["loss"]) + 1)
fig, axes = plt.subplots(1, 2, figsize=(9, 3.5))
for ax, metric, title in zip(
    axes, ["loss", "accuracy"], ["Perte", "Exactitude"]
):
    ax.plot(epochs, history.history[metric], label="Entraînement")
    ax.plot(epochs, history.history[f"val_{metric}"], label="Validation")
    ax.set(xlabel="Époque", ylabel=title)
    ax.grid(True)
    ax.legend()
axes[1].set_ylim(0, 1)
plt.tight_layout()
plt.show()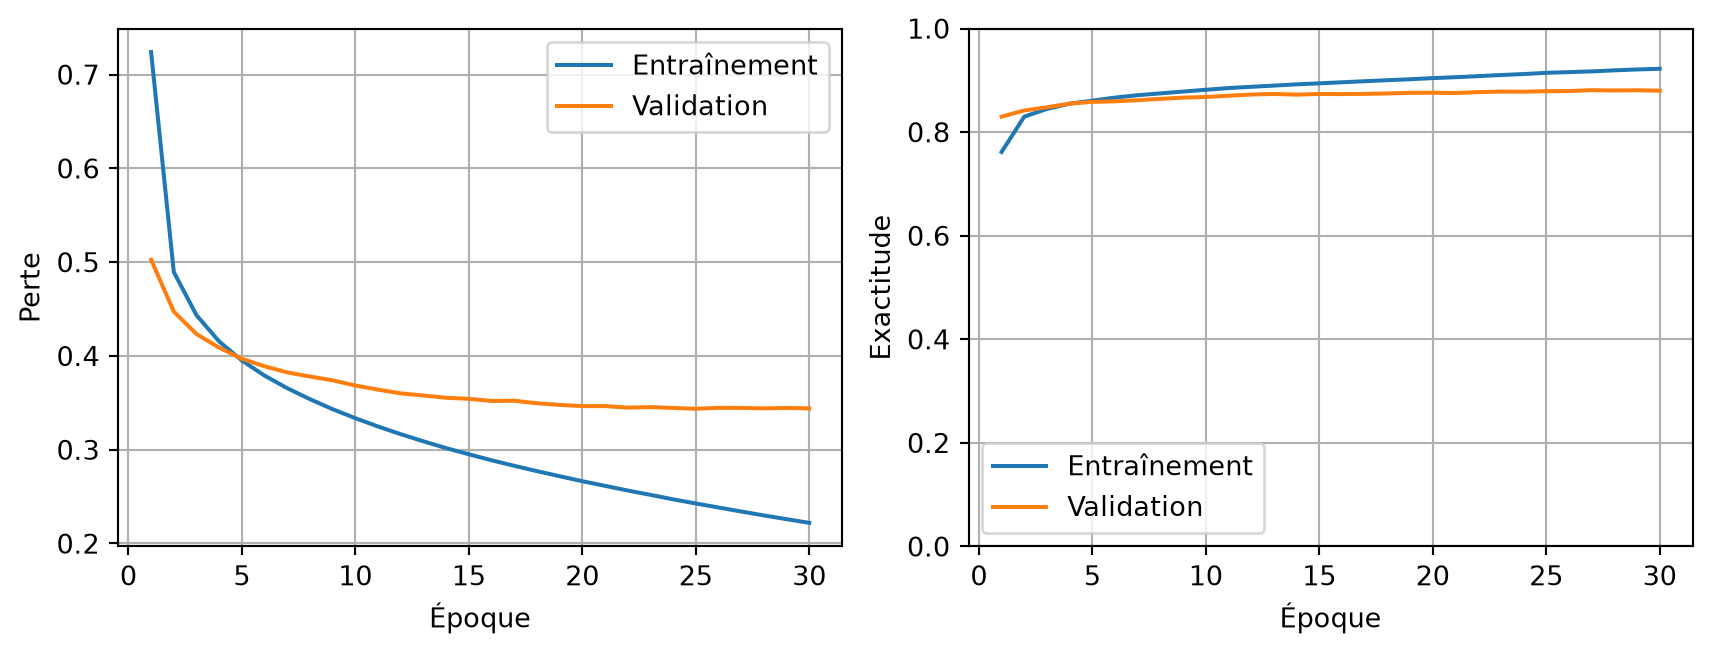
Évaluation finale sur l’ensemble de test
Faire des prédictions
array([[0.  , 0.  , 0.  , 0.  , 0.  , 0.33, 0.  , 0.01, 0.  , 0.65],
       [0.  , 0.  , 1.  , 0.  , 0.  , 0.  , 0.  , 0.  , 0.  , 0.  ],
       [0.  , 1.  , 0.  , 0.  , 0.  , 0.  , 0.  , 0.  , 0.  , 0.  ]],
dtype=float32)Étiquettes prédites et observées
Code
fig, axes = plt.subplots(1, 3, figsize=(8, 3))
for ax, image, prediction, observed in zip(axes, X_new, y_pred, y_observed):
    ax.imshow(image, cmap="binary", interpolation="nearest")
    ax.set_title(f"Prédit : {class_names[prediction]}\n"
                 f"Observé : {class_names[observed]}", fontsize=10)
    ax.axis("off")
plt.tight_layout()
plt.show()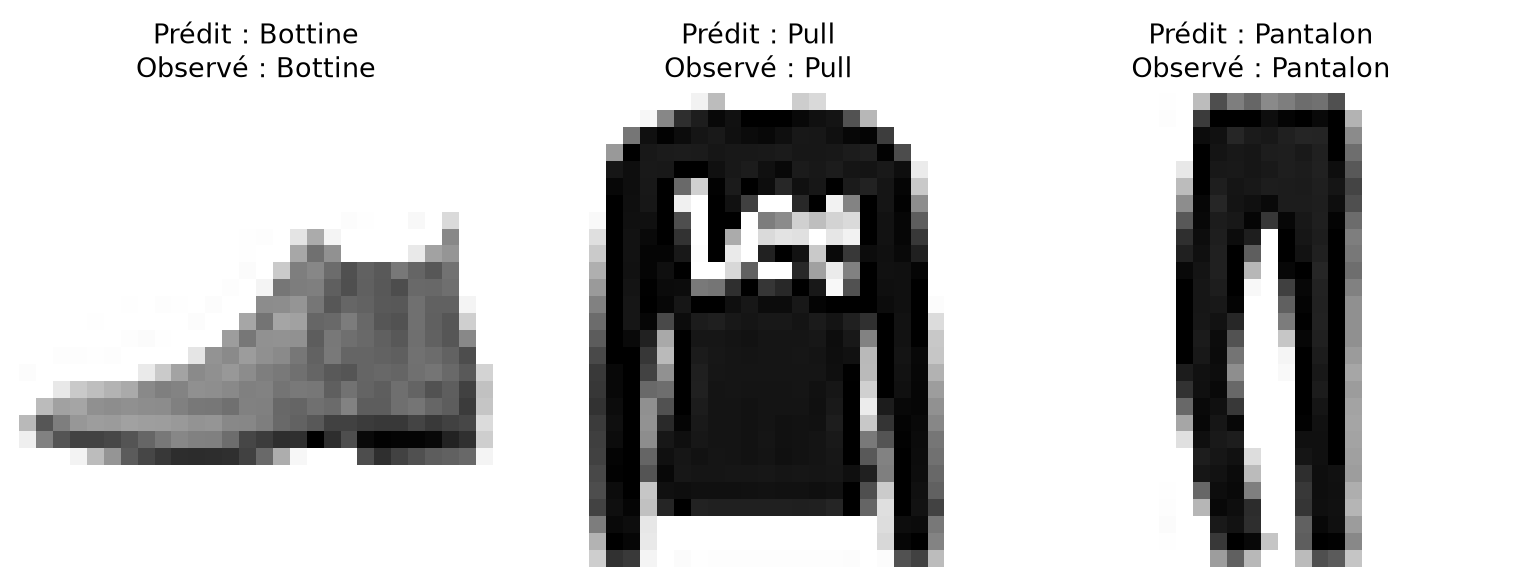
Performances par classe
              precision    recall  f1-score   support

T-shirt/haut      0.842     0.810     0.826      1000
    Pantalon      0.992     0.964     0.978      1000
        Pull      0.744     0.850     0.793      1000
        Robe      0.824     0.929     0.873      1000
     Manteau      0.806     0.794     0.800      1000
     Sandale      0.885     0.986     0.933      1000
     Chemise      0.777     0.618     0.689      1000
  Espadrille      0.944     0.911     0.927      1000
         Sac      0.961     0.963     0.962      1000
     Bottine      0.983     0.918     0.949      1000

    accuracy                          0.874     10000
   macro avg      0.876     0.874     0.873     10000
weighted avg      0.876     0.874     0.873     10000
Conclusion
Résumé
- Calcul : la propagation avant associe des sorties aux entrées à l’aide des poids, des biais et des activations.
- Représentation : des couches cachées non linéaires calculent des attributs intermédiaires qui peuvent rendre XOR séparable.
- Apprentissage : l’entraînement ajuste les paramètres; la rétropropagation calcule les gradients utilisés par un optimiseur.
- Approximation universelle : des paramètres appropriés peuvent exister sans garantie que l’entraînement les trouvera.
- Implémentation : Keras relie ces idées dans une procédure complète de classification sur Fashion-MNIST.
- Évaluation : appliquer un prétraitement cohérent et distinguer les performances d’entraînement, de validation et de test.
3Blue1Brown sur l’apprentissage profond
- But what is a Neural Network?
- youtu.be/aircAruvnKk (19 minutes)
- Gradient descent, how neural networks learn?
- youtu.be/IHZwWFHWa-w (21 minutes)
- What is backpropagation really doing?
- youtu.be/Ilg3gGewQ5U (14 minutes)
- Backpropagation calculus
- youtu.be/tIeHLnjs5U8 (10 minutes)
Prochaine présentation
- Nous examinerons l’implémentation d’un réseaux de neurones artificiels.
Références
Marcel Turcotte
École de science informatique et de génie électrique (SIGE)
Université d’Ottawa