Entraîner un réseau de neurones artificiels (partie 1)

CSI 4506 - automne 2026

Marcel Turcotte

Version : 27 oct. 2026 10h55

Préambule

Message du jour

Objectifs d’apprentissage

  • Suivre les calculs d’un réseau à propagation avant dans son implémentation NumPy.
  • Distinguer les probabilités prédites, les étiquettes de classe et la perte d’entraînement.
  • Expliquer comment un algorithme naïf essaie des modifications de paramètres et applique des mises à jour simultanées.
  • Identifier les limites de calcul qui motivent l’introduction de la rétropropagation.

MLP naïf

Données

Afficher le code
# Générer et tracer le jeu de données circulaire
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# Générer des données synthétiques
X, y = make_circles(n_samples=1200, factor=0.35, noise=0.06, random_state=42)

# Séparer les coordonnées pour le tracé
x1, x2 = X[:, 0], X[:, 1]

# Tracer les deux classes
plt.figure(figsize=(5, 5))
plt.scatter(x1[y==0], x2[y==0], color="C0", label="classe 0 (anneau extérieur)")
plt.scatter(x1[y==1], x2[y==1], color="C1", label="classe 1 (cercle intérieur)")
plt.xlabel("x₁")
plt.ylabel("x₂")
plt.title("Jeu de données généré avec make_circles")
plt.axis("equal") # conserver les proportions des cercles
plt.legend()
plt.show()

Architecture

Fonctions utilitaires

def sigmoid(z):
    return 1.0 / (1.0 + np.exp(-z))

def bce_loss(y_true, y_prob, eps=1e-9):

    """Perte d'entropie croisée binaire (moyenne sur les données)."""

    y_prob = np.clip(y_prob, eps, 1 - eps)

    return -np.mean(y_true * np.log(y_prob) + (1 - y_true) * np.log(1 - y_prob))

NaiveMLP

L’implémentation complète est présentée ci-dessous; les diapositives suivantes en examinent les différentes parties.

Afficher le code
class NaiveMLP:

    """
    Un MLP minimal pour la classification binaire, entraîné par un algorithme
    naïf sans dérivées qui applique les mises à jour simultanément.

    Cette méthode volontairement simple illustre le processus d'entraînement
    et son coût de calcul avant l'introduction de la rétropropagation.
    """

    def __init__(self, layer_sizes, step=0.1, seed=None):
        
        self.sizes = list(layer_sizes)
        self.step = float(step)
        rng = np.random.default_rng(seed)

        # Initialiser les poids et les biais

        self.W = [rng.standard_normal(size=(in_d, out_d)) * 0.5
                  for in_d, out_d in zip(layer_sizes[:-1], layer_sizes[1:])]

        self.b = [np.zeros(out_d) for out_d in layer_sizes[1:]]

    def forward(self, X):

        """
        Propagation avant simple : calculer uniquement les activations de sortie.

        X : dimensions (N, input_dim)

        Retour : probabilités de sortie, dimensions (N,)
        """

        a = X
        for W, b in zip(self.W, self.b):
            a = sigmoid(a @ W + b)

        return a.ravel()

    def predict(self, X, threshold=0.5):

        return (self.forward(X) >= threshold).astype(int)

    def loss(self, X, y):

        return bce_loss(y, self.forward(X))

    def _all_param_tags(self):

        """
        Produit des repères pour chaque paramètre scalaire :
        ('W', layer_idx, i, j) ou ('b', layer_idx, j)
        """

        for l, W in enumerate(self.W):
            for i in range(W.shape[0]):
                for j in range(W.shape[1]):
                    yield ('W', l, i, j)
            for j in range(self.b[l].shape[0]):
                yield ('b', l, j)

    def _get_param(self, tag):
        kind = tag[0]
        if kind == 'W':
            _, l, i, j = tag
            return self.W[l][i, j]
        else:
            _, l, j = tag
            return self.b[l][j]

    def _set_param(self, tag, val):
        kind = tag[0]
        if kind == 'W':
            _, l, i, j = tag
            self.W[l][i, j] = val
        else:
            _, l, j = tag
            self.b[l][j] = val

    def train(self, X, y, epochs=10, verbose=True):

        """
        Mise à jour simultanée :
        - Pour chaque paramètre scalaire θ, essayer θ + δ avec δ dans {−step, 0, +step},
          retenir le δ donnant la perte minimale.
        - Recueillir tous les δ retenus, puis appliquer toutes les mises à jour ensemble.
        """

        for ep in range(1, epochs + 1):

            base_loss = self.loss(X, y)
            updates = {}

            # Essayer des modifications de tous les paramètres
            for tag in self._all_param_tags():

                theta = self._get_param(tag)
                best_delta = 0.0
                best_loss = base_loss

                for delta in (-self.step, 0.0, +self.step):
                    self._set_param(tag, theta + delta)
                    trial_loss = self.loss(X, y)
                    if trial_loss < best_loss:
                        best_loss = trial_loss
                        best_delta = delta

                # rétablir la valeur d'origine
                self._set_param(tag, theta)
                updates[tag] = best_delta

            # Appliquer toutes les modifications ensemble
            for tag, d in updates.items():
                if d != 0.0:
                    self._set_param(tag, self._get_param(tag) + d)

            new_loss = self.loss(X, y)

            if verbose:
                print(f"Époque {ep:3d} : perte {base_loss:.5f} → {new_loss:.5f}")

            # arrêt anticipé facultatif
            if abs(new_loss - base_loss) < 1e-12:
                break

Définition de la classe

class NaiveMLP:

    """
    Un MLP minimal pour la classification binaire, entraîné par un algorithme
    naïf sans dérivées qui applique les mises à jour simultanément.

    Cette méthode volontairement simple illustre le processus d'entraînement
    et son coût de calcul avant l'introduction de la rétropropagation.
    """

Constructeur

    def __init__(self, layer_sizes, step=0.1, seed=None):
        
        self.sizes = list(layer_sizes)
        self.step = float(step)
        rng = np.random.default_rng(seed)

        # Initialiser les poids et les biais

        self.W = [rng.standard_normal(size=(in_d, out_d)) * 0.5
                  for in_d, out_d in zip(layer_sizes[:-1], layer_sizes[1:])]

        self.b = [np.zeros(out_d) for out_d in layer_sizes[1:]]

Paramètres

Détour Python : tableaux de poids

seed = 0

rng = np.random.default_rng(seed)

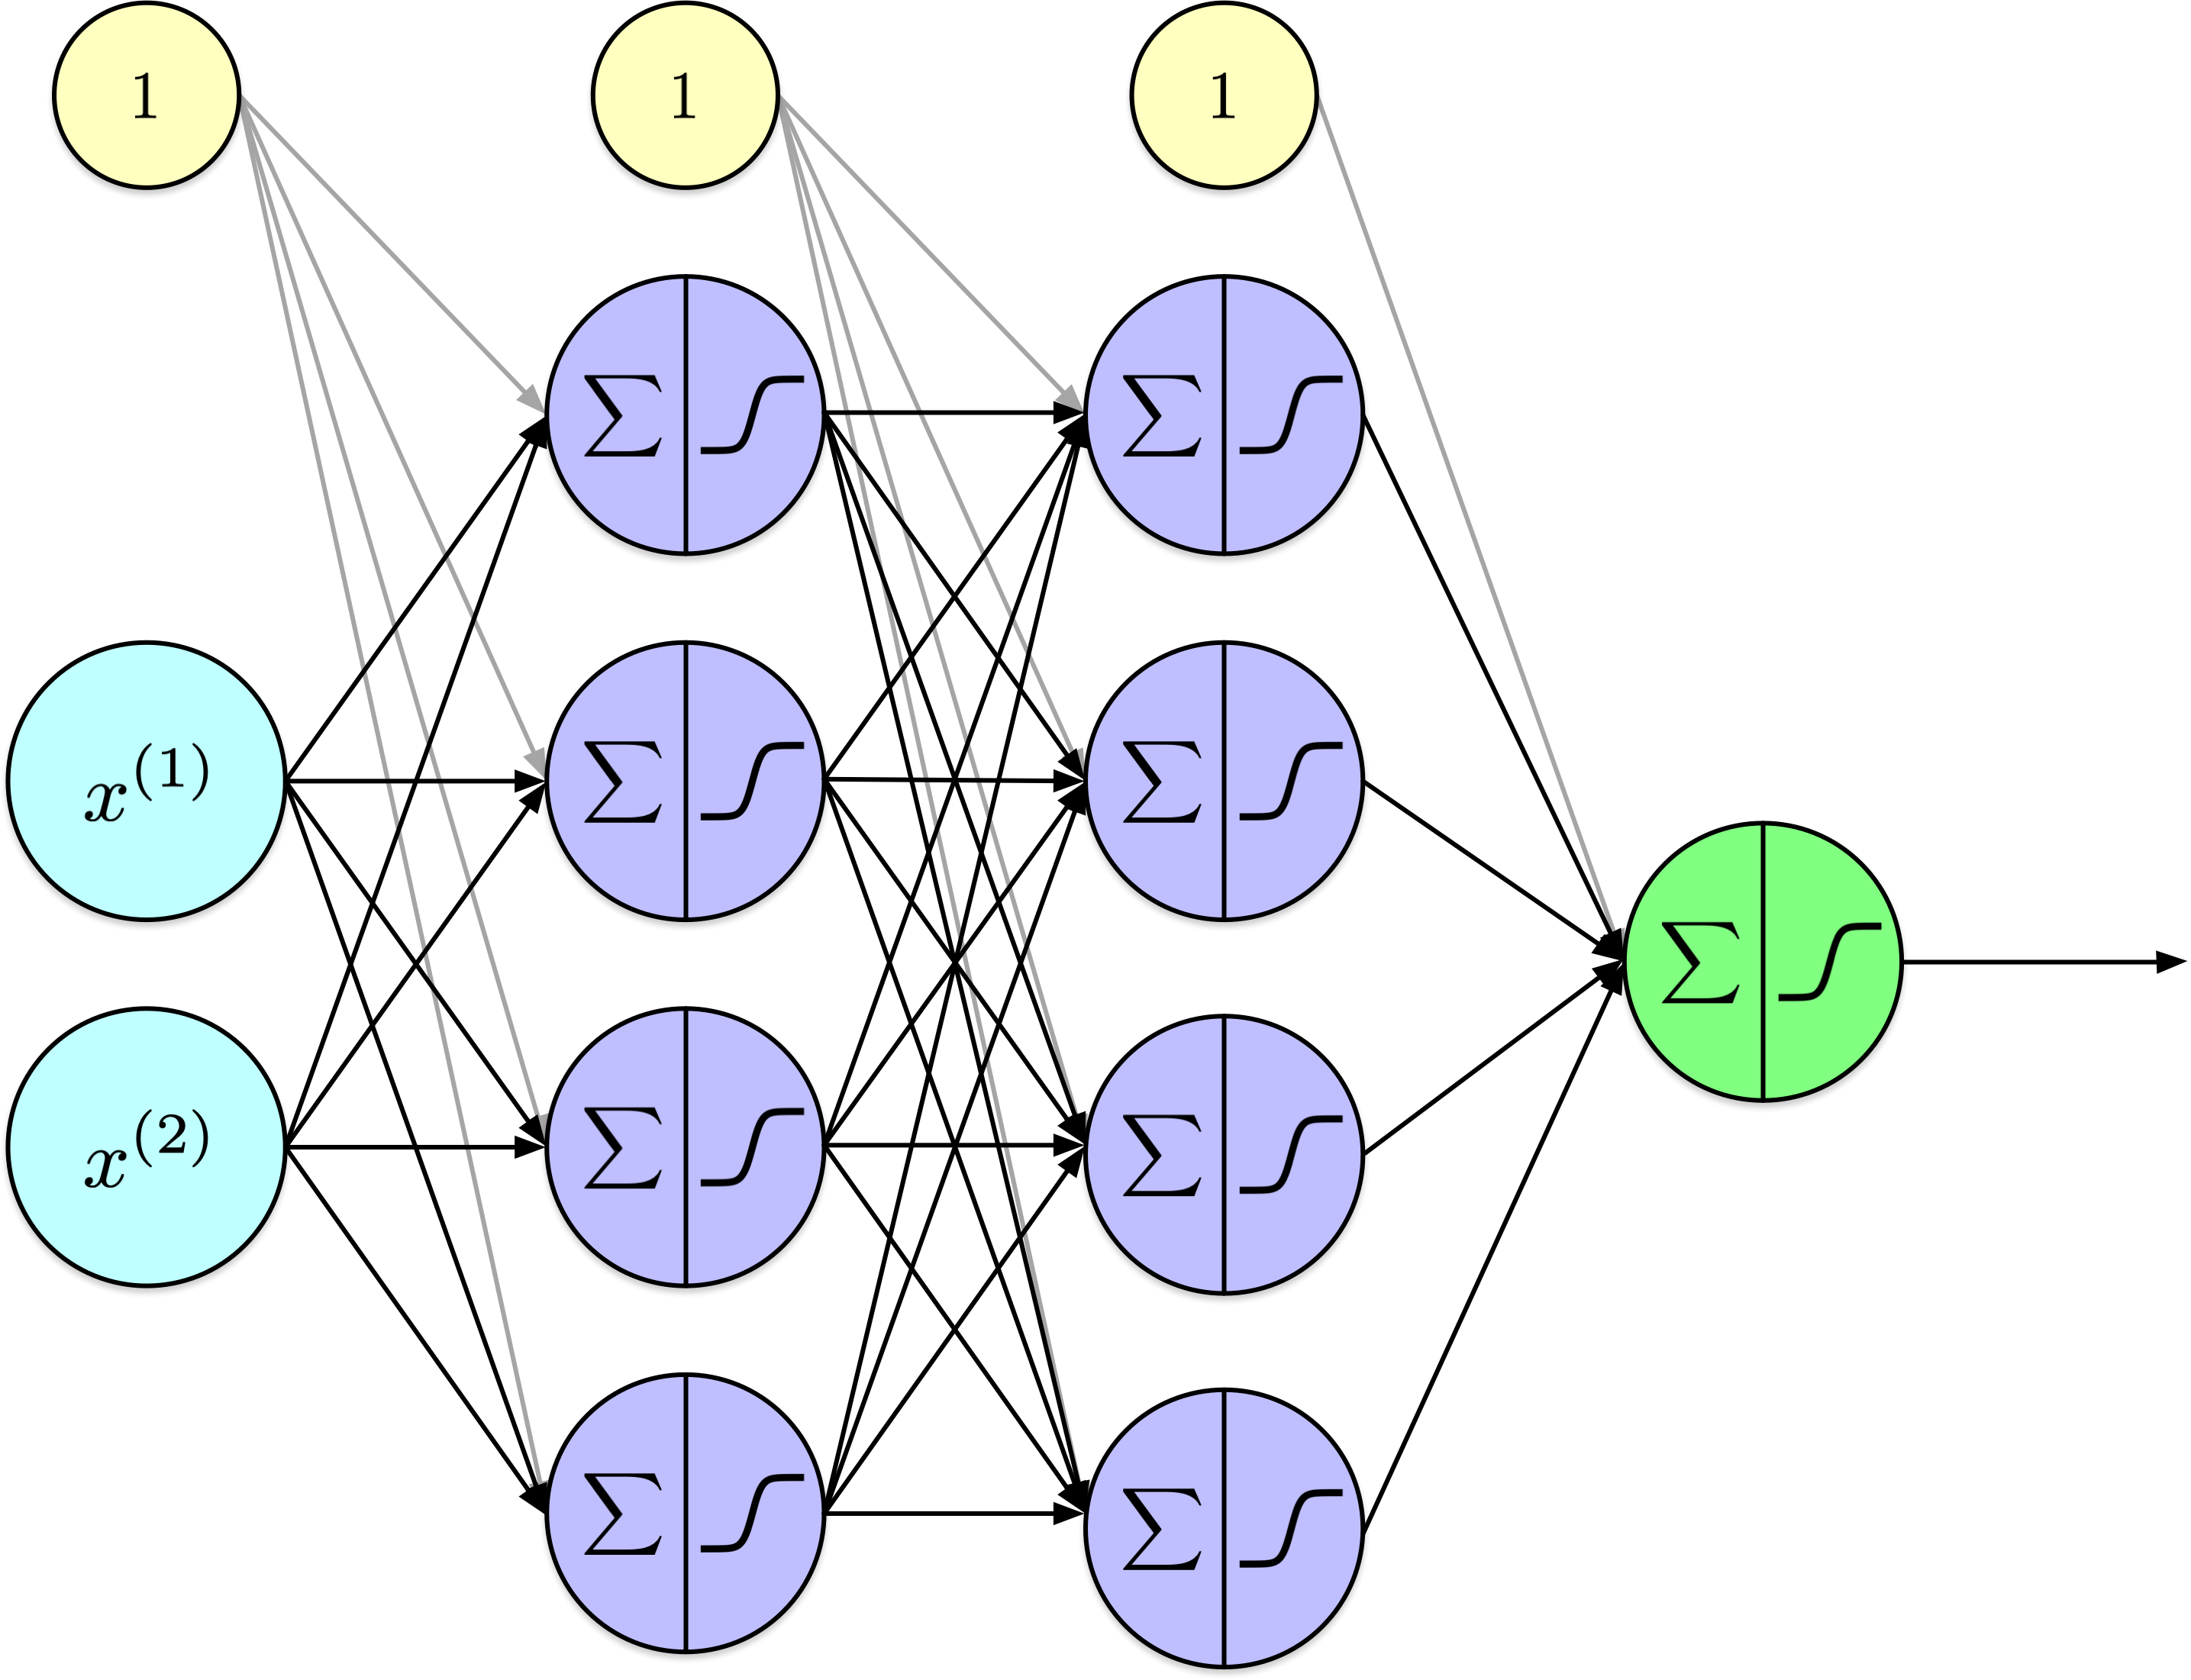
layer_sizes = [2, 4, 4, 1]

[(in_d, out_d) for in_d, out_d in zip(layer_sizes[:-1], layer_sizes[1:])]
[(2, 4), (4, 4), (4, 1)]
[rng.standard_normal(size=(in_d, out_d)) * 0.5 for in_d, out_d in zip(layer_sizes[:-1], layer_sizes[1:])]
[array([[ 0.06286511, -0.06605243,  0.32021133,  0.05245006],
        [-0.26783469,  0.18079753,  0.65200002,  0.47354048]]),
 array([[-0.35186762, -0.63271074, -0.31163723,  0.02066299],
        [-1.16251539, -0.10939583, -0.62295547, -0.36613368],
        [-0.27212949, -0.15815008,  0.20581527,  0.52125668],
        [-0.06426733,  0.68323174, -0.33259734,  0.17575504]]),
 array([[ 0.45173509],
        [ 0.04700615],
        [-0.37174962],
        [-0.46086269]])]

Détour Python : tableaux de biais

[out_d for out_d in layer_sizes[1:]]
[4, 4, 1]
[np.zeros(out_d) for out_d in layer_sizes[1:]]
[array([0., 0., 0., 0.]), array([0., 0., 0., 0.]), array([0.])]

Propagation avant

Retour au réseau : calculer les sorties de chaque couche à partir de la couche précédente.

    def forward(self, X):

        """
        Propagation avant simple : calculer les activations de sortie.
        X : dimensions (N, input_dim)
        Retour : probabilités de sortie, dimensions (N,)
        """

        a = X
        for W, b in zip(self.W, self.b):
            a = sigmoid(a @ W + b)

        return a.ravel()

Suivre les dimensions des tableaux

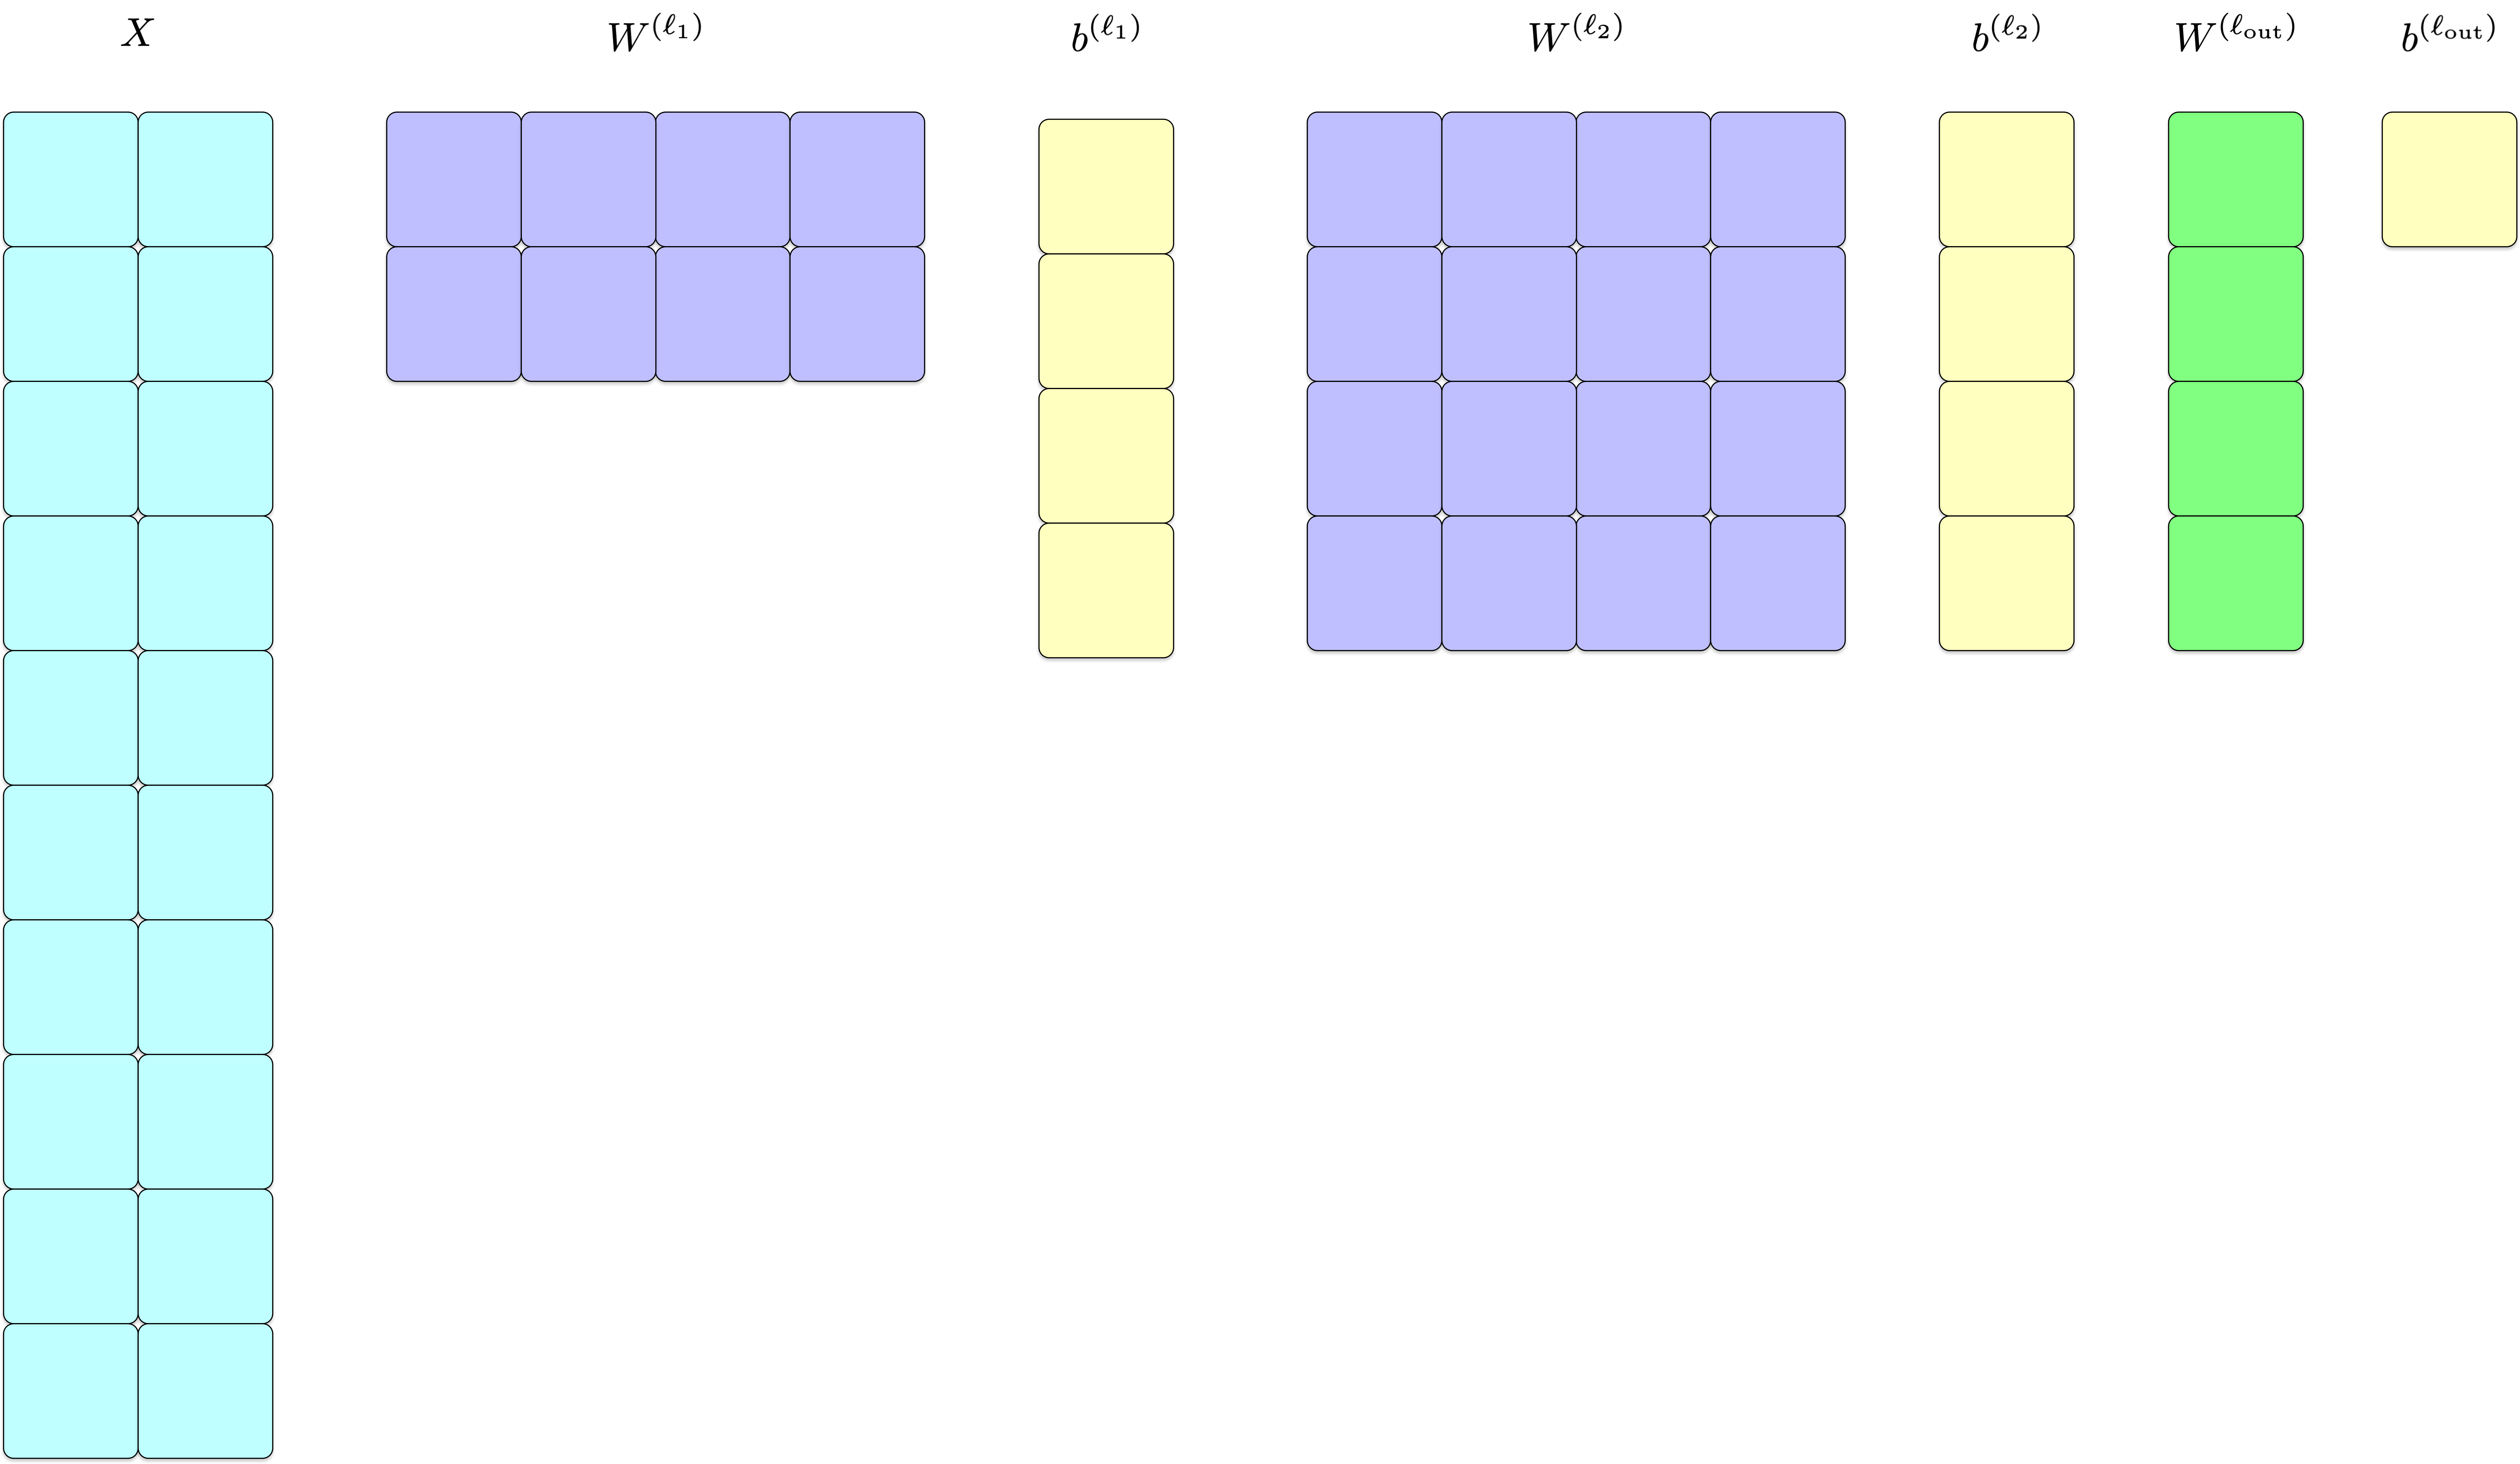
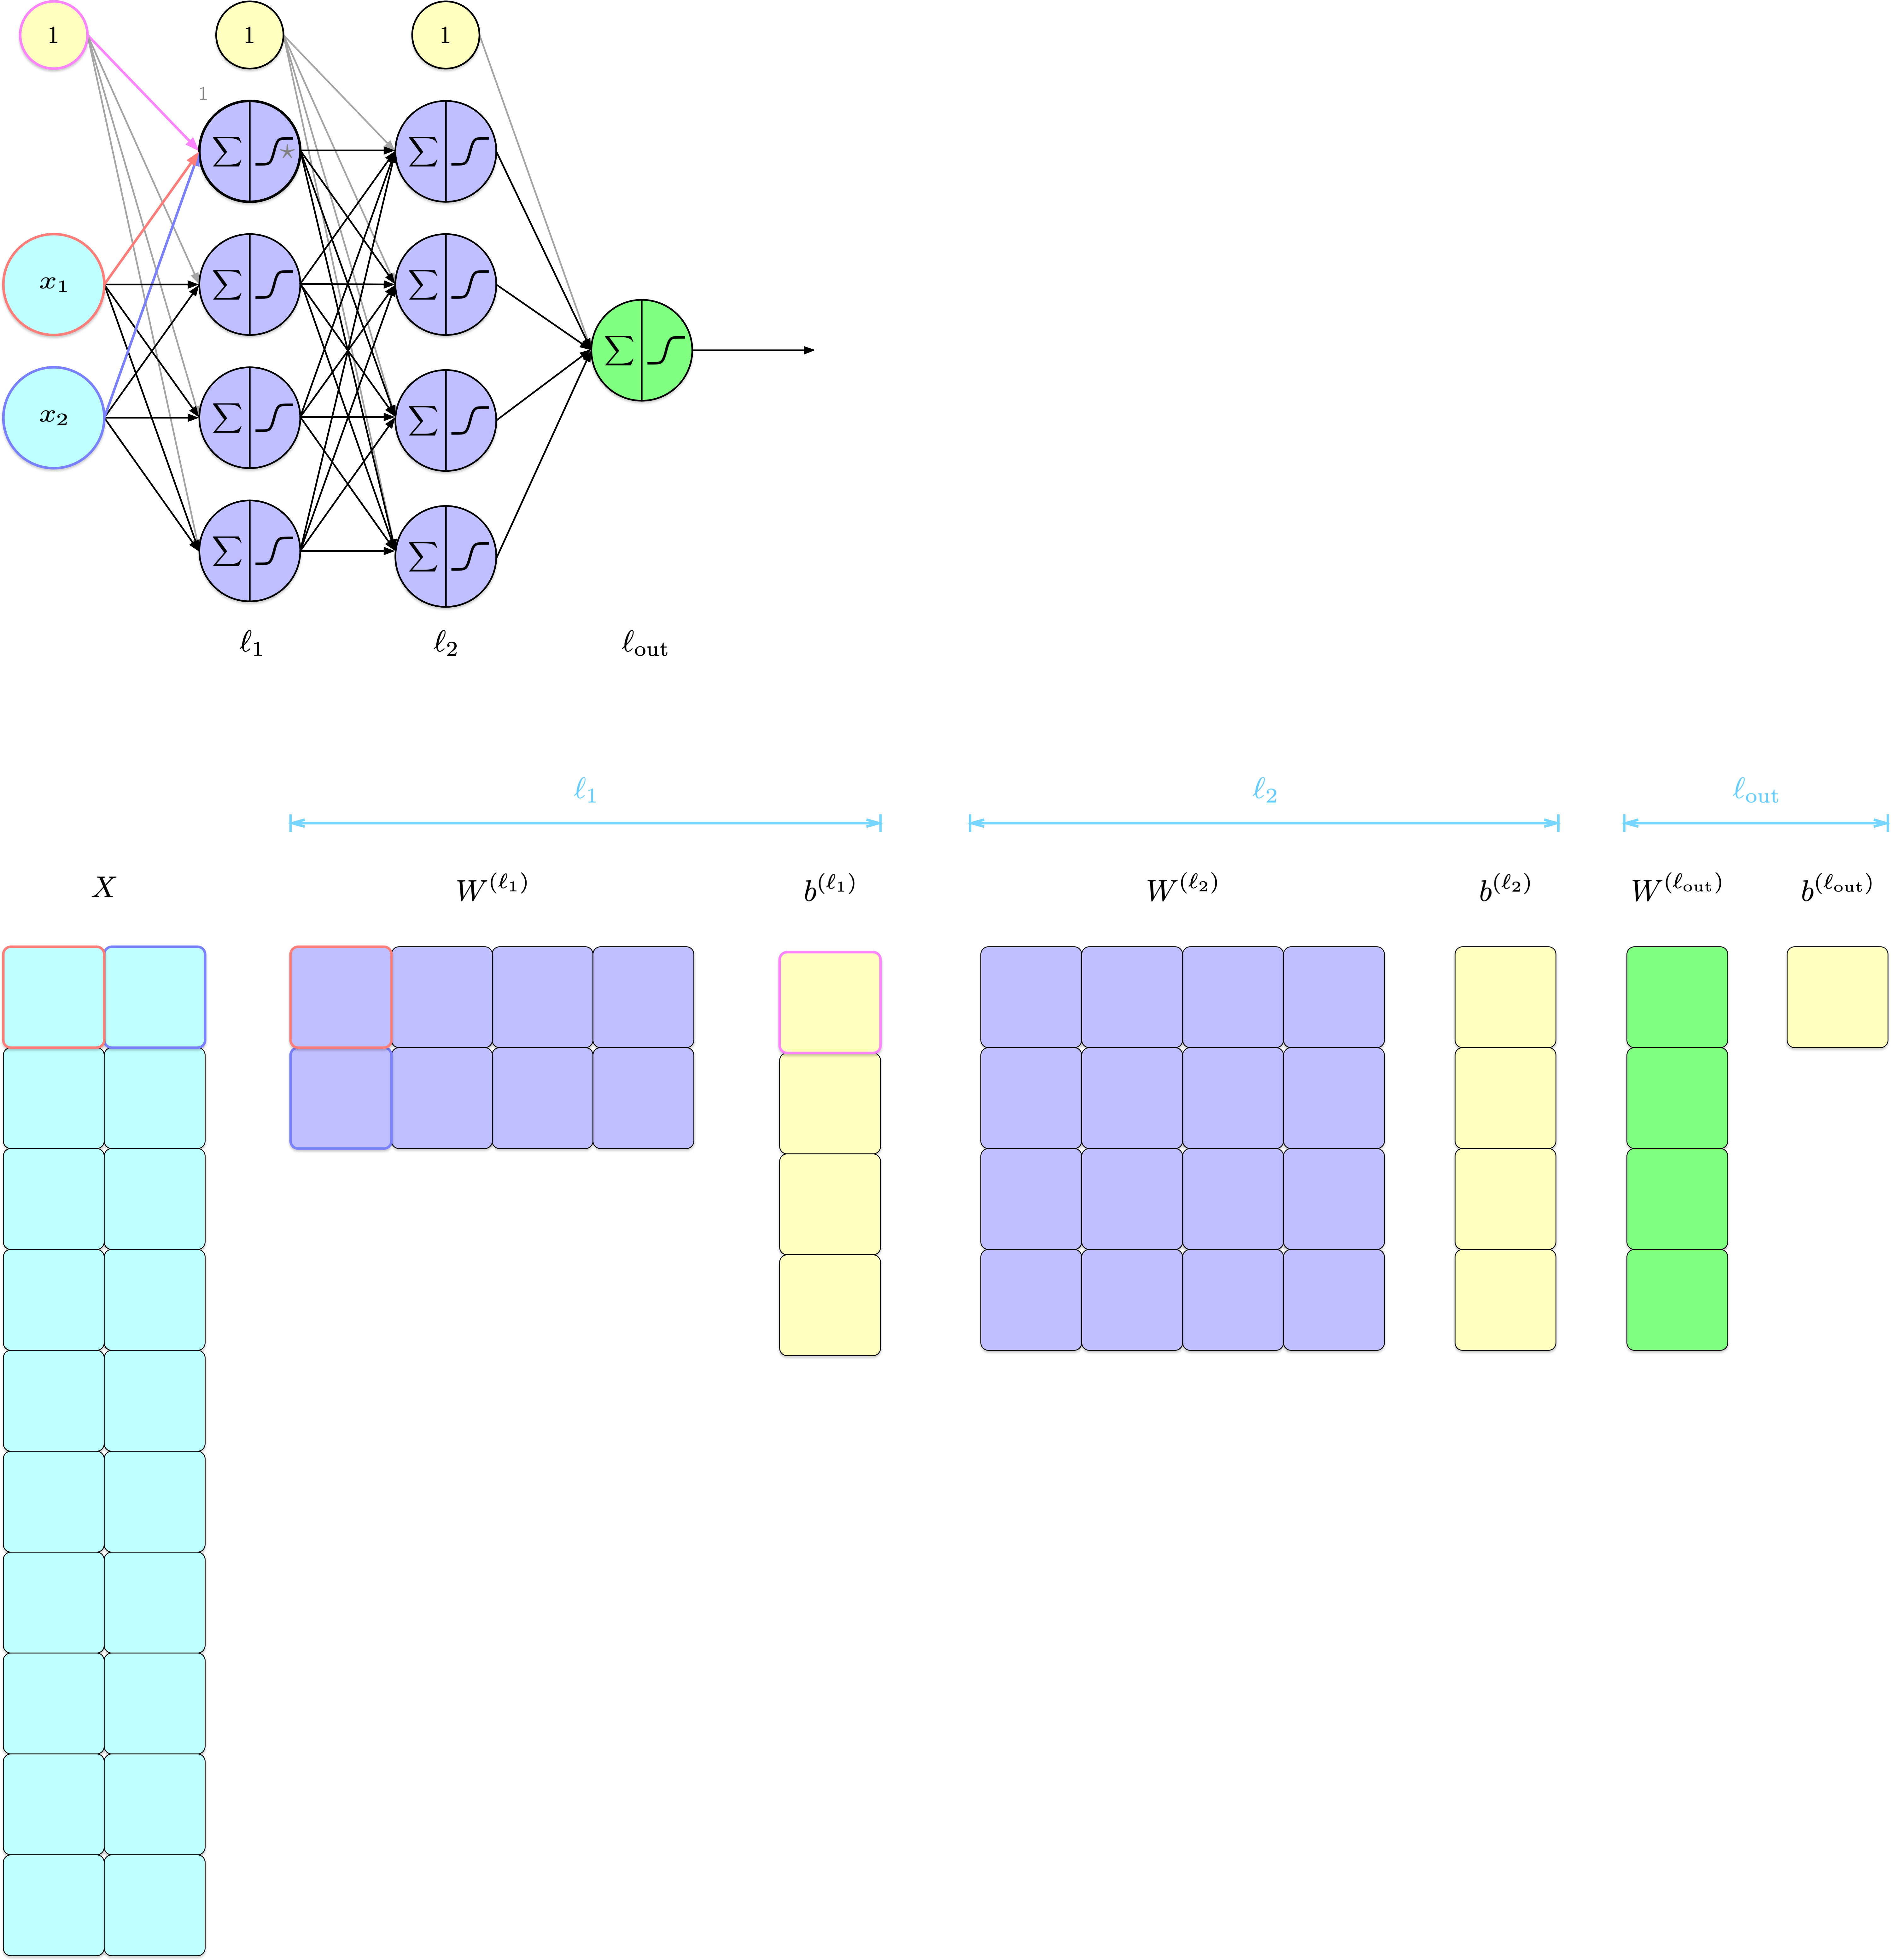
Pour layer_sizes = [2, 4, 4, 1], chaque ligne reste un exemple :

Couche a en entrée W b a en sortie
Cachée 1 (N, 2) (2, 4) (4,) (N, 4)
Cachée 2 (N, 4) (4, 4) (4,) (N, 4)
Sortie (N, 4) (4, 1) (1,) (N, 1)
a = sigmoid(a @ W + b)
  • @ combine chaque exemple avec les poids de la couche.
  • La diffusion (broadcasting) ajoute le même vecteur de biais à chaque ligne.
  • ravel() change les dimensions finales de (N, 1) à (N,).

Suivre les dimensions (suite)

Suivre les dimensions (suite)

Suivre les dimensions (suite)

Suivre les dimensions (suite)

Suivre les dimensions (suite)

Suivre les dimensions (suite)

Suivre les dimensions (suite)

Suivre les dimensions (suite)

Faire des prédictions

    def predict(self, X, threshold=0.5):

        return (self.forward(X) >= threshold).astype(int)

Probabilités, étiquettes et perte

Pour un exemple dont la véritable étiquette est 1 :

Probabilité prédite Classe au seuil de 0,5 Entropie croisée binaire
0,51 1 \(-\log(0.51)\approx 0.673\)
0,99 1 \(-\log(0.99)\approx 0.010\)

Les deux prédictions sont correctes, mais leurs pertes diffèrent.

  • forward(X) retourne des probabilités.
  • predict(X) retourne des étiquettes de classe.
  • loss(X, y) évalue les probabilités par rapport aux cibles.

Calculer la perte

    def loss(self, X, y):

        return bce_loss(y, self.forward(X))

Discussion

À l’exception de l’algorithme d’entraînement, l’implémentation de notre réseau de neurones est maintenant complète.

Sans faire appel à la rétropropagation, comment proposeriez-vous d’apprendre les paramètres du modèle?

Essayer des modifications de paramètres → retenir les meilleures modifications individuelles → les appliquer ensemble → répéter.

Pseudocode

pour chaque itération :
    current_loss = compute_loss(network, training_data)
    deltas = {}
    pour chaque paramètre p du réseau :  # poids ET biais
        original_value = value(p)
        best_delta = 0
        best_loss = current_loss
        pour delta dans [-step, 0, +step] :
            loss_temp = compute_loss_with_replacement(
                p, original_value + delta, training_data)
            si loss_temp < best_loss :
                best_loss = loss_temp
                best_delta = delta
        deltas[p] = best_delta

    # Appliquer toutes les modifications retenues simultanément
    pour chaque paramètre p du réseau :
        value(p) += deltas[p]

Détour Python : parcourir les paramètres

Un court détour Python : les générateurs, les repères (tags) des paramètres et la lecture ou la modification d’éléments de tableaux.

    def _all_param_tags(self):

        """
        Produit des repères pour chaque paramètre scalaire :
        ('W', layer_idx, i, j) ou ('b', layer_idx, j)
        """

        for l, W in enumerate(self.W):
            for i in range(W.shape[0]):
                for j in range(W.shape[1]):
                    yield ('W', l, i, j)
            for j in range(self.b[l].shape[0]):
                yield ('b', l, j)

Détour Python : générateurs

Un générateur produit des valeurs une à la fois, s’arrête à yield et reprend lorsqu’on demande la valeur suivante.

def countdown(n):
    while n > 0:
        yield n
        n -= 1
c = countdown(3)
print(next(c))  # 3
print(next(c))  # 2
print(next(c))  # 1
3
2
1

Détour Python : utiliser un itérateur

Après sa dernière valeur, le générateur lève l’exception StopIteration :

try:
    print(next(c))
except StopIteration:
    print("Exception StopIteration interceptée.")
Exception StopIteration interceptée.

Une boucle for gère automatiquement cette fin d’itération :

for value in countdown(3):
    print(value)
3
2
1

Détour Python : repères des paramètres

Afficher le code
class Demo:

    def __init__(self, layer_sizes):
        self.sizes = list(layer_sizes)
        rng = np.random.default_rng(0)
        self.W = [rng.standard_normal(size=(in_d, out_d)) * 0.5
                  for in_d, out_d in zip(layer_sizes[:-1], layer_sizes[1:])]
        self.b = [np.zeros(out_d) for out_d in layer_sizes[1:]]

    def _all_param_tags(self):

        """
        Produit des repères pour chaque paramètre scalaire :
        ('W', layer_idx, i, j) ou ('b', layer_idx, j)
        """

        for l, W in enumerate(self.W):
            for i in range(W.shape[0]):
                for j in range(W.shape[1]):
                    yield ('W', l, i, j)
            for j in range(self.b[l].shape[0]):
                yield ('b', l, j)

    def show(self):

      for tag in self._all_param_tags():
        print(tag)
d = Demo([2,4,4,1])
d.show()

Détour Python : repères des paramètres

('W', 0, 0, 0)
('W', 0, 0, 1)
('W', 0, 0, 2)
('W', 0, 0, 3)
('W', 0, 1, 0)
('W', 0, 1, 1)
('W', 0, 1, 2)
('W', 0, 1, 3)
('b', 0, 0)
('b', 0, 1)
('b', 0, 2)
('b', 0, 3)
('W', 1, 0, 0)
('W', 1, 0, 1)
('W', 1, 0, 2)
('W', 1, 0, 3)
('W', 1, 1, 0)
('W', 1, 1, 1)
('W', 1, 1, 2)
('W', 1, 1, 3)
('W', 1, 2, 0)
('W', 1, 2, 1)
('W', 1, 2, 2)
('W', 1, 2, 3)
('W', 1, 3, 0)
('W', 1, 3, 1)
('W', 1, 3, 2)
('W', 1, 3, 3)
('b', 1, 0)
('b', 1, 1)
('b', 1, 2)
('b', 1, 3)
('W', 2, 0, 0)
('W', 2, 1, 0)
('W', 2, 2, 0)
('W', 2, 3, 0)
('b', 2, 0)
Détour Python : lire un paramètre

    def _get_param(self, tag):
        kind = tag[0]
        if kind == 'W':
            _, l, i, j = tag
            return self.W[l][i, j]
        else:
            _, l, j = tag
            return self.b[l][j]

Détour Python : modifier un paramètre

    def _set_param(self, tag, val):
        kind = tag[0]
        if kind == 'W':
            _, l, i, j = tag
            self.W[l][i, j] = val
        else:
            _, l, j = tag
            self.b[l][j] = val

Entraînement (apprentissage)

Le détour Python est terminé. Ces fonctions auxiliaires permettent à la boucle d’entraînement d’essayer des modifications et de mettre à jour chaque poids et chaque biais.

    def train(self, X, y, epochs=10, verbose=True):

        for ep in range(1, epochs + 1):

            base_loss = self.loss(X, y)
            updates = {}

            # Essayer des modifications de tous les paramètres
            for tag in self._all_param_tags():

                theta = self._get_param(tag)
                best_delta = 0.0
                best_loss = base_loss

                for delta in (-self.step, 0.0, +self.step):
                    self._set_param(tag, theta + delta)
                    trial_loss = self.loss(X, y)
                    if trial_loss < best_loss:
                        best_loss = trial_loss
                        best_delta = delta

                # rétablir la valeur d'origine
                self._set_param(tag, theta)
                updates[tag] = best_delta

            # Appliquer toutes les modifications ensemble
            for tag, d in updates.items():
                if d != 0.0:
                    self._set_param(tag, self._get_param(tag) + d)

            new_loss = self.loss(X, y)

            if verbose:
                print(f"Époque {ep:3d} : perte {base_loss:.5f} → {new_loss:.5f}")

            # arrêt anticipé facultatif
            if abs(new_loss - base_loss) < 1e-12:
                break

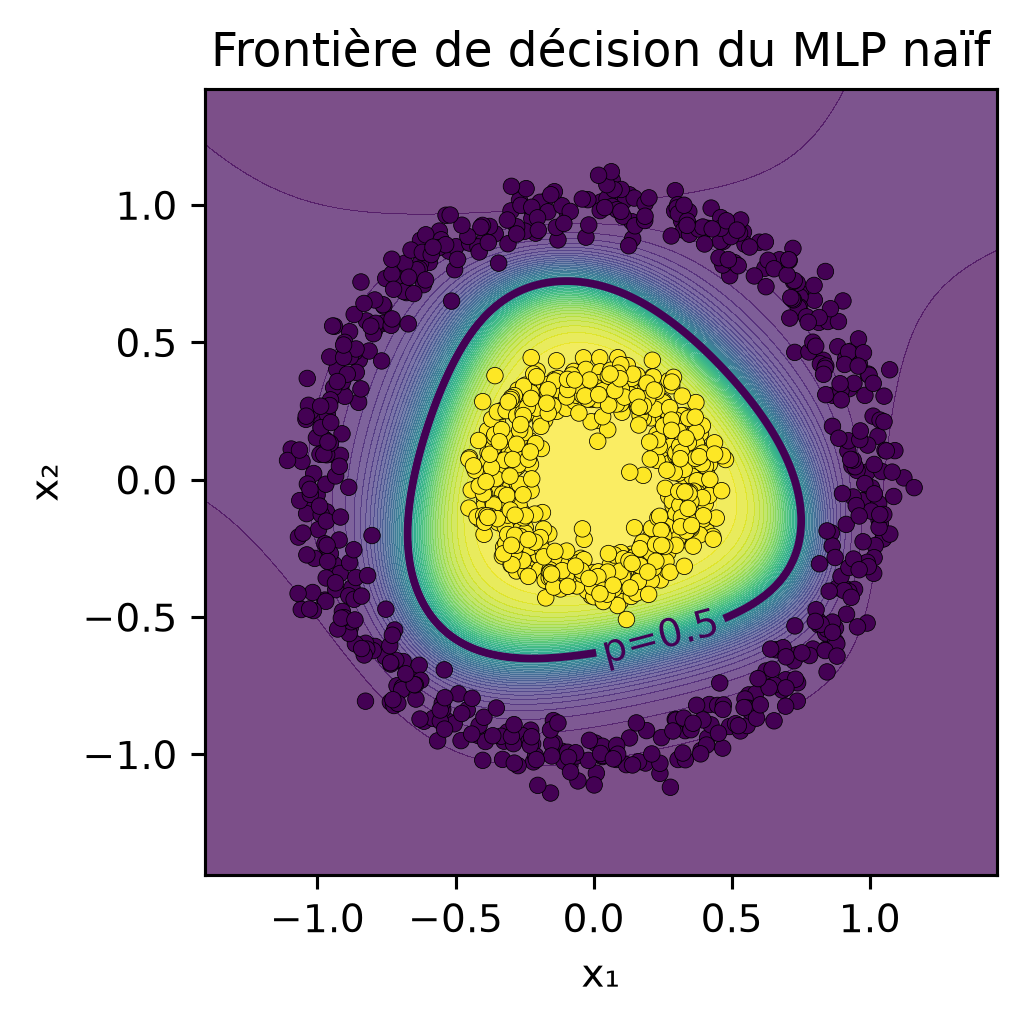
Entraînement sur les cercles

Est-ce que cela fonctionne?

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

model = NaiveMLP([2, 4, 4, 1], step=0.06, seed=0)

print("Perte initiale :", model.loss(X_train, y_train))

model.train(X_train, y_train, epochs=100)

print("Exactitude (entraînement) :", accuracy_score(y_train, model.predict(X_train)))
print("Exactitude (test) : ", accuracy_score(y_test, model.predict(X_test)))
Perte initiale : 0.7001969055705487
Époque   1 : perte 0.70020 → 0.69315
Époque   2 : perte 0.69315 → 0.69547
Époque   3 : perte 0.69547 → 0.69387
Époque   4 : perte 0.69387 → 0.69542
Époque   5 : perte 0.69542 → 0.69384
Époque   6 : perte 0.69384 → 0.69537
Époque   7 : perte 0.69537 → 0.69382
Époque   8 : perte 0.69382 → 0.69531
Époque   9 : perte 0.69531 → 0.69379
Époque  10 : perte 0.69379 → 0.69525
Époque  11 : perte 0.69525 → 0.69361
Époque  12 : perte 0.69361 → 0.69517
Époque  13 : perte 0.69517 → 0.69331
Époque  14 : perte 0.69331 → 0.69503
Époque  15 : perte 0.69503 → 0.69298
Époque  16 : perte 0.69298 → 0.69468
Époque  17 : perte 0.69468 → 0.69257
Époque  18 : perte 0.69257 → 0.69364
Époque  19 : perte 0.69364 → 0.69200
Époque  20 : perte 0.69200 → 0.69173
Époque  21 : perte 0.69173 → 0.69118
Époque  22 : perte 0.69118 → 0.68965
Époque  23 : perte 0.68965 → 0.68970
Époque  24 : perte 0.68970 → 0.68716
Époque  25 : perte 0.68716 → 0.68672
Époque  26 : perte 0.68672 → 0.68417
Époque  27 : perte 0.68417 → 0.68170
Époque  28 : perte 0.68170 → 0.67855
Époque  29 : perte 0.67855 → 0.67406
Époque  30 : perte 0.67406 → 0.66867
Époque  31 : perte 0.66867 → 0.66203
Époque  32 : perte 0.66203 → 0.65492
Époque  33 : perte 0.65492 → 0.64672
Époque  34 : perte 0.64672 → 0.63852
Époque  35 : perte 0.63852 → 0.62948
Époque  36 : perte 0.62948 → 0.61977
Époque  37 : perte 0.61977 → 0.60918
Époque  38 : perte 0.60918 → 0.59844
Époque  39 : perte 0.59844 → 0.58893
Époque  40 : perte 0.58893 → 0.57598
Époque  41 : perte 0.57598 → 0.56310
Époque  42 : perte 0.56310 → 0.55035
Époque  43 : perte 0.55035 → 0.53809
Époque  44 : perte 0.53809 → 0.52214
Époque  45 : perte 0.52214 → 0.50660
Époque  46 : perte 0.50660 → 0.49073
Époque  47 : perte 0.49073 → 0.47591
Époque  48 : perte 0.47591 → 0.45758
Époque  49 : perte 0.45758 → 0.44074
Époque  50 : perte 0.44074 → 0.42251
Époque  51 : perte 0.42251 → 0.41069
Époque  52 : perte 0.41069 → 0.38858
Époque  53 : perte 0.38858 → 0.36998
Époque  54 : perte 0.36998 → 0.35227
Époque  55 : perte 0.35227 → 0.34356
Époque  56 : perte 0.34356 → 0.32577
Époque  57 : perte 0.32577 → 0.31462
Époque  58 : perte 0.31462 → 0.29240
Époque  59 : perte 0.29240 → 0.27704
Époque  60 : perte 0.27704 → 0.25851
Époque  61 : perte 0.25851 → 0.25409
Époque  62 : perte 0.25409 → 0.23884
Époque  63 : perte 0.23884 → 0.23260
Époque  64 : perte 0.23260 → 0.21815
Époque  65 : perte 0.21815 → 0.21238
Époque  66 : perte 0.21238 → 0.19964
Époque  67 : perte 0.19964 → 0.19350
Époque  68 : perte 0.19350 → 0.17787
Époque  69 : perte 0.17787 → 0.16963
Époque  70 : perte 0.16963 → 0.15270
Époque  71 : perte 0.15270 → 0.14804
Époque  72 : perte 0.14804 → 0.13478
Époque  73 : perte 0.13478 → 0.13357
Époque  74 : perte 0.13357 → 0.12381
Époque  75 : perte 0.12381 → 0.12041
Époque  76 : perte 0.12041 → 0.10789
Époque  77 : perte 0.10789 → 0.10512
Époque  78 : perte 0.10512 → 0.09204
Époque  79 : perte 0.09204 → 0.08493
Époque  80 : perte 0.08493 → 0.07447
Époque  81 : perte 0.07447 → 0.07243
Époque  82 : perte 0.07243 → 0.06423
Époque  83 : perte 0.06423 → 0.06479
Époque  84 : perte 0.06479 → 0.06053
Époque  85 : perte 0.06053 → 0.05940
Époque  86 : perte 0.05940 → 0.05501
Époque  87 : perte 0.05501 → 0.05465
Époque  88 : perte 0.05465 → 0.05370
Époque  89 : perte 0.05370 → 0.05036
Époque  90 : perte 0.05036 → 0.04376
Époque  91 : perte 0.04376 → 0.04596
Époque  92 : perte 0.04596 → 0.04283
Époque  93 : perte 0.04283 → 0.04213
Époque  94 : perte 0.04213 → 0.04031
Époque  95 : perte 0.04031 → 0.03879
Époque  96 : perte 0.03879 → 0.03629
Époque  97 : perte 0.03629 → 0.03574
Époque  98 : perte 0.03574 → 0.03499
Époque  99 : perte 0.03499 → 0.03293
Époque 100 : perte 0.03293 → 0.03075
Exactitude (entraînement) : 1.0
Exactitude (test) :  1.0

Visualisation

Afficher le code
# Tracer la frontière de décision dans le plan (x1, x2) d'origine

def plot_decision_boundary(model, X, y, title="Frontière de décision du MLP naïf"):

    # grille dans le plan des entrées
    pad = 0.3
    x1_min, x1_max = X[:,0].min()-pad, X[:,0].max()+pad
    x2_min, x2_max = X[:,1].min()-pad, X[:,1].max()+pad

    xx, yy = np.meshgrid(
        np.linspace(x1_min, x1_max, 400),
        np.linspace(x2_min, x2_max, 400)
    )
    grid = np.c_[xx.ravel(), yy.ravel()]

    # prédire les probabilités sur la grille
    p = model.forward(grid).reshape(xx.shape)

    # probabilités, contour p=0,5 et exemples
    plt.figure(figsize=(3.75, 3.75), dpi=140)
    plt.contourf(xx, yy, p, levels=50, alpha=0.7)
    cs = plt.contour(xx, yy, p, levels=[0.5], linewidths=2)
    plt.scatter(X[:,0], X[:,1], c=y, s=18, edgecolor="k", linewidth=0.2)
    plt.clabel(cs, fmt={0.5: "p=0.5"})
    plt.title(title)
    plt.xlabel("x₁")
    plt.ylabel("x₂")
    plt.tight_layout()
    plt.show()

plot_decision_boundary(model, X, y)

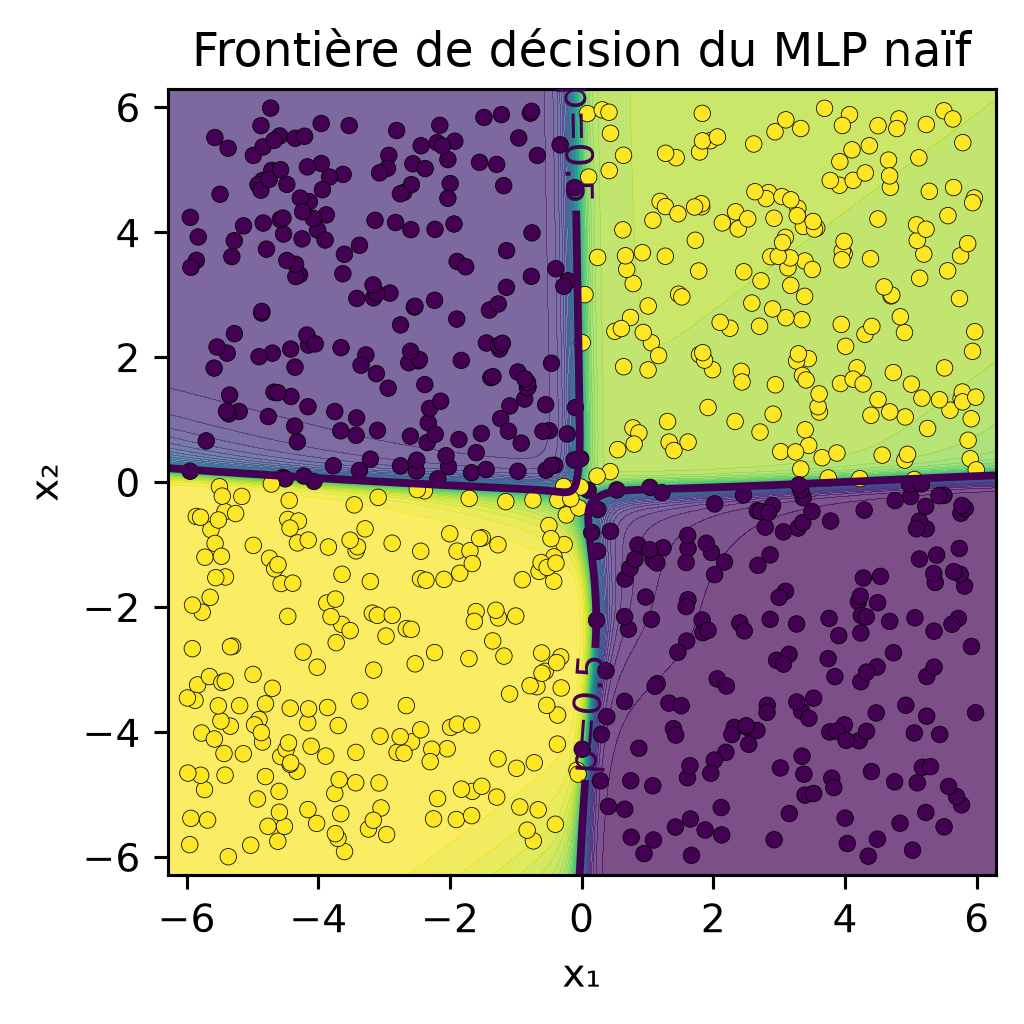
Données de type XNOR

Afficher le code
n_samples = 800
rng = np.random.default_rng(42)

X = rng.uniform(-6, 6, size=(n_samples, 2))
x1, x2 = X[:, 0], X[:, 1]

y = ((x1 * x2) > 0).astype(int)

plt.figure(figsize=(4.5, 4.5))
plt.scatter(X[y == 0, 0], X[y == 0, 1],
            color="C0", label="classe 0", edgecolor="k", linewidth=0.3)
plt.scatter(X[y == 1, 0], X[y == 1, 1],
            color="C1", label="classe 1", edgecolor="k", linewidth=0.3)

plt.axhline(0, color="gray", linestyle="--", linewidth=1)
plt.axvline(0, color="gray", linestyle="--", linewidth=1)

plt.xlabel("x₁")
plt.ylabel("x₂")
plt.title("Données de type XNOR")
plt.xlim(-6, 6)
plt.ylim(-6, 6)
plt.axis("equal")
plt.legend()
plt.tight_layout()
plt.show()

Données de type XNOR (suite)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

model = NaiveMLP([2, 4, 4, 1], step=0.06, seed=0)

print("Perte initiale :", model.loss(X_train, y_train))

model.train(X_train, y_train, epochs=100, verbose=False)

print("Perte finale :", model.loss(X_train, y_train))

print("Exactitude (entraînement) :", accuracy_score(y_train, model.predict(X_train)))
print("Exactitude (test) : ", accuracy_score(y_test, model.predict(X_test)))
Perte initiale : 0.7029764953722529
Perte finale : 0.09228049882862682
Exactitude (entraînement) : 0.9866666666666667
Exactitude (test) :  0.98

Données de type XNOR (suite)

plot_decision_boundary(model, X, y)

Limites

  • Évaluations répétées : chaque essai de modification recalcule les prédictions et la perte sur l’ensemble d’entraînement.
  • Taille de pas fixe : les seules modifications possibles sont -step, 0 et +step.
  • Interactions entre paramètres : des modifications utiles individuellement peuvent entrer en conflit lorsqu’elles sont appliquées ensemble.
  • Sensibilité : les résultats dépendent de l’initialisation, de la taille du pas et du jeu de données.

Pourquoi une méthode plus rapide est nécessaire

Notre petit réseau possède 37 paramètres.

  • Trois essais par paramètre : \(3\times 37=111\) évaluations de la perte.
  • Une évaluation de référence et une évaluation finale : 113 évaluations par parcours.
  • Chaque évaluation applique le réseau à tout l’ensemble d’entraînement.

La rétropropagation calcule les gradients de tous les paramètres à l’aide d’une propagation avant et d’une propagation arrière. Un optimiseur met ensuite les paramètres à jour ensemble.

Conclusion

Résumé

  • Implémenté un réseau à propagation avant complet avec des tableaux NumPy.
  • Suivi les dimensions des entrées, des poids, des biais et des sorties des couches.
  • Distingué les probabilités prédites, les étiquettes de classe et l’entropie croisée binaire.
  • Utilisé une méthode naïve sans dérivées pour choisir des modifications de paramètres et les appliquer simultanément.
  • Relié les évaluations répétées de la perte et les interactions entre paramètres au besoin d’un calcul efficace des gradients.

Prochaine présentation

  • Notation des couches, règle de dérivation en chaîne et rétropropagation.
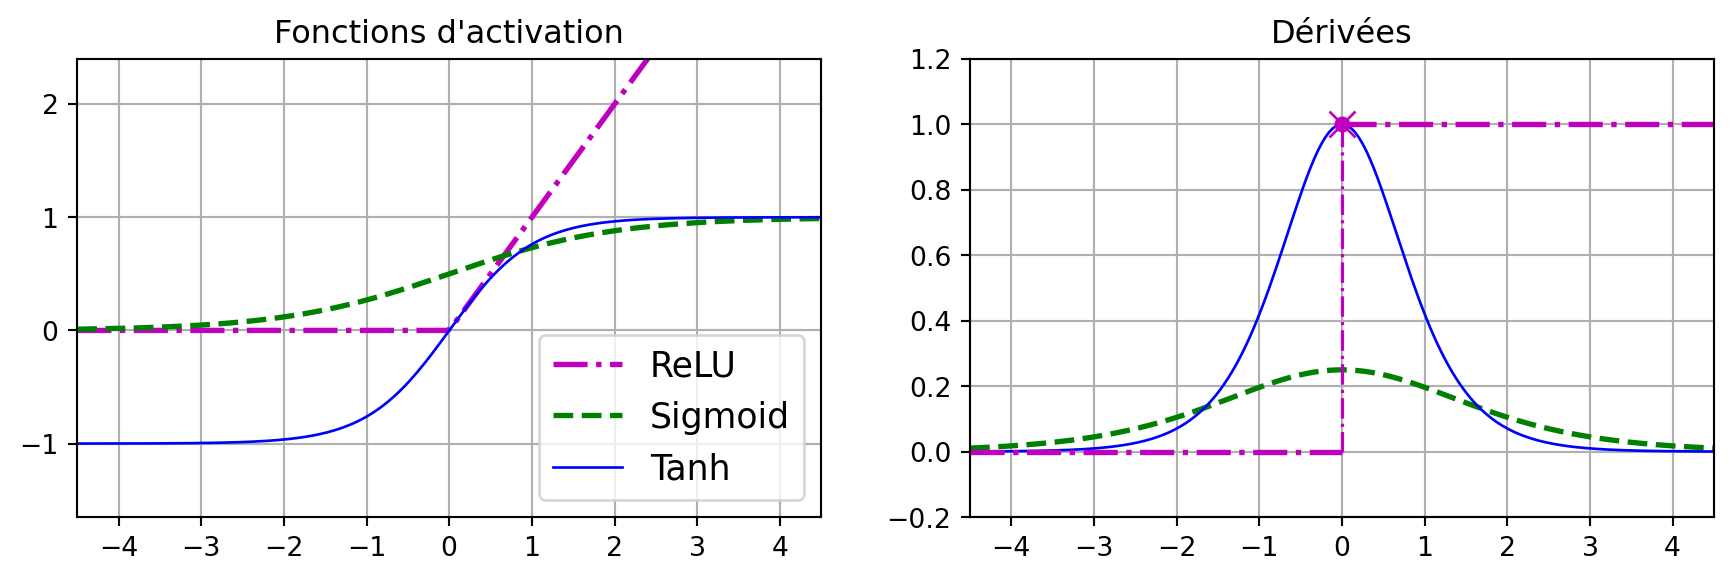
  • Entraînement fondé sur les gradients et comportement des dérivées des fonctions d’activation.

Références

Russell, Stuart, et Peter Norvig. 2020. Artificial Intelligence: A Modern Approach. 4ᵉ éd. Pearson. http://aima.cs.berkeley.edu/.

Marcel Turcotte

[email protected]

École de génie électrique et d’informatique

Université d’Ottawa