Entraînement des réseaux de neurones : difficultés et choix pratiques

CSI 4506 - automne 2026

Marcel Turcotte

Version : 1 nov. 2026 17h45

Préambule

Message du jour

Objectifs d’apprentissage

  • Expliquer comment les paysages de perte, les dérivées des activations et l’initialisation influencent l’optimisation.
  • Distinguer les gradients évanescents, les gradients explosifs et le surapprentissage.
  • Choisir les activations de sortie et les pertes pour la régression et les classifications binaire, multiétiquette et multiclasse.
  • Expliquer L1, L2, le dropout et l’arrêt précoce, et interpréter leurs effets dans le code.
  • Comparer SimplerMLP à SimpleMLP et distinguer l’inférence de la poursuite de l’apprentissage.
  • Reconnaître l’oubli catastrophique et expliquer comment le rejeu d’anciens exemples peut améliorer la rétention.

Paysages de perte et optimisation

Nous avons les gradients. Quelles difficultés subsistent?

La rétropropagation a été popularisée en 1986. Pourquoi l’apprentissage profond a-t-il pris son essor beaucoup plus tard?

  • Le paysage de perte décrit la fonction objectif en fonction des paramètres.
  • Un gradient décrit la variation locale de cette fonction.
  • Les progrès dépendent aussi des paramètres initiaux et du taux d’apprentissage.

Où la descente de gradient nous mènera-t-elle?

Partons de chaque point vert. Avec un petit taux d’apprentissage constant, où les mises à jour pourraient-elles s’arrêter?

Afficher le code
import numpy as np
import matplotlib.pyplot as plt

def gradient_descent_1d(gradient, start, learning_rate, steps, clip_value=None):
    trajectory = [float(start)]
    for _ in range(steps):
        g = float(gradient(trajectory[-1]))
        if not np.isfinite(g):
            break  # La fonction simplifiée n'a pas de dérivée finie ici.
        if clip_value is not None:
            g = np.clip(g, -clip_value, clip_value)
        trajectory.append(trajectory[-1] - learning_rate * g)
    return np.asarray(trajectory)

def plot_landscape(objective, trajectory, ax, title, show_trajectory=True):
    left = min(-1.2, trajectory.min())
    right = max(1.2, trajectory.max())
    padding = 0.05 * (right - left)
    theta = np.linspace(left - padding, right + padding, 800)
    ax.plot(theta, objective(theta), color='black', linewidth=1.5)
    if show_trajectory:
        ax.plot(trajectory, objective(trajectory), 'o-', color='#377eb8',
                markersize=3, linewidth=0.8, alpha=0.65)
    ax.scatter(trajectory[0], objective(trajectory[0]), color='#4daf4a',
               s=45, zorder=4, label='Départ')
    if show_trajectory:
        ax.scatter(trajectory[-1], objective(trajectory[-1]), color='#d95f02',
                   s=45, zorder=5, label='Fin')
    ax.set(title=title, xlabel=r'$\theta$', ylabel=r'$J(\theta)$')
    ax.grid(alpha=0.25)
    return theta


fig, axes = plt.subplots(1, 3, figsize=(11, 3.2))
overview = [
    ('Référence convexe', lambda t: t**2, lambda t: 2*t, 0.9, 0.1),
    ('Minima locaux', lambda t: 0.8*np.sin(4*t)+0.5*t**2,
     lambda t: 3.2*np.cos(4*t)+t, 0.5, 0.05),
    ('Région plate sous-optimale', lambda t: (np.maximum(0, t)-1)**2,
     lambda t: 2*(t-1) if t > 0 else 0.0, -0.8, 0.1)
]
for index, (ax, (_, objective, gradient, start, rate)) in enumerate(zip(axes, overview)):
    trajectory = gradient_descent_1d(gradient, start, rate, steps=60)
    plot_landscape(objective, trajectory, ax, f'Paysage {index+1}',
                   show_trajectory=False)
axes[0].legend(fontsize=8)
fig.tight_layout()
plt.show()

Trois paysages, trois trajectoires

Afficher le code
fig, axes = plt.subplots(1, 3, figsize=(11, 3.2))
for ax, (title, objective, gradient, start, rate) in zip(axes, overview):
    trajectory = gradient_descent_1d(gradient, start, rate, steps=60)
    plot_landscape(objective, trajectory, ax, title)
axes[0].legend(fontsize=8)
fig.tight_layout()
plt.show()

Propagation des gradients et initialisation

Que se passe-t-il sur un chemin plus long?

La présentation 13 utilisait une seule unité cachée. Que se passe-t-il lorsque de nombreuses transformations du passage arrière se composent?

Afficher le code
distance = np.arange(21)
fig, ax = plt.subplots(figsize=(8, 3.5))
for factor in (0.5, 1.0, 1.5):
    ax.semilogy(distance, factor**distance, 'o-', label=f'Multiplicateur par étape : {factor}')
ax.set(xlabel='Nombre de transformations arrière', ylabel='Valeur absolue du signal',
       title='Chemin scalaire avec signal entrant égal à 1')
ax.grid(alpha=0.3)
ax.legend()
fig.tight_layout()
plt.show()

Gradients évanescents

  • La rétropropagation multiplie de façon répétée des poids et des dérivées locales d’activation.
  • De petits facteurs peuvent rendre les gradients des premières couches trop faibles pour un apprentissage efficace.
  • Les unités sigmoïdes saturées ont des dérivées proches de zéro.

Gradients explosifs

  • Des transformations répétées peuvent amplifier les signaux du passage arrière.
  • De grands gradients peuvent produire de grandes mises à jour des paramètres et un entraînement instable.
  • Une initialisation adaptée et un taux d’apprentissage raisonnable aident; l’écrêtage des gradients peut limiter les mises à jour.

Fonctions d’activation et dérivées

Quelles pentes préservent un signal utile au passage arrière? ReLU résout-elle tous les problèmes?

Afficher le code
# Attribution: https://github.com/ageron/handson-ml3/blob/main/10_neural_nets_with_keras.ipynb

import numpy as np
import matplotlib.pyplot as plt

from scipy.special import expit as sigmoid

def relu(z):
    return np.maximum(0, z)

def derivative(f, z, eps=0.000001):
    return (f(z + eps) - f(z - eps))/(2 * eps)

max_z = 4.5
z = np.linspace(-max_z, max_z, 200)

plt.figure(figsize=(11, 3.1))

plt.subplot(121)
plt.plot(z, relu(z), "m-.", linewidth=2, label="ReLU")
plt.plot(z, sigmoid(z), "g--", linewidth=2, label="Sigmoïde")
plt.plot(z, np.tanh(z), "b-", linewidth=1, label="Tanh")
plt.grid(True)
plt.title("Fonctions d'activation")
plt.axis([-max_z, max_z, -1.65, 2.4])
plt.gca().set_yticks([-1, 0, 1, 2])
plt.legend(loc="lower right", fontsize=13)

plt.subplot(122)
plt.plot(z, derivative(sigmoid, z), "g--", linewidth=2, label="Sigmoïde")
plt.plot(z, derivative(np.tanh, z), "b-", linewidth=1, label="Tanh")
plt.plot([-max_z, 0], [0, 0], "m-.", linewidth=2)
plt.plot([0, max_z], [1, 1], "m-.", linewidth=2)
plt.plot([0, 0], [0, 1], "mo", markersize=6, markerfacecolor="white")
plt.grid(True)
plt.title("Dérivées")
plt.axis([-max_z, max_z, -0.2, 1.2])

plt.show()

Conserver un gradient du côté négatif

Que se passe-t-il si une unité ReLU reste inactive pour les exemples d’entraînement?

Afficher le code
import numpy as np
import matplotlib.pyplot as plt

# Définir la fonction Leaky ReLU
def leaky_relu(x, alpha=0.2):
    return np.where(x > 0, x, alpha * x)

# Définir la dérivée de Leaky ReLU
def leaky_relu_derivative(x, alpha=0.2):
    return np.where(x > 0, 1, alpha)

# Générer un intervalle de valeurs d'entrée
x_values = np.linspace(-4, 4, 400)

# Calculer Leaky ReLU et sa dérivée
leaky_relu_values = leaky_relu(x_values)
leaky_relu_derivative_values = leaky_relu_derivative(x_values)

# Créer le graphique
plt.figure(figsize=(5, 3))

# Tracer Leaky ReLU
plt.subplot(1, 2, 1)
plt.plot(x_values, leaky_relu_values, label='Leaky ReLU', color='blue')
plt.title('Fonction d\'activation Leaky ReLU')
plt.xlabel('x')
plt.ylabel('f(x)')
plt.grid(True)
plt.axhline(0, color='black',linewidth=0.5)
plt.axvline(0, color='black',linewidth=0.5)
plt.legend()

# Tracer la dérivée de Leaky ReLU
plt.subplot(1, 2, 2)
plt.plot([-4, 0], [0.2, 0.2], label='Dérivée de Leaky ReLU', color='red')
plt.plot([0, 4], [1, 1], color='red')
plt.plot([0, 0], [0.2, 1], 'o', color='red', markerfacecolor='white')
plt.title('Dérivée de Leaky ReLU')
plt.xlabel('x')
plt.ylabel("f'(x)")
plt.grid(True)
plt.axhline(0, color='black',linewidth=0.5)
plt.axvline(0, color='black',linewidth=0.5)
plt.legend()

# Afficher les graphiques
plt.tight_layout()
plt.show()

Pourquoi ne pas initialiser tous les poids à la même valeur?

Des poids initialisés aléatoirement brisent la symétrie entre les unités. Les biais peuvent être initialisés à zéro.

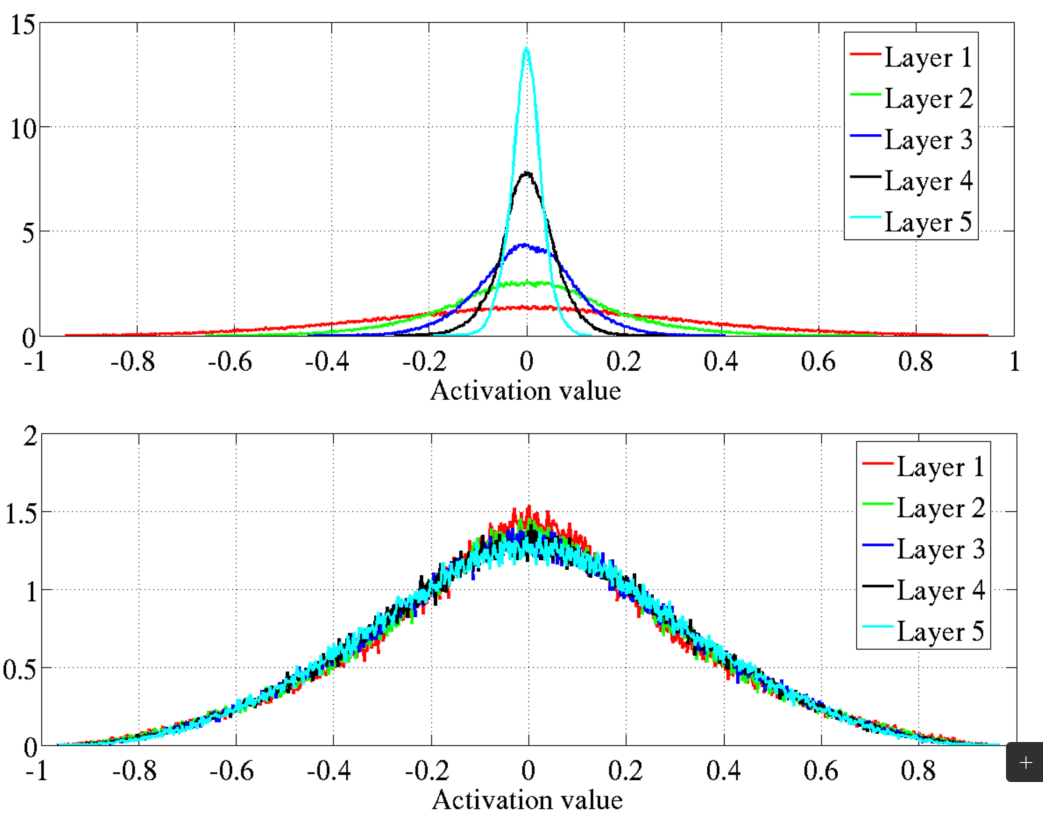
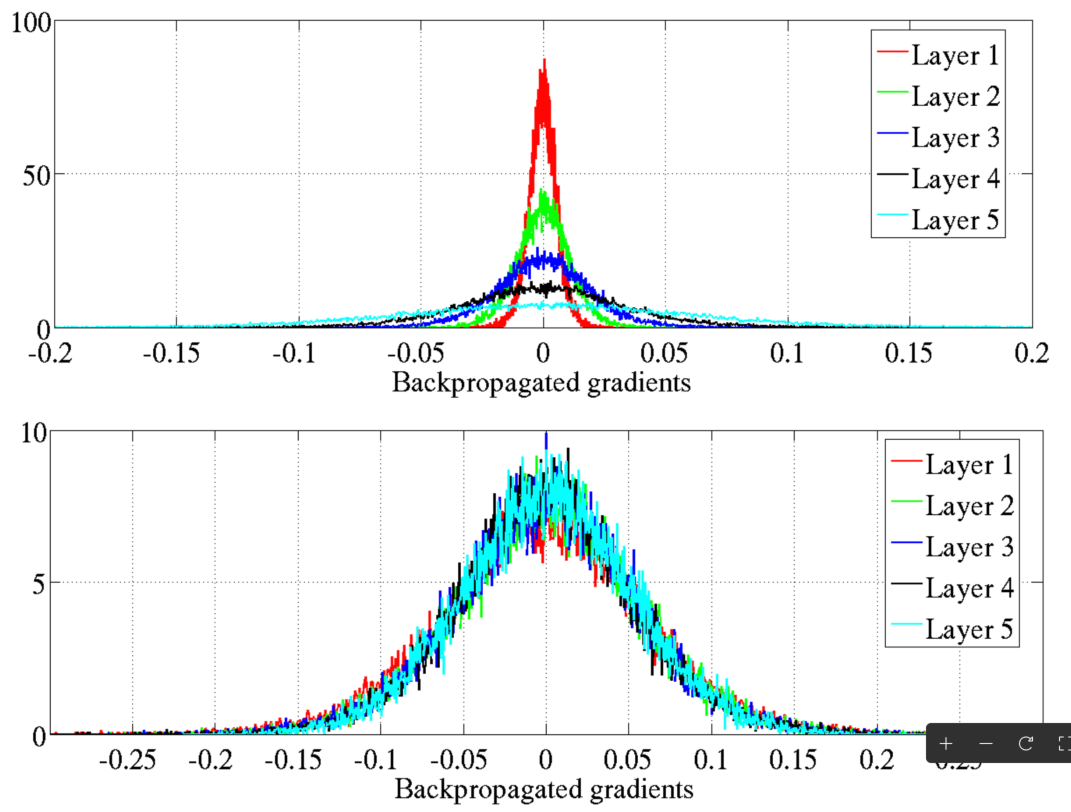
Glorot et Bengio

Des poids aléatoires brisent la symétrie. Leur échelle importe-t-elle?

Activations

Signaux du passage arrière

Initialisation de He

Pour les couches cachées ReLU, l’initialisation normale de He utilise

\operatorname{Var}(W)=\frac{2}{n_{\mathrm{in}}}.

def he_init(rng, fan_in, fan_out):
    std = np.sqrt(2.0 / fan_in)
    return rng.normal(0.0, std, size=(fan_in, fan_out))

Quels choix favorisent la propagation des gradients?

  • Autres fonctions d’activation : unité linéaire rectifiée (ReLU) et variantes, dont Leaky ReLU, Parametric ReLU et Exponential Linear Unit.

  • Initialisation des poids : Xavier (Glorot) ou He.

Écrêtage des gradients

Comment limiter une mise à jour de descente de gradient trop grande tout en préservant sa direction?

Pour un vecteur gradient g et un seuil c>0 :

\widetilde g = \begin{cases} g, & \|g\|_2\leq c,\\ c\,g/\|g\|_2, & \|g\|_2>c. \end{cases}

La mise à jour utilise \widetilde g. Sa norme est bornée par c.

optimizer = keras.optimizers.SGD(learning_rate=0.01, global_clipnorm=1.0)

Décroissance du taux d’apprentissage

Des pas plus petits peuvent-ils aider plus tard dans l’entraînement? Et si on les réduit trop tôt?

À l’époque t=1,2,\ldots, avec un facteur de décroissance 0<\gamma<1 :

\alpha_t=\alpha_1\gamma^{t-1}.

if self.lr_decay is not None:
    self.lr = self.base_lr * self.lr_decay ** (ep - 1)

Couches de sortie

Changer l’activation de sortie?

Nous avons remplacé une sigmoïde cachée par ReLU. Faut-il faire de même à la sortie?

Pour la régression, la sortie doit respecter les dimensions et l’intervalle de valeurs de la cible :

  • Nombre de neurones de sortie :
    • 1 par dimension
  • Fonction d’activation de sortie :
    • Linéaire pour les cibles sans contrainte; ReLU/softplus pour les cibles non négatives; sigmoïde/tanh pour les cibles bornées.
  • Fonction de perte :

Ces probabilités décrivent-elles un choix exclusif?

Des sigmoïdes distinctes donnent [0.8,\;0.7,\;0.1]. Plusieurs étiquettes peuvent-elles s’appliquer? Une seule classe peut-elle s’appliquer?

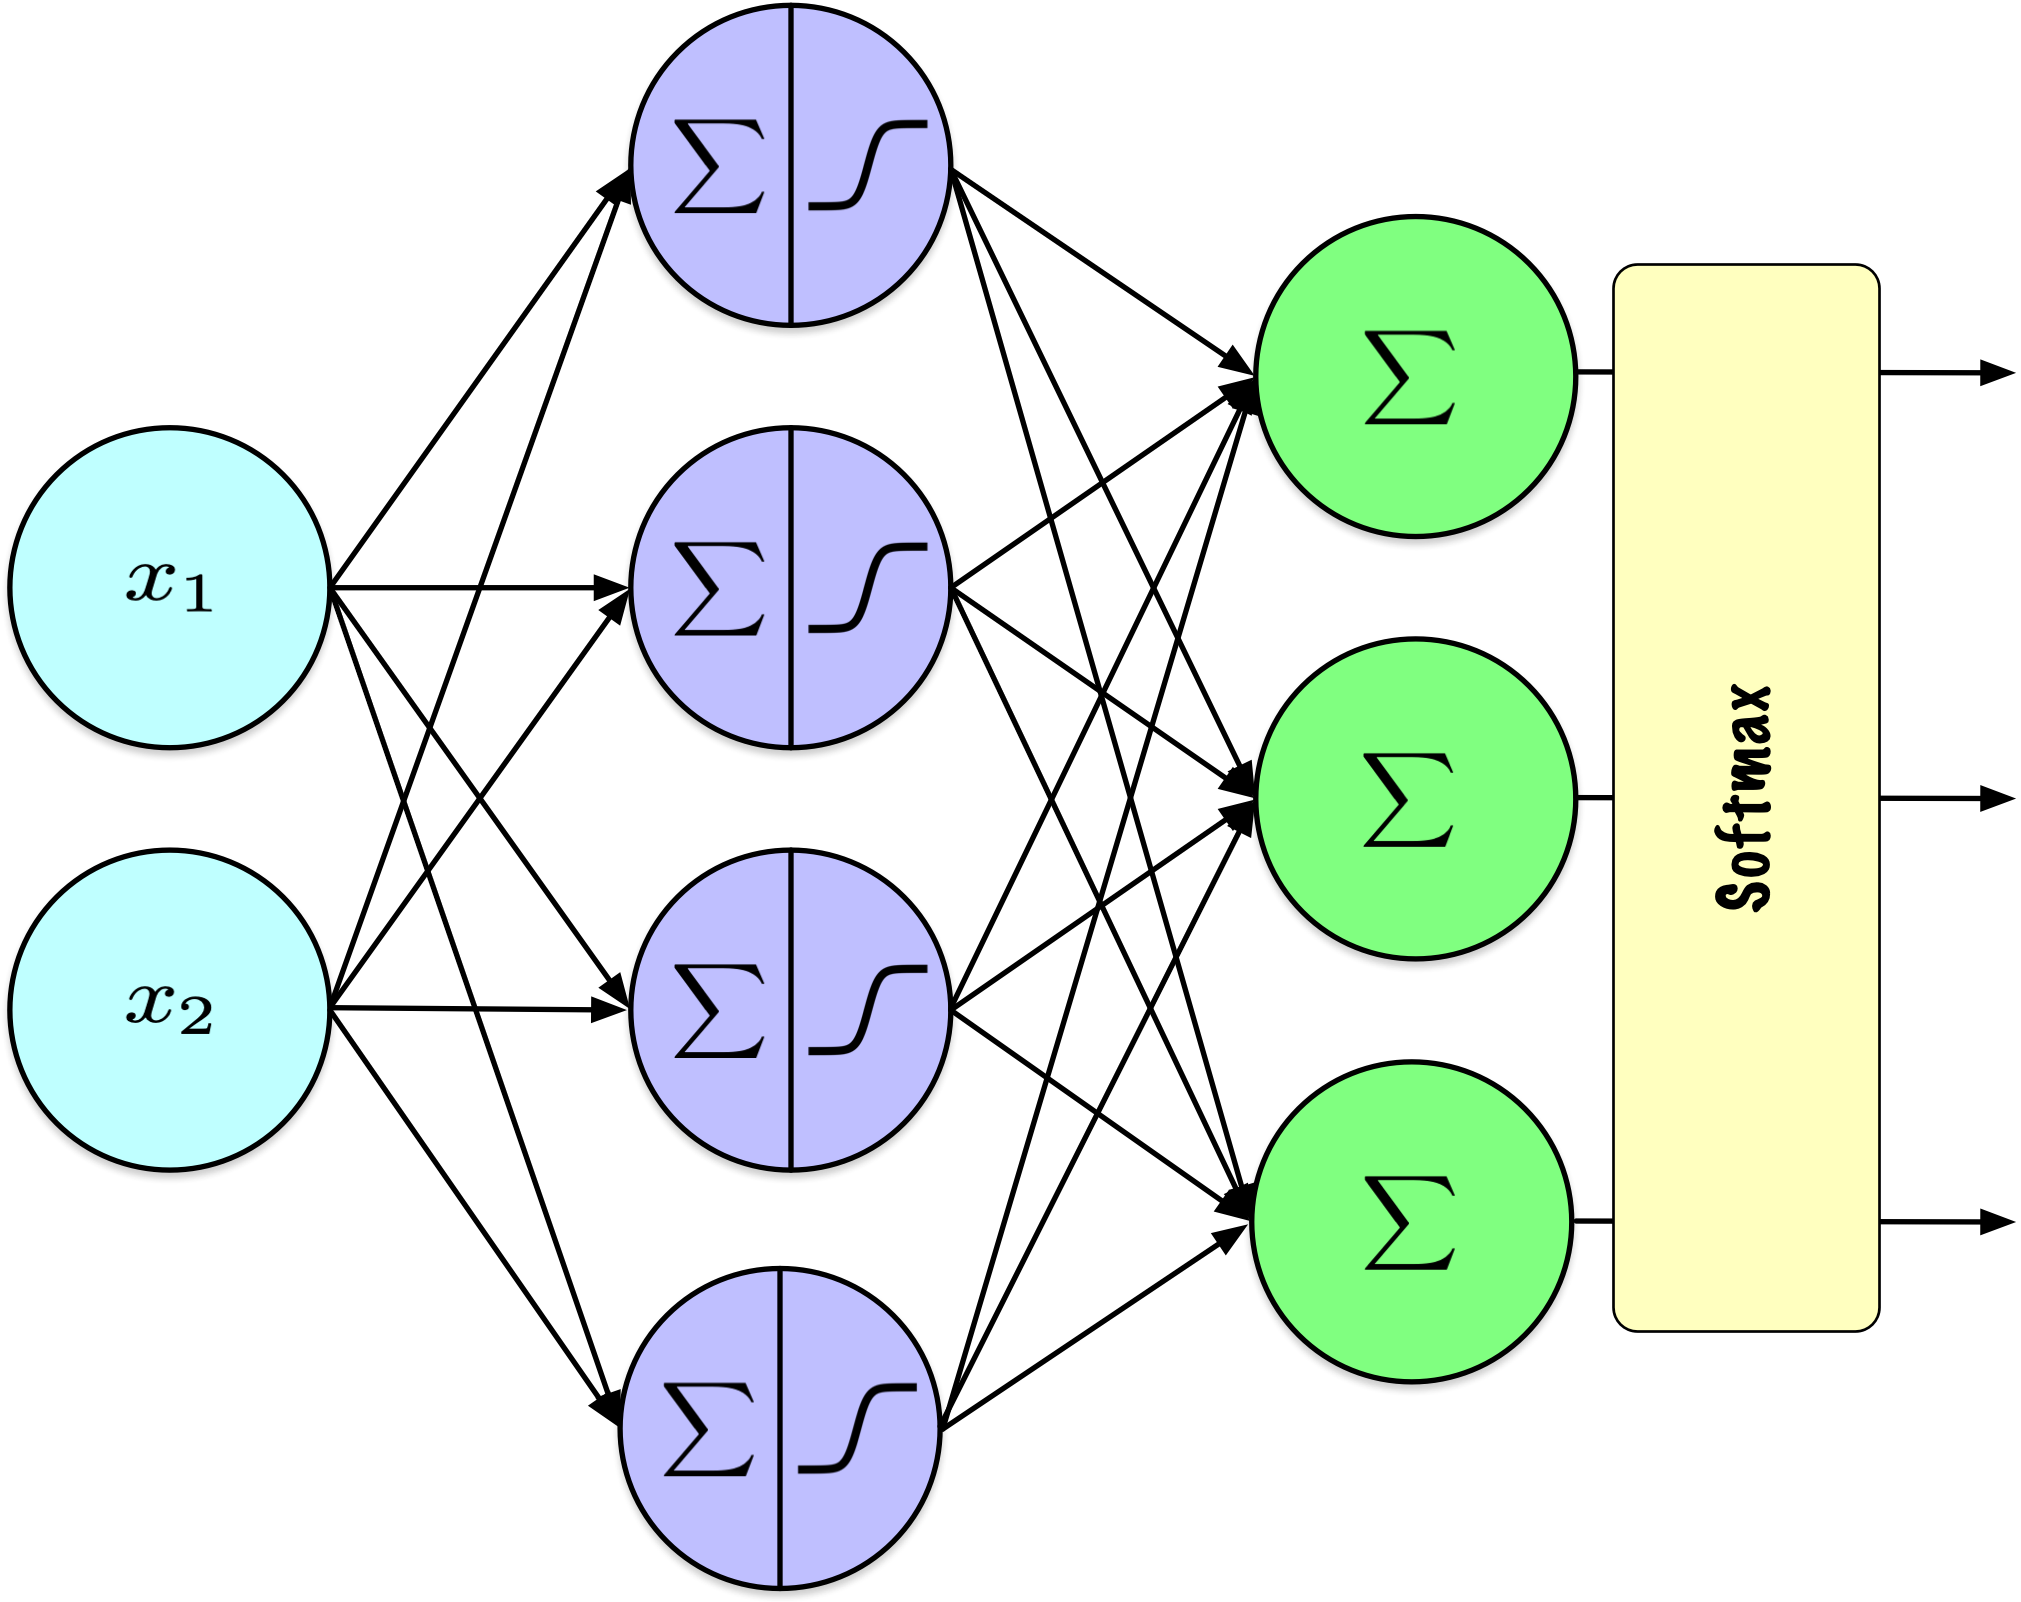
Une distribution commune à la sortie

Quelles propriétés la sortie doit-elle avoir lorsqu’une seule des K classes est correcte?

Des scores à une distribution de probabilités

La fonction softmax est une fonction d’activation utilisée en classification multiclasse pour convertir un vecteur de scores bruts en probabilités dont la somme vaut 1.

Pour K logits de sortie \mathbf{z} = [z_1, z_2, \ldots, z_K] :

\hat p_k=\operatorname{softmax}(\mathbf{z})_k = \frac{e^{z_k}}{\sum_{j=1}^{K} e^{z_j}}

Ici, \hat p_k est la probabilité prédite pour la classe k.

Que signifient les écarts entre les scores?

Quelle classe l’emporte? Comment l’écart entre les scores influence-t-il sa probabilité?

z_1 z_2 z_3 \hat p_1 \hat p_2 \hat p_3 \sum
1.47 -0.39 0.22 0.69 0.11 0.20 1.00
5.00 6.00 4.00 0.24 0.67 0.09 1.00
0.90 0.80 1.10 0.32 0.29 0.39 1.00
-2.00 2.00 -3.00 0.02 0.98 0.01 1.00

Limites

Quelles limites pouvez-vous proposer?

Notre classifieur Fashion-MNIST reçoit l’image d’un 7 manuscrit. Que prédira-t-il?

Softmax répartit toute la probabilité entre les classes connues. Aucune sortie « aucune de ces classes » n’est prévue.

Peut-on se fier aux probabilités?

Parmi de nombreuses prédictions faites avec environ 90 % de confiance, quelle proportion devrait être correcte?

Environ 90 %, si le modèle est bien calibré.

Des probabilités qui totalisent un ne garantissent pas une bonne calibration.

Même classe prédite, même perte?

La vraie classe est Setosa. Les deux prédictions la choisissent :

  • [0.25,\;\mathbf{0.51},\;0.24]
  • [0.005,\;\mathbf{0.99},\;0.005]

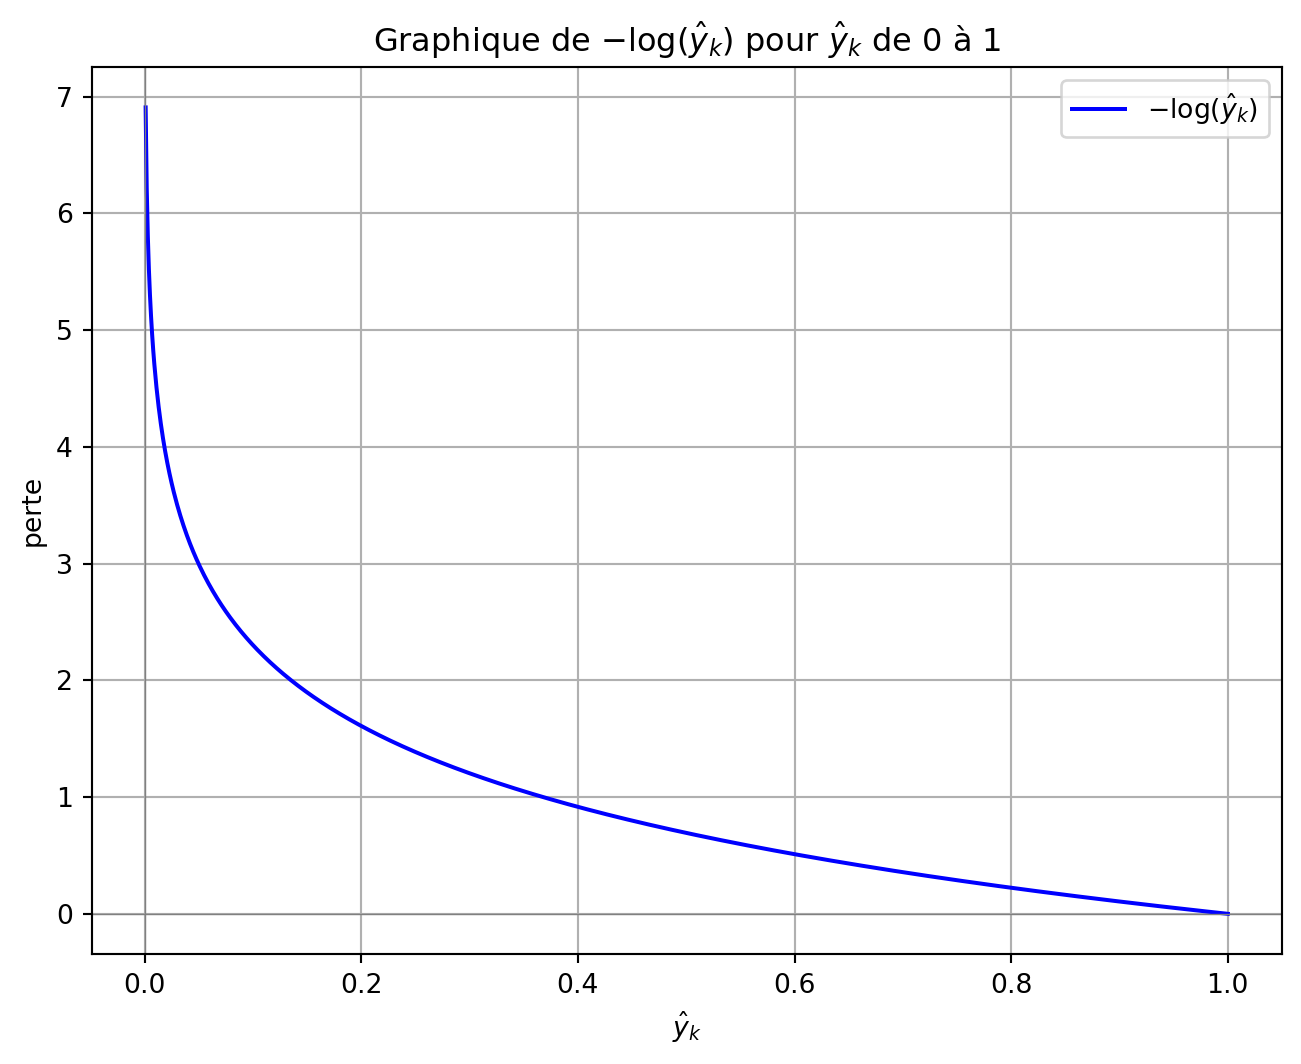
L’entropie croisée récompense la probabilité attribuée à la vraie classe :

\ell = -\sum_{k=1}^{K} y_k \log(\hat p_k)

Cible encodée en un seul 1 (one-hot) : y. Probabilités de classe prédites : \hat p_k.

Entropie croisée : un exemple détaillé

  • Problème de classification : 3 classes
    • Versicolour, Setosa, Virginica.
  • Encodage en un seul 1 :
    • Setosa = [0, 1, 0].
  • Sorties softmax et perte :
    • [0.22,\mathbf{0.7}, 0.08] : perte = -\log(0.7) = 0.3567.
    • [0.7, \mathbf{0.22}, 0.08] : perte = -\log(0.22) = 1.5141.
    • [0.7, \mathbf{0.08}, 0.22] : perte = -\log(0.08) = 2.5257.

Comment pénaliser les erreurs faites avec confiance?

Afficher le code
import numpy as np
import matplotlib.pyplot as plt

# Générer des valeurs de p strictement positives jusqu’à 1
p_values = np.linspace(0.001, 1, 1000)

# Calculer le logarithme naturel de chaque valeur de p
ln_p_values = - np.log(p_values)

# Tracer le graphique
plt.figure(figsize=(8, 6))
plt.plot(p_values, ln_p_values, label=r'$-\log(\hat p_k)$', color='b')

# Ajouter les étiquettes et le titre
plt.xlabel(r'$\hat p_k$')
plt.ylabel(r'perte')
plt.title(r'Courbe de $-\log(\hat p_k)$ pour $\hat p_k$ de 0 à 1')
plt.grid(True)
plt.axhline(0, color='gray', lw=0.5)  # Ajouter une ligne horizontale à y=0
plt.axvline(0, color='gray', lw=0.5)  # Ajouter une ligne verticale à x=0

# Afficher le graphique
plt.legend()
plt.show()

D’un exemple à un jeu de données

Pour un jeu de N exemples, la perte moyenne d’entropie croisée sur tous les exemples se calcule ainsi :

J = -\frac{1}{N} \sum_{i=1}^{N} \sum_{k=1}^{K} y_{i,k} \log(\hat p_{i,k})

où :

  • i désigne les différents exemples du jeu de données.
  • y_{i,k} et \hat p_{i,k} sont respectivement les probabilités réelles et prédites de la classe k pour l’exemple i.

Associer sorties et pertes de classification

Tâche Unités de sortie Activation Perte
Binaire Une Sigmoïde Entropie croisée binaire
Multiétiquette Une par étiquette Sigmoïdes distinctes Entropie croisée binaire
Multiclasse Une par classe Softmax commune Entropie croisée catégorielle

La tâche détermine le sens des sorties et la perte des données à minimiser.

Vidéo complémentaire : argmax et softmax

Régularisation

Définition

La régularisation est une modification d’un algorithme d’apprentissage visant à réduire son erreur de généralisation.

Quelle sauvegarde déploieriez-vous?

L’erreur d’entraînement continue de diminuer. La courbe de validation justifie-t-elle de poursuivre l’entraînement?

Afficher le code
from copy import deepcopy
from sklearn.metrics import root_mean_squared_error
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import SGDRegressor

# Générer des données quadratiques bruitées et réserver des exemples de validation.
np.random.seed(42)
m = 100
X = 6 * np.random.rand(m, 1) - 3
y = 0.5 * X ** 2 + X + 2 + np.random.randn(m, 1)
X_train, y_train = X[: m // 2], y[: m // 2, 0]
X_valid, y_valid = X[m // 2 :], y[m // 2 :, 0]

preprocessing = make_pipeline(PolynomialFeatures(degree=90, include_bias=False),
                              StandardScaler())
X_train_prep = preprocessing.fit_transform(X_train)
X_valid_prep = preprocessing.transform(X_valid)
sgd_reg = SGDRegressor(penalty=None, eta0=0.002, random_state=42)
n_epochs = 500
best_valid_rmse = float('inf')
train_errors, val_errors = [], []  # Code complémentaire pour la figure ci-dessous

for epoch in range(n_epochs):
    sgd_reg.partial_fit(X_train_prep, y_train)
    y_valid_predict = sgd_reg.predict(X_valid_prep)
    val_error = root_mean_squared_error(y_valid, y_valid_predict)
    if val_error < best_valid_rmse:
        best_valid_rmse = val_error
        best_model = deepcopy(sgd_reg)

    # Code complémentaire : calculer et conserver l'erreur d'entraînement pour la figure
    y_train_predict = sgd_reg.predict(X_train_prep)
    train_error = root_mean_squared_error(y_train, y_train_predict)
    val_errors.append(val_error)
    train_errors.append(train_error)

# Code complémentaire : produire et sauvegarder la figure 4–20
best_epoch = np.argmin(val_errors)
plt.plot(val_errors, "b-", linewidth=3, label="Ensemble de validation")
plt.plot(train_errors, "r--", linewidth=2, label="Ensemble d'entraînement")
plt.legend(loc="upper right")
plt.xlabel("Époque")
plt.ylabel("RMSE")
plt.axis([0, n_epochs, 0, 3.5])
plt.grid()
plt.show()

Pourquoi régulariser?

Une perte appropriée et des mises à jour efficaces peuvent quand même produire du surapprentissage (overfitting).

  • La perte d’entraînement mesure l’ajustement aux exemples fournis.
  • La performance de validation aide à choisir des modèles qui généralisent.
  • Une régularisation plus forte peut aussi causer du sous-apprentissage (underfitting).

Arrêt précoce

Comment transformer la courbe de validation en règle d’arrêt?

Surveiller une mesure de validation. Arrêter après un nombre choisi d’époques sans amélioration significative, puis récupérer les meilleurs paramètres.

Arrêter et restaurer les meilleurs paramètres

Pour un modèle Keras compilé, avec des données d’entraînement et de validation préparées :

early_stopping = keras.callbacks.EarlyStopping(
    monitor="val_loss", patience=5, restore_best_weights=True)
    
model.fit(X_train, y_train, validation_data=(X_valid, y_valid),
          epochs=100, callbacks=[early_stopping])

Ajouter une pénalité à la fonction objectif

Au-delà du moment d’arrêt, peut-on influencer les solutions privilégiées par l’entraînement?

J_{\mathrm{reg}}(W,b)=J_{\mathrm{data}}(W,b)+\Omega(W).

La perte des données correspond à la tâche de prédiction. La pénalité décourage certaines configurations des poids.

Comment mesurer la taille des poids?

Ces deux vecteurs de poids recevraient-ils la même pénalité?

Poids Somme des valeurs absolues Somme des carrés
(4,0) 4 16
(2,2) 4 8

L1 utilise \|\mathbf w\|_1=\sum_j|w_j|; la pénalité L2 habituelle utilise \|\mathbf w\|_2^2=\sum_j w_j^2.

Régularisation \ell_1 et \ell_2

Soit \mathbf w le vecteur de tous les poids. Les coefficients non négatifs \lambda_1 et \lambda_2 contrôlent les pénalités; zéro désactive le terme correspondant.

J_{\mathrm{reg}}=J_{\mathrm{data}}(W,b) +\lambda_1\|\mathbf w\|_1 +\frac{\lambda_2}{2}\|\mathbf w\|_2^2.

Réduction des coefficients et parcimonie

  • Régularisation \ell_1 :
    • Favorise la parcimonie (sparsity); des solveurs appropriés peuvent fixer des coefficients exactement à zéro.
    • Peut permettre la sélection d’attributs, surtout dans les modèles linéaires.
  • Régularisation \ell_2 :
    • Favorise des poids petits et répartis pour la stabilité.
    • Réduit collectivement les poids et conserve habituellement une solution dense.

Quels coefficients disparaissent vraiment?

Afficher le code
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_regression
from sklearn.linear_model import LinearRegression, Ridge, Lasso
from sklearn.preprocessing import StandardScaler

X, y, true_coef = make_regression(n_samples=200, n_features=15, n_informative=3,
                                 noise=10.0, coef=True, random_state=42)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# Exprimer les coefficients connus dans les mêmes coordonnées que les modèles ajustés.
true_coef_scaled = true_coef * scaler.scale_
coefficient_models = {
    'OLS': LinearRegression().fit(X_scaled, y),
    'Ridge (L2)': Ridge(alpha=10.0).fit(X_scaled, y),
    'Lasso (L1)': Lasso(alpha=10.0).fit(X_scaled, y)
}

series = [('Vrai', true_coef_scaled)] + [
    (name, fitted.coef_) for name, fitted in coefficient_models.items()
]
colors = ['#555555', '#377eb8', '#e68613', '#319354']
groups = [
    (true_coef != 0, 'Attributs informatifs'),
    (true_coef == 0, 'Attributs non pertinents : échelle agrandie')
]
fig, axes = plt.subplots(2, 1, figsize=(11, 4.8))
for ax, (mask, title) in zip(axes, groups):
    feature_indices = np.flatnonzero(mask)
    positions = np.arange(len(feature_indices))
    for offset, ((name, values), color) in enumerate(zip(series, colors)):
        x_positions = positions + (offset-1.5)*0.2
        nonzero = np.count_nonzero(values)
        ax.bar(x_positions, values[mask], width=0.2, color=color,
               label=f'{name} : {nonzero}/15 non nuls')
        zeros = values[mask] == 0
        ax.scatter(x_positions[zeros], values[mask][zeros], s=35,
                   facecolors='white', edgecolors=color, zorder=4)
    ax.set(xticks=positions, xticklabels=feature_indices, xlabel="Indice d'attribut",
           ylabel='Coefficient standardisé', title=title)
    ax.axhline(0, color='black', linewidth=0.7)
    ax.grid(axis='y', alpha=0.2)
handles, labels = axes[0].get_legend_handles_labels()
fig.legend(handles, labels, loc='upper center', ncol=2)
fig.text(0.5, 0.01, 'Les cercles ouverts marquent les zéros exacts; les panneaux ont des échelles verticales distinctes.',
         ha='center')
fig.tight_layout(rect=(0, 0.035, 1, 0.91))
plt.show()

Ajouter L2 dans Keras

import keras

l2 = 0.001
regularizer = keras.regularizers.L2(l2 / 2)
dense = keras.layers.Dense(50, kernel_regularizer=regularizer)

Et si certaines activations étaient indisponibles?

Supprimer temporairement des activations cachées pourrait-il aider un modèle à généraliser?

  • Le dropout met aléatoirement certaines activations à zéro pendant l’entraînement.
  • Objectif : réduire le surapprentissage en décourageant la dépendance à la disponibilité permanente d’unités particulières.

Pourquoi redimensionner les activations conservées?

Une activation vaut 4 avant le dropout et est supprimée la moitié du temps. Quelle est sa valeur moyenne après le dropout?

Résultat Sans mise à l’échelle Avec mise à l’échelle
Supprimée (la moitié du temps) 0 0
Conservée (la moitié du temps) 4 8
Moyenne 2 4

Pour un taux de dropout p, diviser chaque activation conservée par 1-p.

Entraînement et inférence

Faut-il encore supprimer des activations lorsque le modèle entraîné fait des prédictions?

Mode Supprimer des activations? Redimensionner les activations conservées?
Entraînement Oui, au taux p Oui, par 1/(1-p)
Inférence Non Non

Dropout dans le modèle Fashion-MNIST

import keras
from keras.models import Sequential
from keras.layers import InputLayer, Dropout, Flatten, Dense

model = keras.Sequential([
    InputLayer(shape=[28, 28]),
    Flatten(),
    Dropout(rate=0.2),
    Dense(300, activation="relu"),
    Dropout(rate=0.2),
    Dense(100, activation="relu"),
    Dropout(rate=0.2),
    Dense(10, activation="softmax")
])

Poursuite de l’apprentissage et rétention

Inférence et poursuite de l’apprentissage

Le modèle fonctionne bien. Peut-il continuer à apprendre de nouveaux exemples sans perdre ses capacités antérieures?

  • Inférence : calculer des prédictions avec les paramètres actuels.
  • Poursuite de l’apprentissage : mettre à jour les paramètres par un processus d’entraînement explicite.
  • Évaluer les mises à jour sur les capacités antérieures autant que sur les nouvelles données.

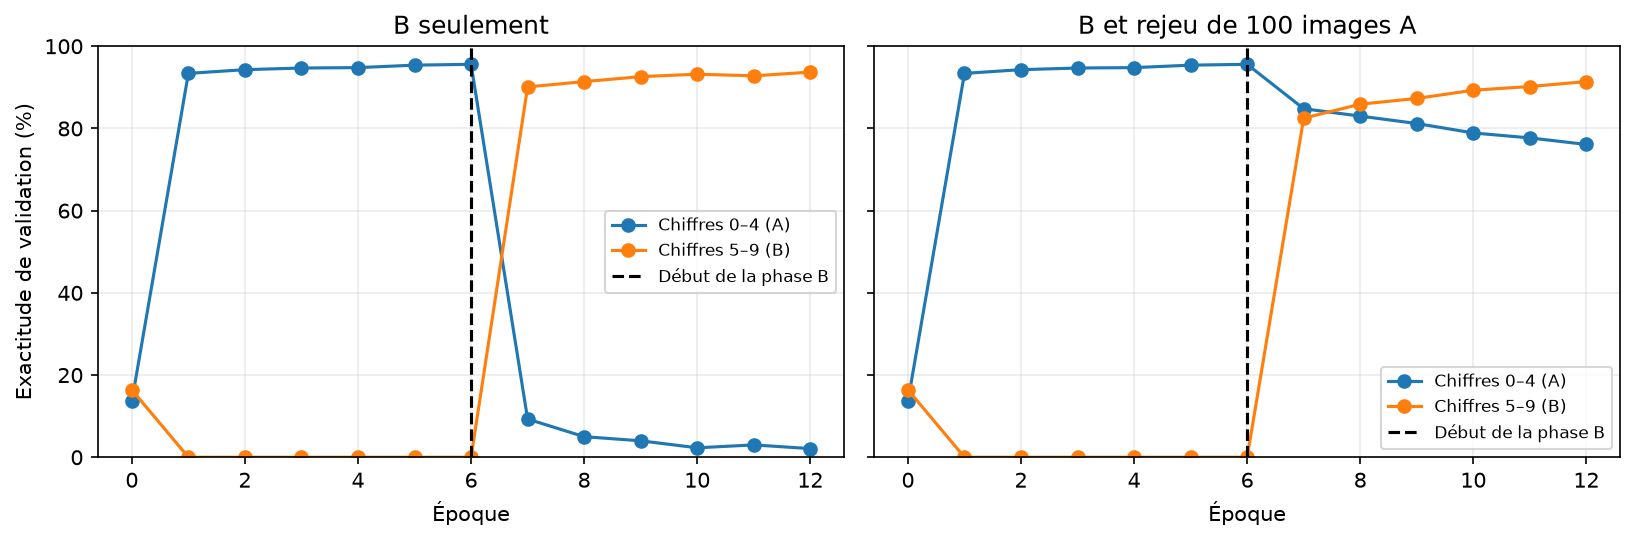
Apprendre B préservera-t-il la capacité A?

Phase Données d’entraînement Évaluation ensuite
A Chiffres MNIST 0–4 Les deux groupes
B Chiffres MNIST 5–9 Les deux groupes

Conserver les dix mêmes classes de sortie et les étiquettes d’origine pendant toute l’expérience.

Après la phase B, que prévoyez-vous pour l’exactitude sur les chiffres 0–4?

Que sont devenues les classes antérieures?

Exactitude au test dans l’exécution MNIST consignée :

Point de sauvegarde Chiffres 0–4 (A) Chiffres 5–9 (B)
Après A 97.0 % 0.0 %
Après B seulement 2.3 % 93.8 %

Quels exemples étaient absents de la phase B? Comment réintroduire une partie de cette information?

Oubli catastrophique (catastrophic forgetting) : poursuivre l’entraînement peut réduire fortement la performance sur des tâches antérieures.

Une petite mémoire pourrait-elle aider?

Que changerait l’inclusion d’anciens exemples dans certaines mises à jour de la phase B?

Épilogue

Résumé

  • Optimisation : un gradient local correct ne garantit pas un entraînement réussi.
  • Propagation des gradients : activation, initialisation, écrêtage et taille des mises à jour répondent à différentes difficultés.
  • Sorties et pertes : choisir ensemble la représentation de sortie et l’objectif; distinguer logits, probabilités et étiquettes de classe.
  • Généralisation : L1/L2, dropout et arrêt précoce peuvent aider; évaluer leur intensité avec la validation.
  • Rétention : poursuivre l’entraînement peut causer de l’oubli; évaluer les acquis et envisager le rejeu d’exemples.
  • Implémentation : SimpleMLP conserve la structure de rétropropagation tout en ajoutant des choix d’entraînement.

Prochaine présentation

Pour les images, une architecture pourrait-elle exploiter la structure spatiale plutôt que traiter toutes les connexions d’entrée de la même manière?

  • Les réseaux de neurones convolutifs répondent à cette question d’architecture.

Références

Géron, Aurélien. 2022. Hands-on Machine Learning with Scikit-Learn, Keras, and TensorFlow. 3ᵉ éd. O’Reilly Media, Inc.
Glorot, Xavier, et Yoshua Bengio. 2010. « Understanding the difficulty of training deep feedforward neural networks ». In Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics, édité par Yee Whye Teh et Mike Titterington, vol. 9. Proceedings of Machine Learning Research. PMLR. https://proceedings.mlr.press/v9/glorot10a.html.
Hinton, Geoffrey E., Nitish Srivastava, Alex Krizhevsky, Ilya Sutskever, et Ruslan Salakhutdinov. 2012. « Improving neural networks by preventing co-adaptation of feature detectors ». CoRR abs/1207.0580. http://arxiv.org/abs/1207.0580.
Krizhevsky, Alex, Ilya Sutskever, et Geoffrey E Hinton. 2012. « ImageNet Classification with Deep Convolutional Neural Networks ». In Advances in Neural Information Processing Systems, édité par F. Pereira, C. J. Burges, L. Bottou, et K. Q. Weinberger, vol. 25. Curran Associates, Inc. https://proceedings.neurips.cc/paper_files/paper/2012/file/c399862d3b9d6b76c8436e924a68c45b-Paper.pdf.
LeCun, Yann, Yoshua Bengio, et Geoffrey Hinton. 2015. « Deep learning ». Nature 521 (7553): 436‑44. https://doi.org/10.1038/nature14539.
Rumelhart, David E., Geoffrey E. Hinton, et Ronald J. Williams. 1986. « Learning representations by back-propagating errors ». Nature 323 (6088): 533‑36. https://doi.org/10.1038/323533a0.
Russell, Stuart, et Peter Norvig. 2020. Artificial Intelligence: A Modern Approach. 4ᵉ éd. Pearson. http://aima.cs.berkeley.edu/.

Annexe : étendre l’implémentation

De SimplerMLP à SimpleMLP

Quels choix exigent de modifier le code et où interviennent-ils dans les calculs?

Composante SimplerMLP (présentation 13) SimpleMLP
Activation cachée Sigmoïde Sigmoïde ou ReLU
Initialisation Glorot He pour ReLU; Glorot pour sigmoïde
Sortie Probabilité sigmoïde Probabilité sigmoïde
Taux d’apprentissage Constant Constant ou décroissance exponentielle
Perte BCE moyenne BCE moyenne et L2 facultative
Dropout Aucun Facultatif; même taux pour toutes les couches cachées
Ordre des exemples Mélange à chaque époque Mélange facultatif, activé par défaut
Valeurs conservées Activations et préactivations Aussi les masques de dropout redimensionnés
API de prédiction et d’entraînement Mêmes méthodes Mêmes méthodes

SimpleMLP

Afficher le code
import numpy as np

def sigmoid(z):
    return 1.0 / (1.0 + np.exp(-z))

def sigmoid_prime(z):
    a = sigmoid(z)
    return a * (1.0 - a)

def bce_loss(y_true, y_prob, eps=1e-9):
    """Entropie croisée binaire moyennée sur les exemples."""
    p = np.clip(y_prob, eps, 1 - eps)
    return -np.mean(y_true * np.log(p) + (1 - y_true) * np.log(1 - p))

def xavier_init(rng, fan_in, fan_out):
    std = np.sqrt(2.0 / (fan_in + fan_out))
    return rng.normal(0.0, std, size=(fan_in, fan_out))

def relu(z):
    return np.maximum(0.0, z)

def relu_prime(z):
    return (z > 0).astype(float)

def he_init(rng, fan_in, fan_out):
    std = np.sqrt(2.0 / fan_in)
    return rng.normal(0.0, std, size=(fan_in, fan_out))

class SimpleMLP:
    """MLP binaire avec choix d'activation cachée, L2, dropout et décroissance du taux."""

    def __init__(self, layer_sizes, lr=0.1, seed=None, l2=0.0,
                 hidden_activation="relu", lr_decay=None, dropout_rate=0.0):
        self.sizes = list(layer_sizes)
        self.lr = float(lr)
        self.base_lr = float(lr)
        self.l2 = float(l2)
        self.hidden_activation = hidden_activation
        self.lr_decay = lr_decay
        self.dropout_rate = float(dropout_rate)
        self.rng = np.random.default_rng(seed)

        self.W = []
        L = len(self.sizes) - 1
        for l, (din, dout) in enumerate(zip(self.sizes[:-1], self.sizes[1:]), start=1):
            if l < L and self.hidden_activation == "relu":
                Wk = he_init(self.rng, din, dout)
            else:
                Wk = xavier_init(self.rng, din, dout)
            self.W.append(Wk)
        self.b = [np.zeros(dout) for dout in self.sizes[1:]]

    def _act(self, z, last=False):
        if last:
            return sigmoid(z)
        return relu(z) if self.hidden_activation == "relu" else sigmoid(z)

    def _act_prime(self, z, last=False):
        if last:
            return sigmoid_prime(z)
        return relu_prime(z) if self.hidden_activation == "relu" else sigmoid_prime(z)

    def forward(self, X):
        a = X
        L = len(self.W)
        for l, (W, b) in enumerate(zip(self.W, self.b), start=1):
            a = self._act(a @ W + b, last=(l == L))
        return a.ravel()

    def predict_proba(self, X):
        return self.forward(X)

    def predict(self, X, threshold=0.5):
        return (self.predict_proba(X) >= threshold).astype(int)

    def loss(self, X, y):
        """Rapporter la BCE moyenne et L2, sans dropout."""
        p = self.predict_proba(X)
        base = bce_loss(y, p)
        if self.l2 > 0:
            base += 0.5 * self.l2 * sum((W ** 2).sum() for W in self.W)
        return base

    def _forward_full(self, X):
        a = X
        activations = [a]
        zs = []
        dropout_masks = []
        L = len(self.W)
        for l, (W, b) in enumerate(zip(self.W, self.b), start=1):
            z = a @ W + b
            a = self._act(z, last=(l == L))

            # Masque identité pour la sortie et lorsque le dropout est désactivé.
            mask = np.ones_like(a)
            if l < L and self.dropout_rate > 0:
                keep_prob = 1.0 - self.dropout_rate
                mask = (self.rng.random(a.shape) >= self.dropout_rate) / keep_prob
                a = a * mask

            zs.append(z)
            activations.append(a)
            dropout_masks.append(mask)
        return activations, zs, dropout_masks

    def train(self, X, y, epochs=30, batch_size=None, verbose=True, shuffle=True):
        """X : (N, d), y : (N,); batch_size=None utilise toutes les données."""
        N = X.shape[0]
        idx = np.arange(N)
        B = N if batch_size is None else int(batch_size)

        for ep in range(1, epochs + 1):
            if shuffle:
                self.rng.shuffle(idx)
            if self.lr_decay is not None:
                self.lr = self.base_lr * self.lr_decay ** (ep - 1)

            base_loss = self.loss(X, y)

            for start in range(0, N, B):
                sl = idx[start:start + B]
                Xb = X[sl]
                yb = y[sl].reshape(-1, 1)
                Bsz = Xb.shape[0]

                activations, zs, dropout_masks = self._forward_full(Xb)
                A_L = activations[-1]

                # Chaque ligne est la sensibilité aux préactivations pour un exemple.
                delta = A_L - yb
                grads_W = [None] * len(self.W)
                grads_b = [None] * len(self.b)

                # Moyenner une seule fois les gradients des paramètres sur les exemples.
                grads_W[-1] = activations[-2].T @ delta / Bsz
                grads_b[-1] = delta.mean(axis=0)

                for k in range(len(self.W) - 2, -1, -1):
                    z = zs[k]
                    d_act = self._act_prime(z, last=False)
                    delta = delta @ self.W[k + 1].T
                    delta = delta * dropout_masks[k]
                    delta = delta * d_act
                    grads_W[k] = activations[k].T @ delta / Bsz
                    grads_b[k] = delta.mean(axis=0)

                if self.l2 > 0:
                    for k in range(len(self.W)):
                        grads_W[k] += self.l2 * self.W[k]

                # Tous les gradients utilisent les poids du même passage avant.
                for k in range(len(self.W)):
                    self.W[k] -= self.lr * grads_W[k]
                    self.b[k] -= self.lr * grads_b[k]

            new_loss = self.loss(X, y)
            if verbose:
                print(f"Époque {ep:3d} | perte {base_loss:.5f} -> {new_loss:.5f} | taux={self.lr:.4f}")
Choisir les activations cachées

Si l’activation du passage avant change, quelle dérivée locale le passage arrière doit-il utiliser?

    def _act(self, z, last=False):
        if last:
            return sigmoid(z)
        return relu(z) if self.hidden_activation == "relu" else sigmoid(z)

    def _act_prime(self, z, last=False):
        if last:
            return sigmoid_prime(z)
        return relu_prime(z) if self.hidden_activation == "relu" else sigmoid_prime(z)

L2 dans l’objectif et le gradient

J_{\mathrm{reg}}=J_{\mathrm{BCE}}+ \frac{\lambda}{2}\sum_{l=1}^{L}\|W^{(l)}\|_F^2.

base += 0.5 * self.l2 * sum((W ** 2).sum() for W in self.W)

# Après le calcul des gradients moyens de la perte des données :
grads_W[k] += self.l2 * self.W[k]

Dropout aux passages avant et arrière

Quelle dérivée locale supplémentaire le dropout introduit-il?

Pendant le passage avant d’entraînement, pour une couche cachée :

keep_prob = 1.0 - self.dropout_rate
mask = (self.rng.random(a.shape) >= self.dropout_rate) / keep_prob
a = a * mask

Pendant le passage arrière, réutiliser le masque redimensionné conservé :

delta = delta * dropout_masks[k]

Activer avec dropout_rate=0.2; la valeur par défaut zéro désactive le dropout.

Même API, modèle étendu

from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import accuracy_score

X, y = make_circles(n_samples=200, factor=0.5, noise=0.08, random_state=1)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y)

scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

model = SimpleMLP([2, 4, 4, 1], lr=0.3, seed=42,
                  hidden_activation="relu", l2=0.001, lr_decay=0.995)
model.train(X_train, y_train, epochs=500, batch_size=32, verbose=False)

print("Exactitude entraînement :", accuracy_score(y_train, model.predict(X_train)))
print(" Exactitude test :", accuracy_score(y_test, model.predict(X_test)))
Exactitude entraînement : 1.0
 Exactitude test : 1.0

Calculer softmax de manière stable

Soustraire le plus grand logit préserve les probabilités et évite d’exponentier de grandes valeurs positives.

Afficher le code
import numpy as np

logits = np.array([1000.0, 1001.0, 999.0])
exp_scores = np.exp(logits-logits.max())
probabilities = exp_scores/exp_scores.sum()
print('Probabilités :', probabilities.round(4))
print('Somme :', probabilities.sum())
Probabilités : [0.2447 0.6652 0.09  ]
Somme : 0.9999999999999999

Marcel Turcotte

[email protected]

École de génie électrique et d’informatique (GÉI)

Université d’Ottawa