Architectures de réseaux de neurones

CSI 4506 - automne 2026

Marcel Turcotte

Version: 4 sept. 2026 17h02

Préambule

Message du jour

Résultats d’apprentissage

À la fin de ce cours, vous devriez pouvoir :

  • expliquer comment la connectivité locale et le partage des paramètres confèrent un biais inductif aux réseaux convolutifs et réduisent le nombre de paramètres ;
  • calculer et suivre le passage avant d’une couche convolutive 1D comportant plusieurs canaux d’entrée, noyaux, biais et activations ;
  • déterminer comment la taille du noyau, le remplissage, le pas et le pooling influencent la forme de la sortie, le comportement aux frontières et l’information de position conservée ;
  • expliquer comment l’empilement des couches compose les attributs, agrandit les champs récepteurs et alimente une tête de prédiction ;
  • distinguer l’équivariance par translation de l’invariance, notamment les rôles de la convolution et de l’agrégation des positions.

Réseau de neurones convolutif (CNN)

Motivation

« Un MLP comportant une seule couche cachée peut théoriquement modéliser même les fonctions les plus complexes, pourvu qu’il contienne suffisamment de neurones. Cependant, pour les problèmes complexes, les réseaux profonds utilisent leurs paramètres de façon beaucoup plus efficace que les réseaux peu profonds : ils peuvent modéliser des fonctions complexes avec un nombre exponentiellement inférieur de neurones, et ainsi obtenir de bien meilleures performances avec la même quantité de données d’entraînement. »

Motivation (suite)

  • Considérons une image RVB de dimensions \(224 \times 224\), relativement petite selon les normes actuelles.
  • Elle contient \(224 \times 224 \times 3 = 150\,528\) attributs d’entrée.
  • Un réseau ne comportant qu’une seule couche cachée dense nécessiterait plus de 22 658 678 784 (22 milliards) de paramètres, ce qui illustre l’ampleur du calcul.

Concepts

Notre discussion portera sur les concepts clés suivants.

  • Biais inductif et hypothèses topologiques
  • Connectivité locale et interactions clairsemées
  • Partage des paramètres et équivariance
  • Composition hiérarchique des attributs
  • Équivariance par translation et invariance par agrégation des positions

Traitement classique des images

Intuition et contexte historique en 2D

  • Le traitement classique des images 2D établit la motivation avant d’introduire la méthode sous-jacente.
  • Il distingue l’intuition visuelle des opérations matricielles.

Un noyau parcourt une image

Afficher le code
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.colors import Normalize
from matplotlib.patches import Rectangle
from PIL import Image

SAMPLE_RATE = 50

BLUE = "#0072B2"
ORANGE = "#D55E00"
GREEN = "#009E73"
PURPLE = "#CC79A7"
GRAY = "#5B6573"
LIGHT_GRAY = "#D8DCE2"
HIGHLIGHT = "#F0E442"

plt.rcParams.update({
    "axes.spines.top": False,
    "axes.spines.right": False,
    "axes.titleweight": "bold",
    "axes.labelsize": 12,
    "axes.titlesize": 14,
    "font.size": 12,
    "legend.frameon": False,
    "lines.linewidth": 2.2,
})

# Petit extrait en format long des fichiers de signaux inertiels UCI HAR.
data_path = Path("data/uci_har_prototype.csv")
signals = pd.read_csv(data_path)

walking = (
    signals.loc[signals["activity"] == "walking"]
    .sort_values("sample")
    .reset_index(drop=True)
)
sitting = (
    signals.loc[signals["activity"] == "sitting"]
    .sort_values("sample")
    .reset_index(drop=True)
)

time = walking["sample"].to_numpy() / SAMPLE_RATE
x_walking = walking["x"].to_numpy()


def style_time_axis(ax, *, xlabel=False, ylabel=None, ylim=None):
    """Appliquer un style visuel commun aux graphiques de signaux."""
    ax.axhline(0, color=LIGHT_GRAY, linewidth=1, zorder=0)
    ax.grid(axis="x", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)
    ax.set_xlim(time[0], time[-1])
    if ylim is not None:
        ax.set_ylim(*ylim)
    if ylabel:
        ax.set_ylabel(ylabel)
    if xlabel:
        ax.set_xlabel("temps (s)")
    else:
        ax.tick_params(labelbottom=False)
Afficher le code de corrélation croisée
def cross_correlation2d(X, K):
    """Appliquer le noyau 2D tel quel, par corrélation croisée valide."""
    output_rows = X.shape[0] - K.shape[0] + 1
    output_cols = X.shape[1] - K.shape[1] + 1
    Y = np.zeros((output_rows, output_cols), dtype=float)

    for i in range(output_rows):
        for j in range(output_cols):
            total = 0.0
            for u in range(K.shape[0]):
                for v in range(K.shape[1]):
                    total += X[i + u, j + v] * K[u, v]
            Y[i, j] = total

    return Y


def draw_number_matrix(ax, values, title, *, cmap="Greys", vmin=None,
                       vmax=None, text_color=None):
    """Afficher une petite matrice et ses valeurs numériques."""
    ax.imshow(values, cmap=cmap, vmin=vmin, vmax=vmax)
    rows, cols = values.shape
    norm = Normalize(vmin=np.min(values) if vmin is None else vmin,
                     vmax=np.max(values) if vmax is None else vmax)
    color_map = plt.get_cmap(cmap)
    for i in range(rows):
        for j in range(cols):
            value = 0.0 if np.isclose(values[i, j], 0.0) else values[i, j]
            ax.add_patch(Rectangle(
                (j - 0.5, i - 0.5), 1, 1,
                fill=False, edgecolor="#7A7A7A", linewidth=1.6,
            ))
            if text_color is None:
                red, green, blue, _ = color_map(norm(value))
                luminance = 0.2126 * red + 0.7152 * green + 0.0722 * blue
                cell_text_color = "black" if luminance > 0.52 else "white"
            else:
                cell_text_color = text_color
            ax.text(j, i, f"{value:g}", ha="center", va="center",
                    color=cell_text_color, fontsize=17, fontweight="bold")
    ax.set_xticks([])
    ax.set_yticks([])
    ax.set_title(title, pad=12)


X_image = np.array([
    [255, 255, 255, 255],
    [255,   0,   0, 255],
    [255,   0,   0, 255],
    [255, 255, 255, 255],
], dtype=float)

K_edge = np.array([
    [-1, 1],
    [-1, 1],
], dtype=float)

Y_image = cross_correlation2d(X_image, K_edge)
placement_order = np.arange(1, 10).reshape(3, 3)

fig, axes = plt.subplots(
    1, 3,
    figsize=(11.4, 4.4),
    gridspec_kw={"width_ratios": [1.25, 0.78, 1.0]},
)

draw_number_matrix(
    axes[0], X_image, "Image d'entrée $X$", cmap="Greys_r", vmin=0, vmax=255,
)
axes[0].add_patch(Rectangle(
    (-0.5, -0.5), 2, 2,
    facecolor="none", edgecolor=ORANGE, linewidth=4,
))
draw_number_matrix(
    axes[1], K_edge, "Noyau $K$", cmap="RdBu_r", vmin=-1, vmax=1,
)

draw_number_matrix(
    axes[2], placement_order, "Neuf positions valides", cmap="Greys",
    vmin=0, vmax=100,
)

fig.tight_layout(w_pad=2.0)
plt.show()
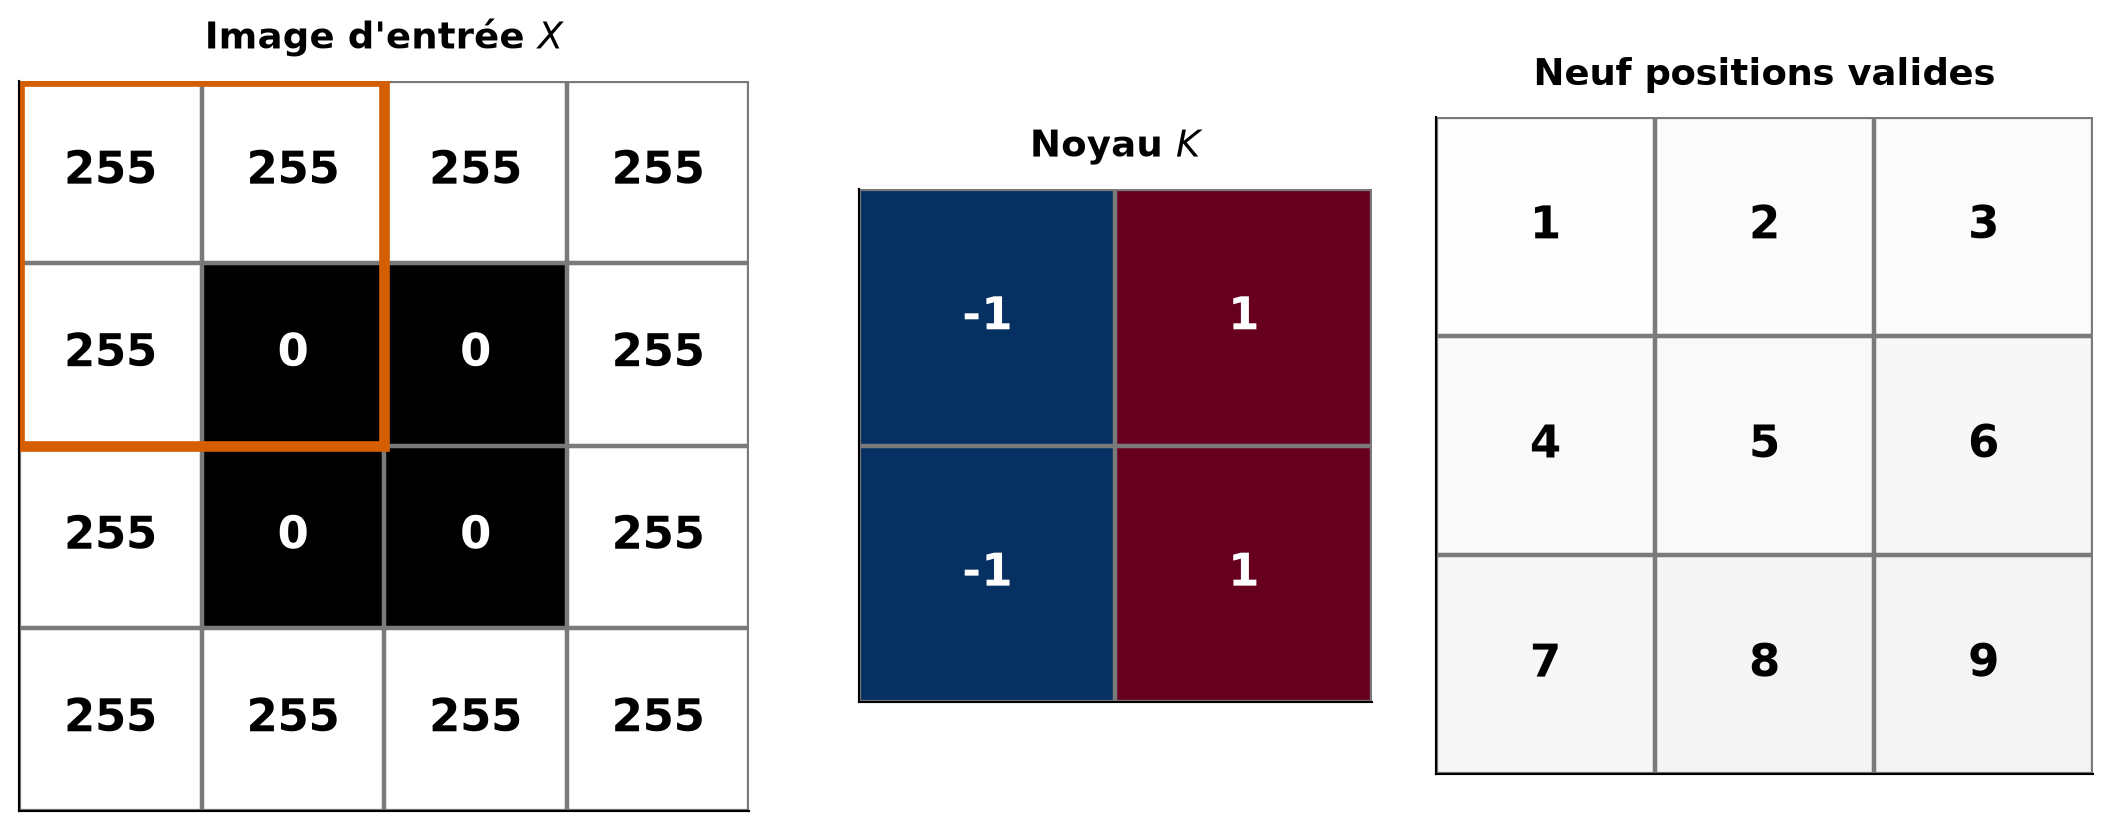
Une image quatre par quatre en niveaux de gris représentant la lettre O, un noyau de contours deux par deux et une carte trois par trois numérotant les neuf positions valides du noyau.

Que calcule chaque position ?

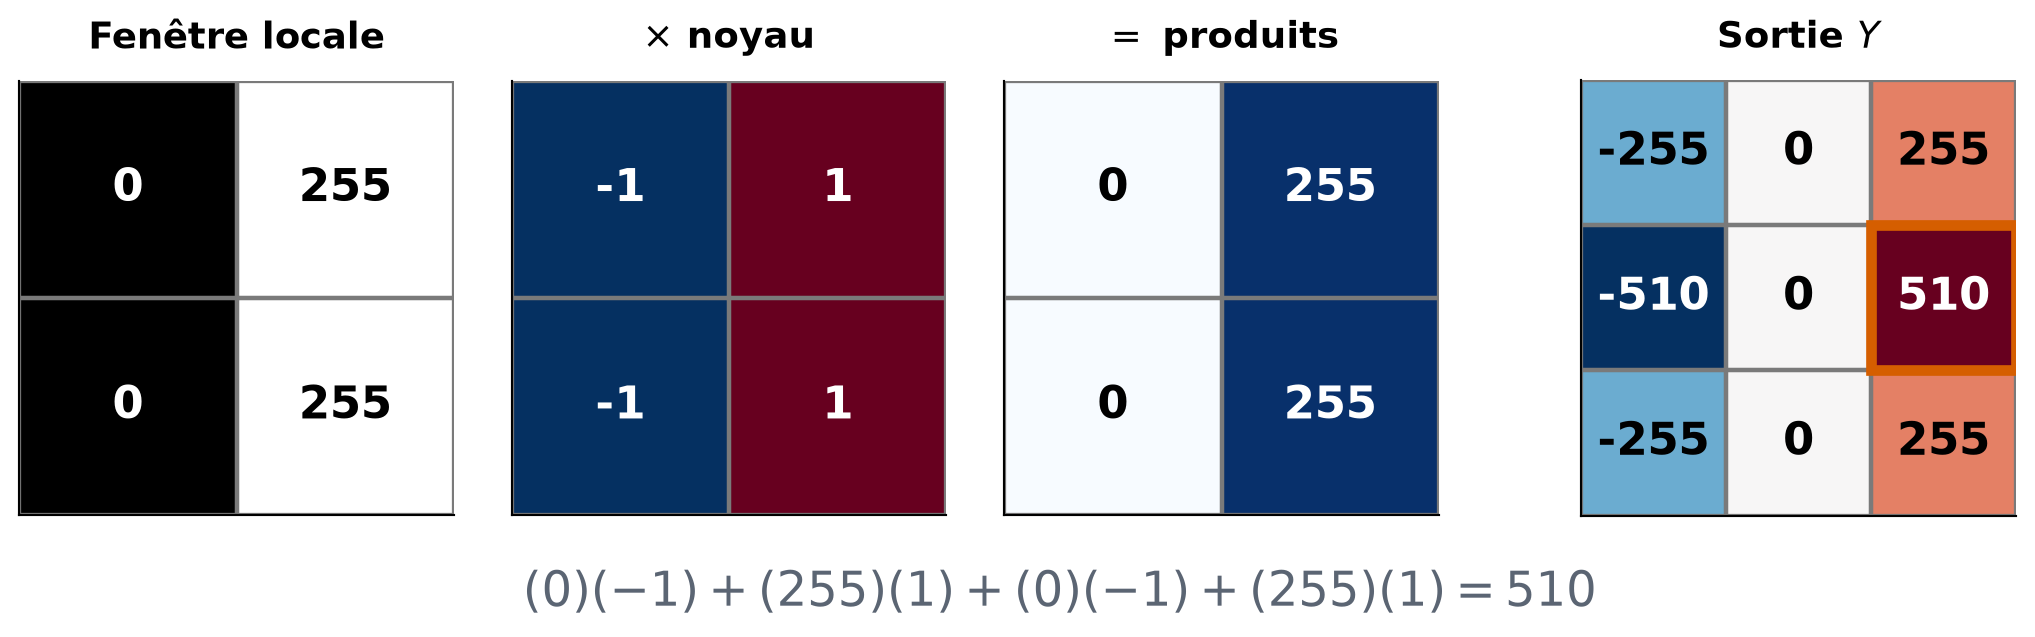
\[ Y[i,j] = \sum_{u=0}^{K_h-1}\sum_{v=0}^{K_w-1} X[i+u,j+v] K[u,v] \]

Afficher le code du calcul
i, j = 1, 2
patch = X_image[i:i + K_edge.shape[0], j:j + K_edge.shape[1]]
products = patch * K_edge

fig, axes = plt.subplots(
    1, 4,
    figsize=(11.2, 3.25),
    gridspec_kw={"width_ratios": [0.9, 0.9, 0.9, 1.25]},
)

draw_number_matrix(axes[0], patch, "Fenêtre locale", cmap="Greys_r", vmin=0, vmax=255)
draw_number_matrix(axes[1], K_edge, r"$\times$ noyau", cmap="RdBu_r", vmin=-1, vmax=1)
draw_number_matrix(axes[2], products, "$=$ produits", cmap="Blues", vmin=0, vmax=255)
draw_number_matrix(axes[3], Y_image, "Sortie $Y$", cmap="RdBu_r", vmin=-510, vmax=510)
axes[3].add_patch(Rectangle(
    (j - 0.5, i - 0.5), 1, 1,
    facecolor="none", edgecolor=ORANGE, linewidth=4,
))

fig.text(
    0.50, 0.02,
    r"$(0)(-1)+(255)(1)+(0)(-1)+(255)(1)=510$",
    ha="center", fontsize=18, color=GRAY,
)
fig.tight_layout(rect=[0, 0.11, 1, 1], w_pad=1.8)
plt.show()

Une fenêtre de l'image et le noyau de contours sont multipliés élément par élément; leur somme, 510, est inscrite à la position correspondante de la sortie.

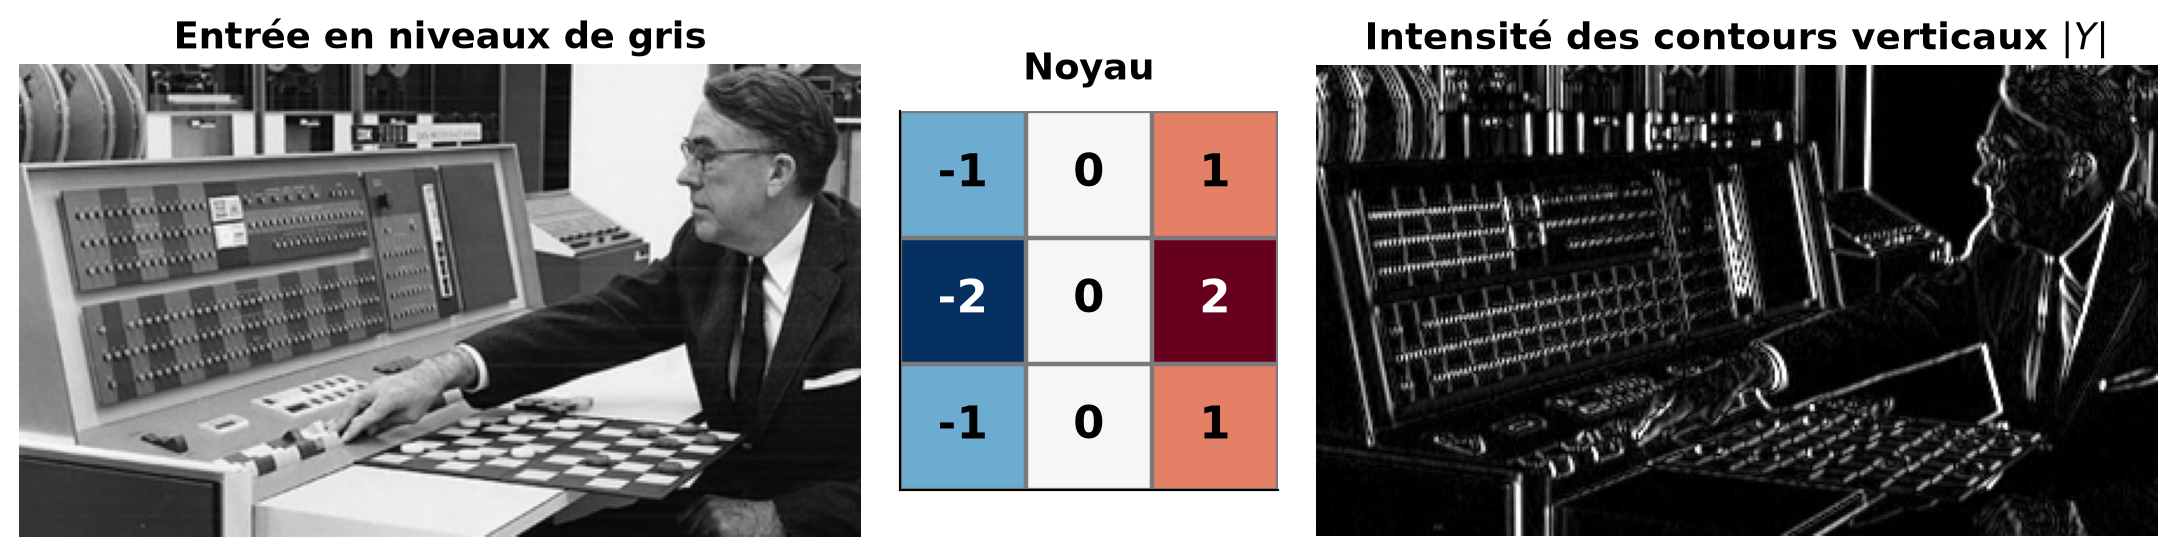
Révéler les contours verticaux

Afficher le code de détection des contours
photo_path = Path("images/ibm_704.jpeg")
photo = Image.open(photo_path).convert("L")
photo.thumbnail((360, 360))
photo_gray = np.asarray(photo, dtype=float) / 255.0

K_vertical = np.array([
    [-1, 0, 1],
    [-2, 0, 2],
    [-1, 0, 1],
], dtype=float)

Y_vertical = cross_correlation2d(photo_gray, K_vertical)
vertical_strength = np.abs(Y_vertical)
vertical_limit = np.percentile(vertical_strength, 99)

fig, axes = plt.subplots(
    1, 3,
    figsize=(11.5, 4.4),
    gridspec_kw={"width_ratios": [1.38, 0.62, 1.38]},
)

axes[0].imshow(photo_gray, cmap="gray", vmin=0, vmax=1)
axes[0].set_title("Entrée en niveaux de gris")
axes[0].axis("off")

draw_number_matrix(
    axes[1], K_vertical, "Noyau",
    cmap="RdBu_r", vmin=-2, vmax=2,
)

axes[2].imshow(
    vertical_strength, cmap="gray", vmin=0, vmax=vertical_limit,
)
axes[2].set_title("Intensité des contours verticaux $|Y|$")
axes[2].axis("off")

fig.tight_layout(w_pad=1.2)
plt.show()

Une photographie en niveaux de gris, un noyau de Sobel qui mesure les changements entre les colonnes et l'image résultante de l'intensité des contours verticaux.

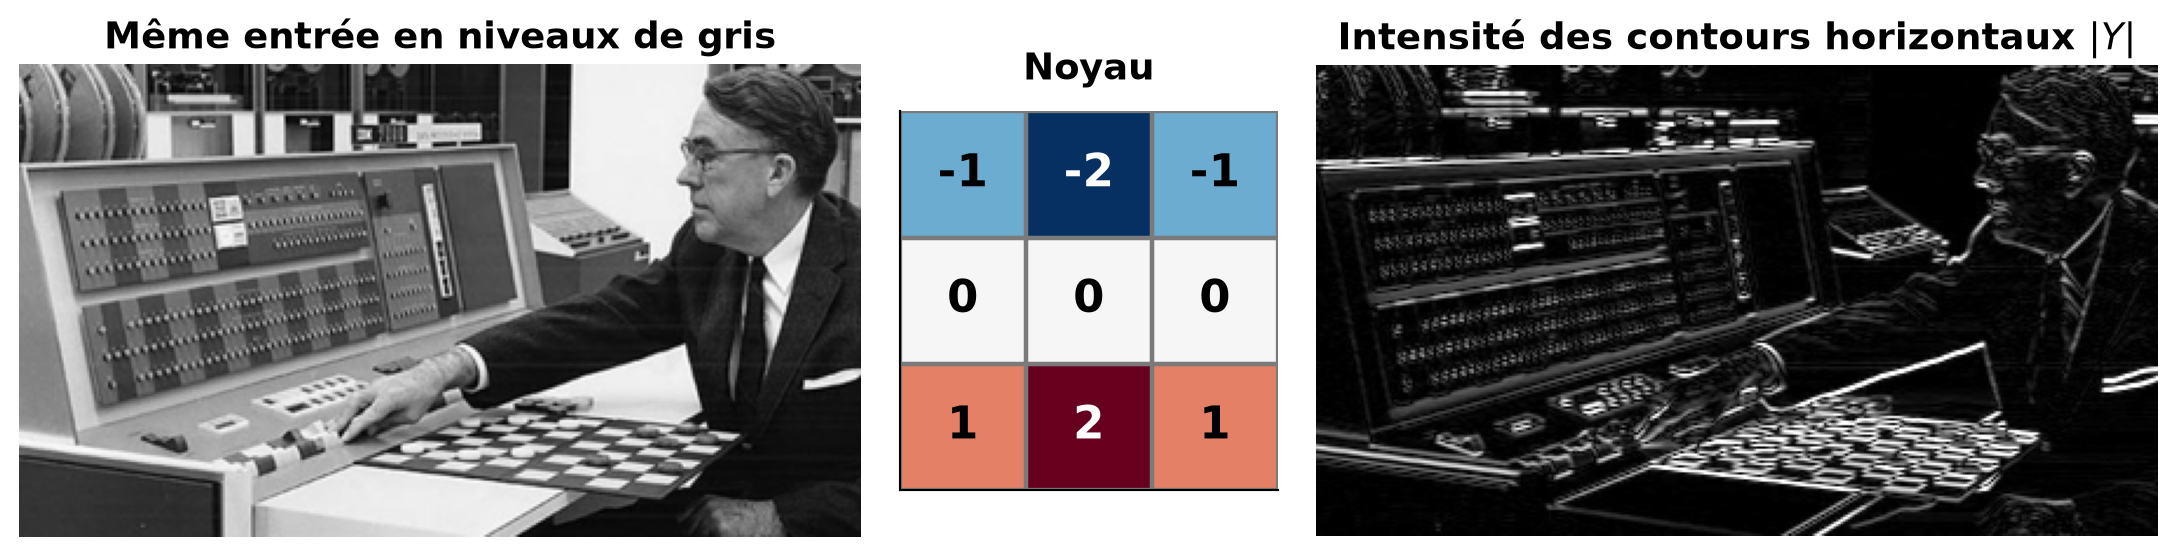
Révéler les contours horizontaux

Afficher le code de détection des contours
K_horizontal = np.array([
    [-1, -2, -1],
    [ 0,  0,  0],
    [ 1,  2,  1],
], dtype=float)

Y_horizontal = cross_correlation2d(photo_gray, K_horizontal)
horizontal_strength = np.abs(Y_horizontal)
horizontal_limit = np.percentile(horizontal_strength, 99)

fig, axes = plt.subplots(
    1, 3,
    figsize=(11.5, 4.4),
    gridspec_kw={"width_ratios": [1.38, 0.62, 1.38]},
)

axes[0].imshow(photo_gray, cmap="gray", vmin=0, vmax=1)
axes[0].set_title("Même entrée en niveaux de gris")
axes[0].axis("off")

draw_number_matrix(
    axes[1], K_horizontal, "Noyau",
    cmap="RdBu_r", vmin=-2, vmax=2,
)

axes[2].imshow(
    horizontal_strength, cmap="gray", vmin=0, vmax=horizontal_limit,
)
axes[2].set_title("Intensité des contours horizontaux $|Y|$")
axes[2].axis("off")

fig.tight_layout(w_pad=1.2)
plt.show()

La même photographie en niveaux de gris, un noyau de Sobel qui mesure les changements entre les lignes et l'image résultante de l'intensité des contours horizontaux.

Idée calculatoire centrale

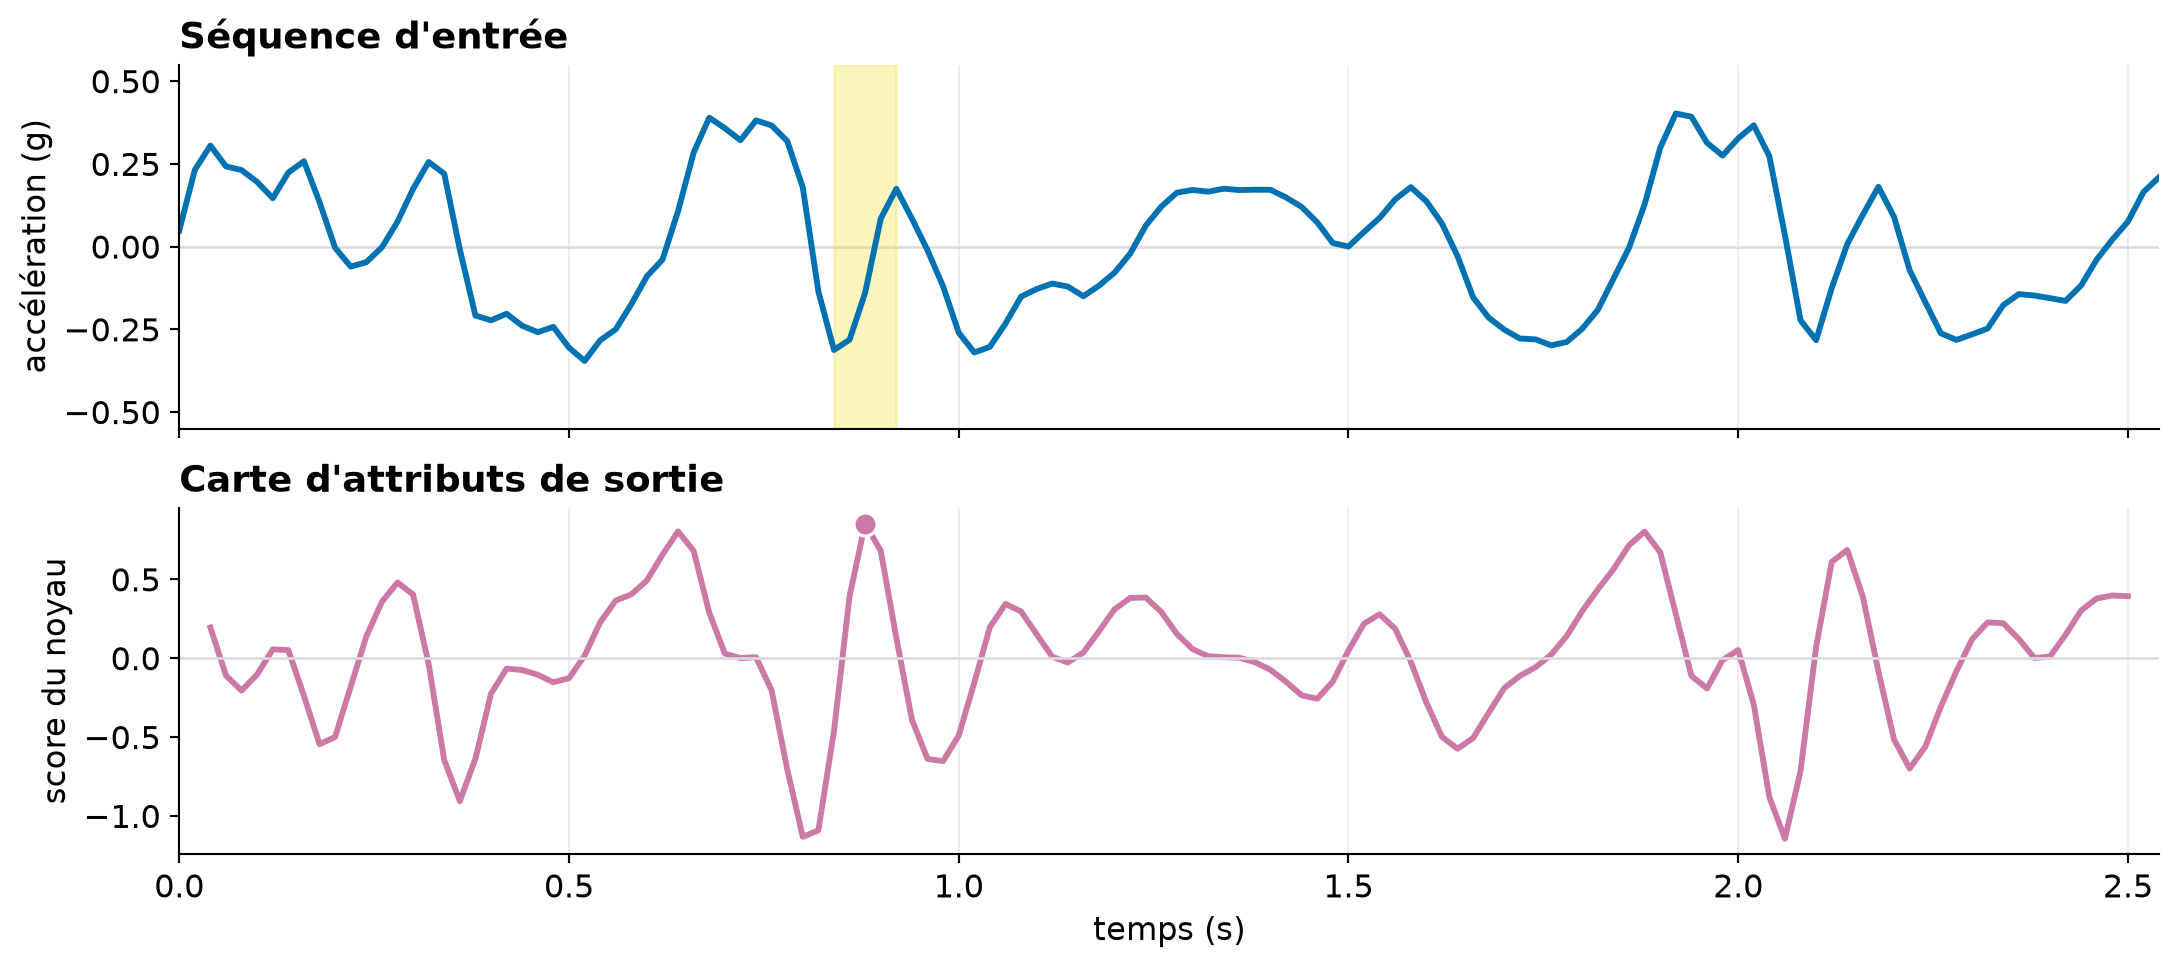
Un petit ensemble de poids (noyau ou filtre) est appliqué à chaque voisinage local; il produit une carte de réponse, ou carte d’attributs, qui indique où le motif recherché apparaît.

Convolution à une dimension

Où trouve-t-on des données 1D ?

Dans quels problèmes les observations sont-elles disposées selon un axe ordonné ?

\[ x[0],\; x[1],\; x[2],\; \ldots,\; x[L-1] \]

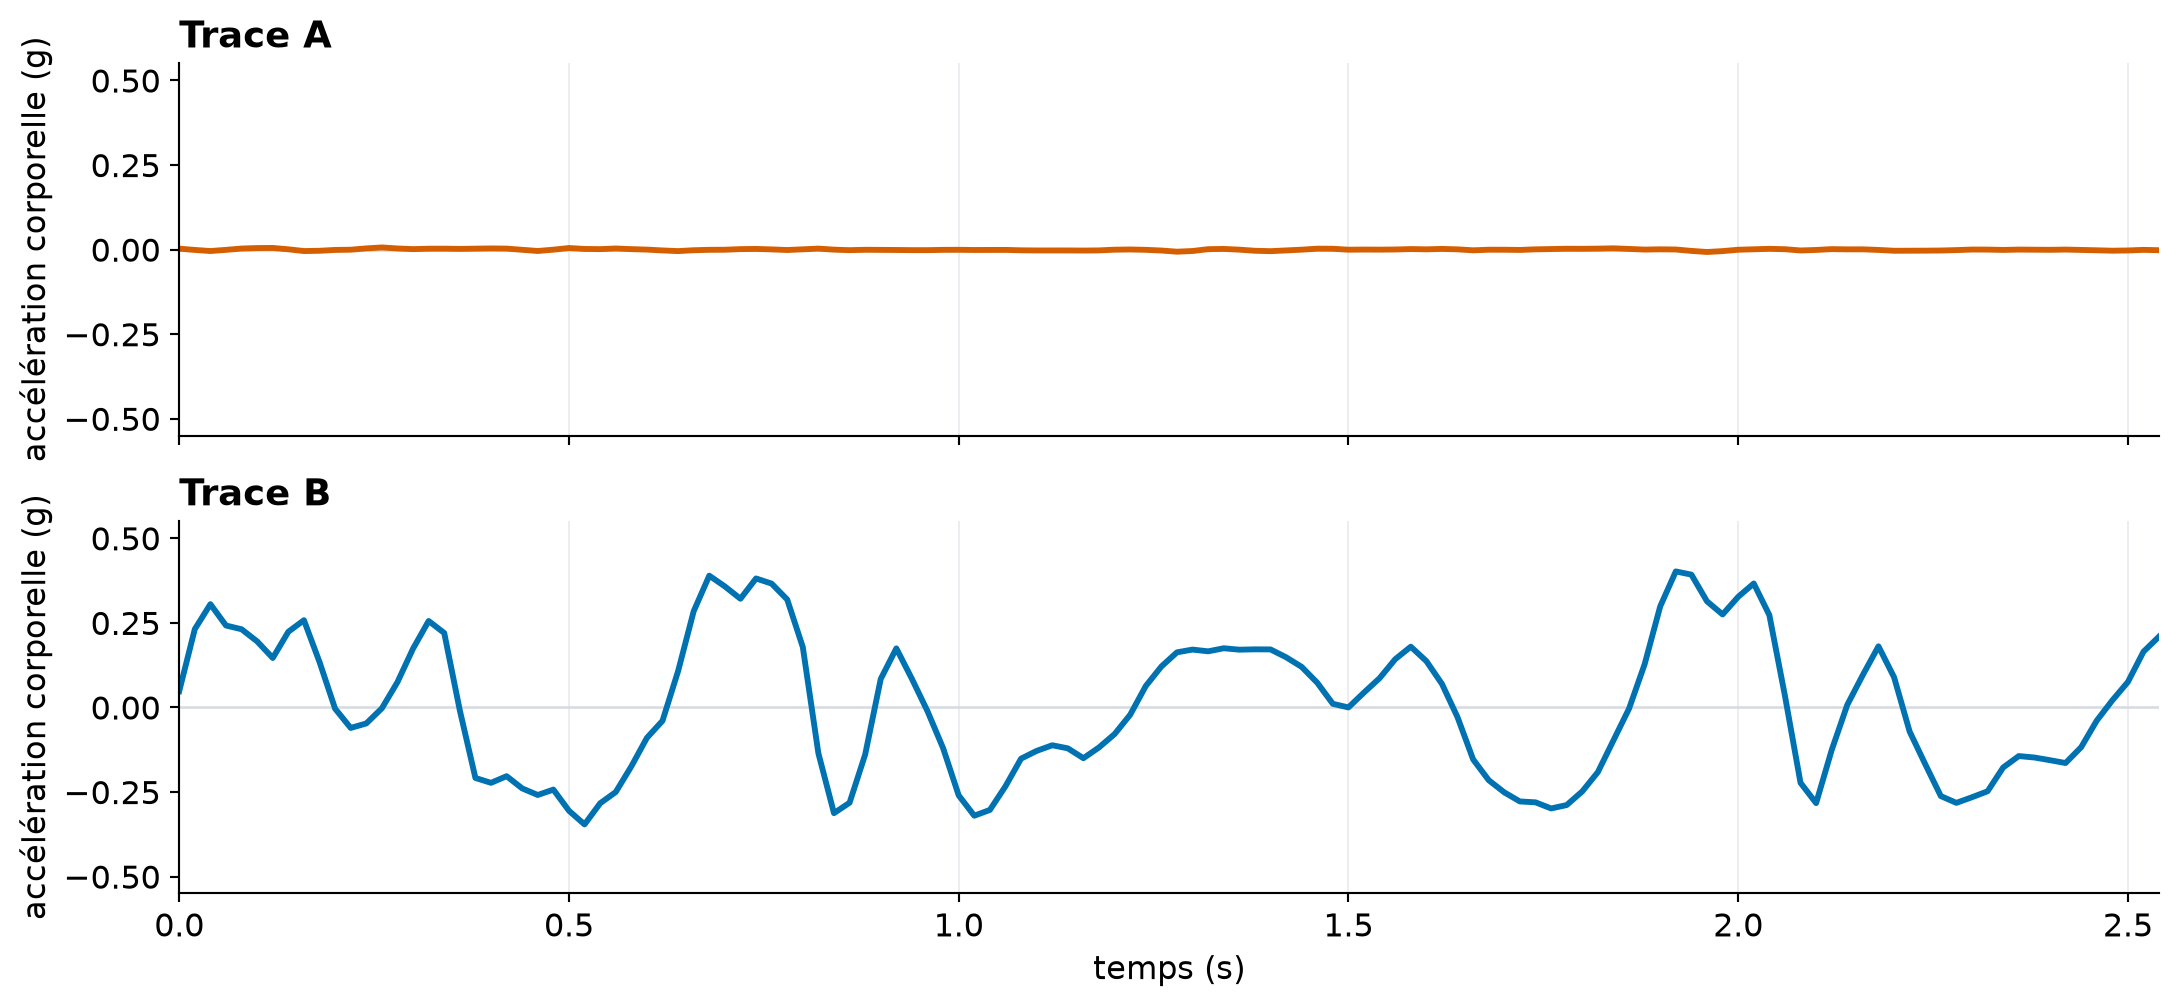
Quelle trace correspond à la marche ?

Afficher le code du graphique
fig, axes = plt.subplots(2, 1, figsize=(11.5, 5.4), sharex=True)

for ax, frame, title, color in [
    (axes[0], sitting, "Trace A", ORANGE),
    (axes[1], walking, "Trace B", BLUE),
]:
    ax.plot(time, frame["x"], color=color)
    ax.set_title(title, loc="left")
    style_time_axis(
        ax,
        xlabel=ax is axes[-1],
        ylabel="accélération corporelle (g)",
        ylim=(-0.55, 0.55),
    )

fig.tight_layout(h_pad=1.0)
plt.show()

Deux traces alignées de l'accélération corporelle : un signal presque plat en position assise et un signal oscillant de plus grande amplitude pendant la marche.

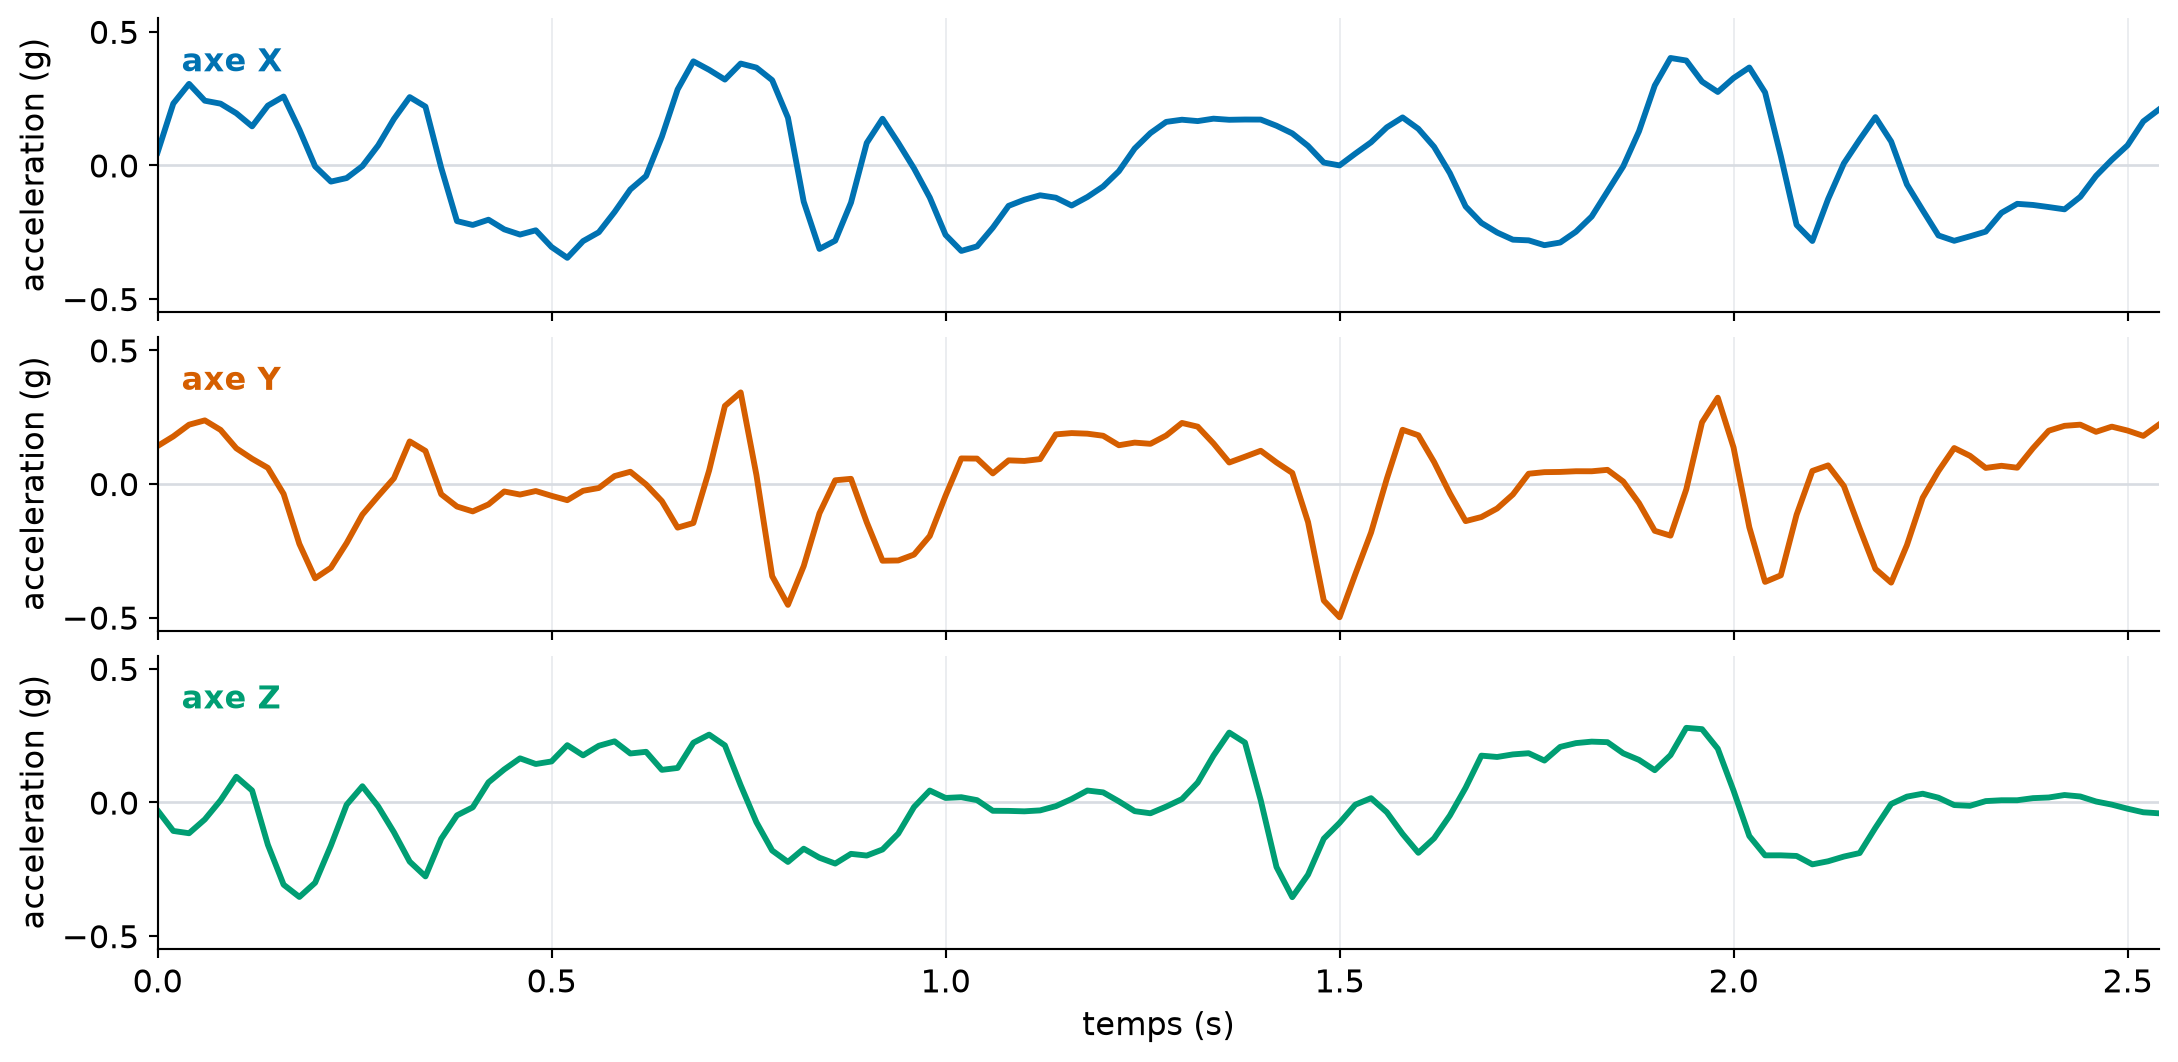
Trois séquences d’un téléphone

Afficher le code du graphique
fig, axes = plt.subplots(3, 1, figsize=(11.5, 5.7), sharex=True)

for ax, channel, color in zip(axes, ["x", "y", "z"], [BLUE, ORANGE, GREEN]):
    ax.plot(time, walking[channel], color=color)
    ax.text(
        0.012,
        0.82,
        f"axe {channel.upper()}",
        transform=ax.transAxes,
        color=color,
        fontweight="bold",
    )
    style_time_axis(
        ax,
        xlabel=ax is axes[-1],
        ylabel="acceleration (g)",
        ylim=(-0.55, 0.55),
    )

fig.tight_layout(h_pad=0.45)
plt.show()

Trois signaux alignés d'accélération corporelle pendant la marche, provenant des axes X, Y et Z d'un téléphone.

Un signal est une suite de nombres

first_values = pd.DataFrame({
    "indice i": walking["sample"].head(8),
    "temps (s)": (walking["sample"].head(8) / SAMPLE_RATE).round(2),
    "x[i] (g)": walking["x"].head(8).round(5),
})
print(first_values.to_string(index=False))
 indice i  temps (s)  x[i] (g)
        0       0.00   0.04796
        1       0.02   0.23134
        2       0.04   0.30507
        3       0.06   0.24206
        4       0.08   0.23098
        5       0.10   0.19504
        6       0.12   0.14604
        7       0.14   0.22359

\[ x[0]=0.04796,\quad x[1]=0.23134,\quad x[2]=0.30507,\quad\ldots \]

Quelles sont les hypothèses ?

  • Les mesures voisines forment des motifs locaux significatifs.
  • Un motif utile peut apparaître à différentes positions.
  • Le même détecteur devrait être réutilisé partout.

Un noyau évalue un contraste local

Afficher le code du graphique
kernel_up = np.array([-1.0, -1.0, 0.0, 1.0, 1.0])
kernel_down = -kernel_up
K = kernel_up.size

# Cette fenêtre traverse zéro; le noyau compare plutôt les niveaux relatifs.
start = 11
stop = start + K

fig, ax = plt.subplots(figsize=(9.0, 3.4))
ax.plot(time, x_walking, color=BLUE)
ax.axvspan(
    time[start],
    time[stop - 1],
    color=HIGHLIGHT,
    alpha=0.35,
    label="fenêtre locale",
)
ax.scatter(
    time[start:stop],
    x_walking[start:stop],
    color=BLUE,
    edgecolor="white",
    linewidth=1.2,
    s=58,
    zorder=3,
)
style_time_axis(
    ax,
    xlabel=True,
    ylabel="accélération corporelle (g)",
    ylim=(-0.55, 0.55),
)
ax.legend(loc="upper right")
fig.tight_layout()
plt.show()

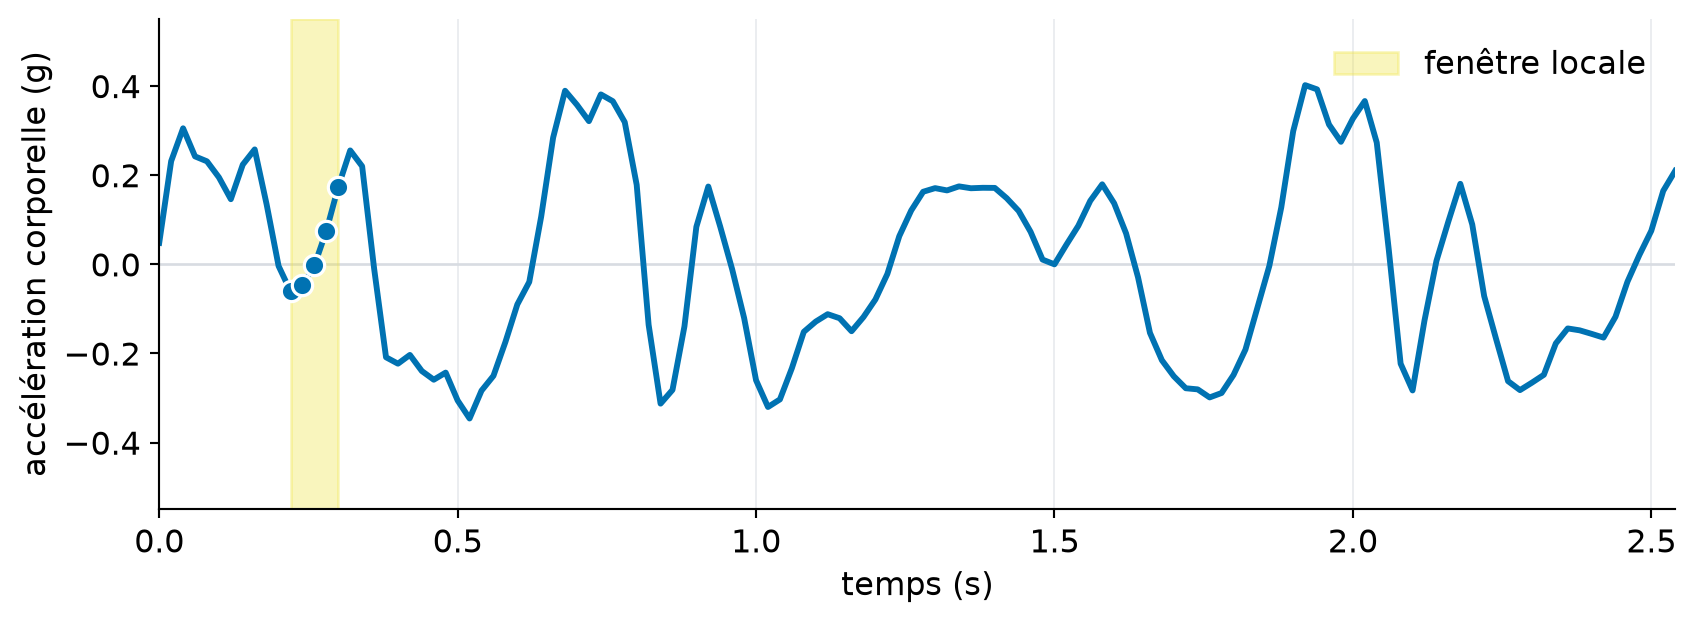
Une trace d'accélération pendant la marche dont cinq échantillons adjacents sont surlignés comme fenêtre locale du noyau.

\[ w = [-1,-1,0,1,1], \qquad y[i] = \sum_{j=0}^{K-1} x[i+j]w[j] \]

x et y ont-ils la même longueur ?

def conv1d(x, w):

    K = w.size
    L_out = x.size - K + 1
    y = np.zeros(L_out)

    for i in range(L_out):
        for j in range(K):
            y[i] += x[i + j] * w[j]

    return y

up_map = conv1d(x_walking, kernel_up)

Poids partagés → carte de sortie

Afficher le code du graphique
feature_time = (np.arange(up_map.size) + (K - 1) / 2) / SAMPLE_RATE

best_up = int(np.argmax(up_map))

fig, axes = plt.subplots(
    2,
    1,
    figsize=(11.5, 5.2),
    sharex=True,
    gridspec_kw={"height_ratios": [1.05, 1]},
)

axes[0].plot(time, x_walking, color=BLUE)
axes[0].axvspan(
    time[best_up],
    time[best_up + K - 1],
    color=HIGHLIGHT,
    alpha=0.35,
)
axes[0].set_title("Séquence d'entrée", loc="left")
style_time_axis(
    axes[0],
    ylabel="accélération (g)",
    ylim=(-0.55, 0.55),
)

axes[1].plot(feature_time, up_map, color=PURPLE)
axes[1].scatter(
    feature_time[best_up],
    up_map[best_up],
    color=PURPLE,
    edgecolor="white",
    linewidth=1.2,
    s=75,
    zorder=3,
)
axes[1].set_title("Carte d'attributs de sortie", loc="left")
axes[1].axhline(0, color=LIGHT_GRAY, linewidth=1)
axes[1].grid(axis="x", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)
axes[1].set_xlim(time[0], time[-1])
axes[1].set_ylabel("score du noyau")
axes[1].set_xlabel("temps (s)")

fig.tight_layout(h_pad=0.8)
plt.show()

Une séquence d'accélération pendant la marche est alignée au-dessus de la carte d'attributs produite par un noyau de transition ascendante.

La position change-t-elle la réponse ?

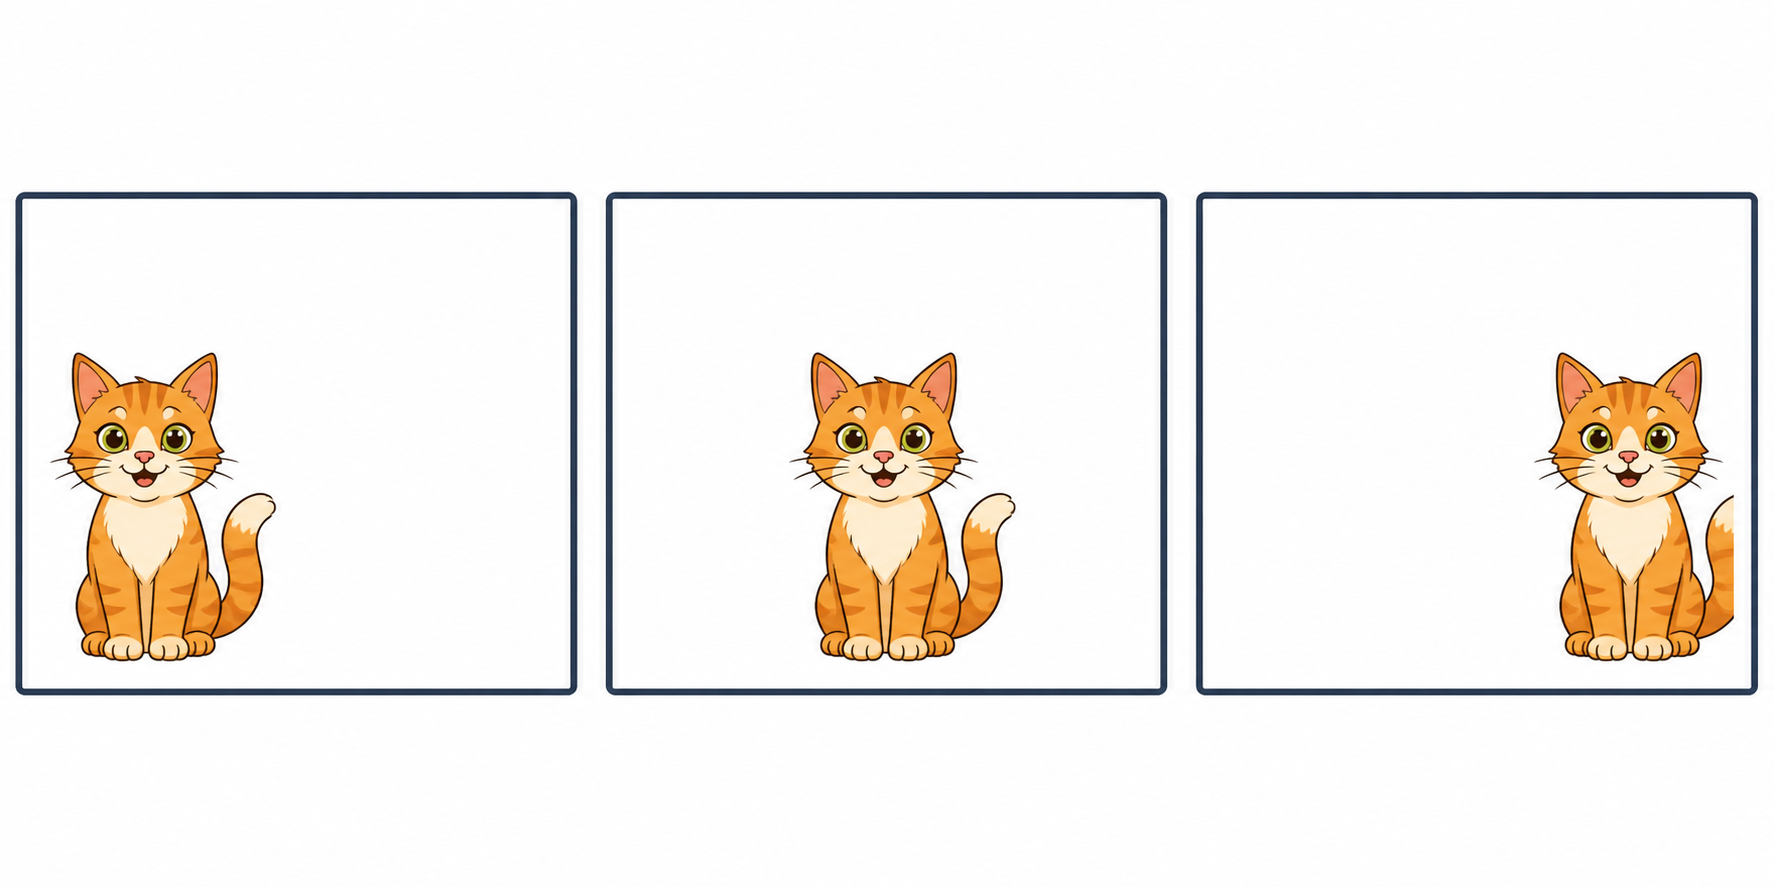
Le même chat orange dessiné apparaît à gauche, au centre et à droite de trois images encadrées par ailleurs identiques.

Équivariance

Soit \(T_\Delta\) une translation de l’entrée de \(\Delta\) positions.

\[ F(T_\Delta X)=T_\Delta F(X) \]

Une carte d’attributs convolutive se déplace avec le motif d’entrée.

Comment conserver la longueur ?

def conv1d(x, w, padding=(0, 0)):

    P_left, P_right = padding
    x_pad = np.pad(x, (P_left, P_right), mode="constant")
    K = w.size
    L_out = x_pad.size - K + 1
    y = np.zeros(L_out)

    for i in range(L_out):
        for j in range(K):
            y[i] += x_pad[i + j] * w[j]

    return y

up_map_same = conv1d(x_walking, kernel_up, padding=(2, 2))

\[ L_{\mathrm{out}}=L+P_{\mathrm{left}}+P_{\mathrm{right}}-K+1 \]

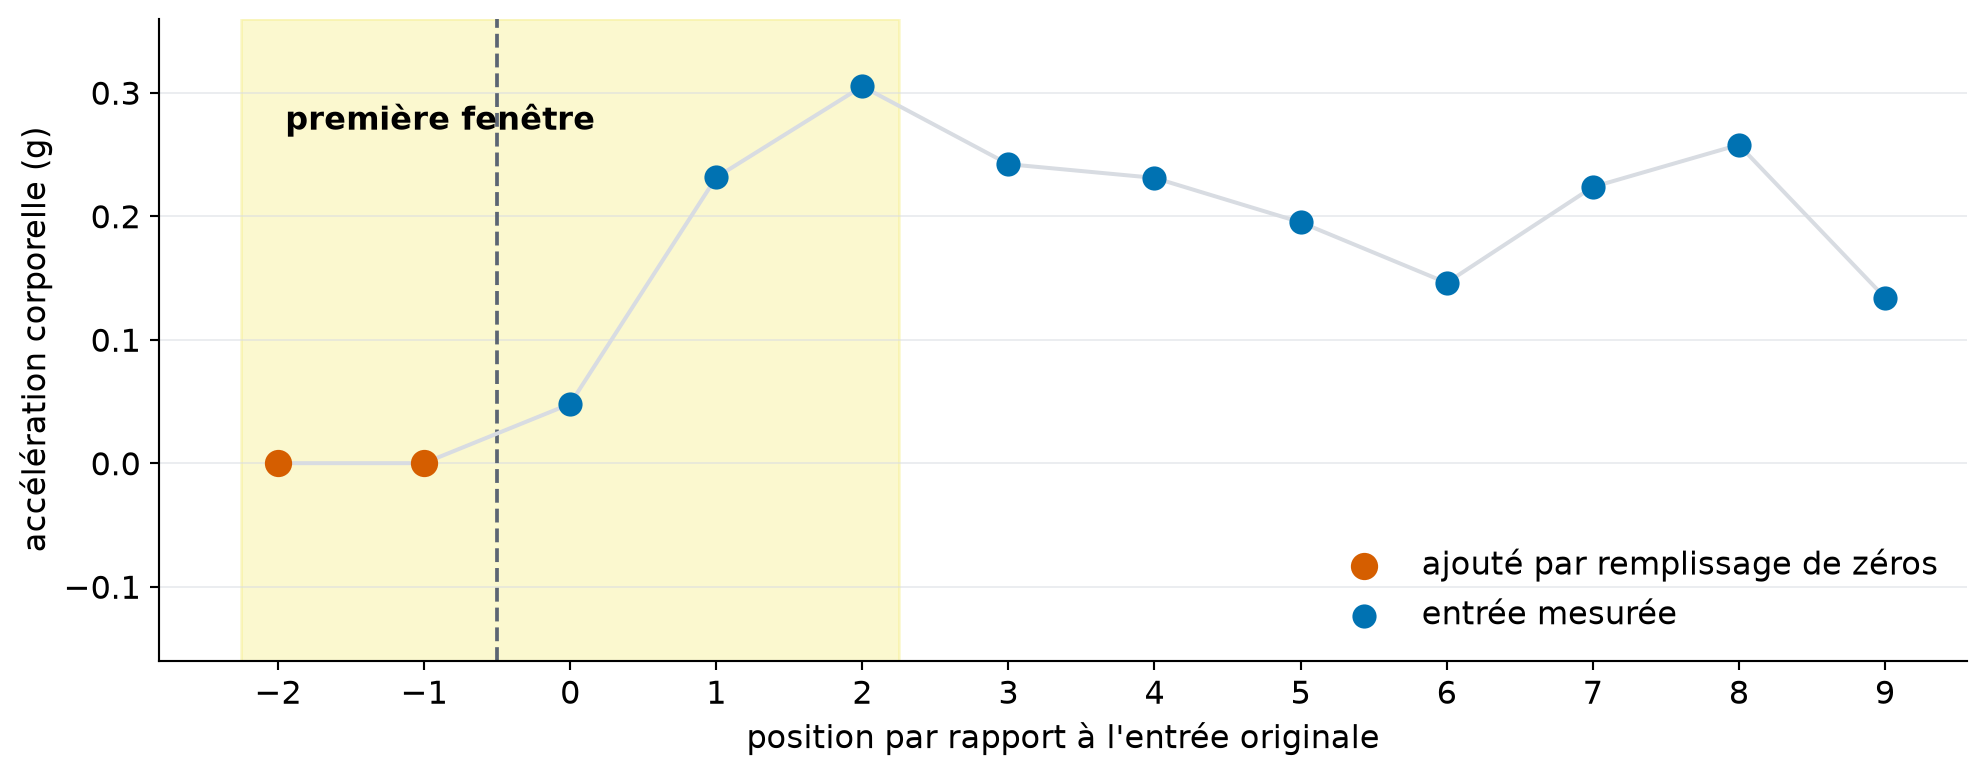
Valeurs non mesurées

Afficher le code du graphique
P = 2
shown = 10
padded_index = np.arange(-P, shown)
padded_values = np.concatenate([np.zeros(P), x_walking[:shown]])

fig, ax = plt.subplots(figsize=(10.5, 4.2))
ax.axvspan(-P - 0.25, 2.25, color=HIGHLIGHT, alpha=0.25)
ax.axvline(-0.5, color=GRAY, linestyle="--", linewidth=1.4)
ax.plot(padded_index, padded_values, color=LIGHT_GRAY, linewidth=1.5)
ax.scatter(
    padded_index[:P],
    padded_values[:P],
    color=ORANGE,
    s=85,
    label="ajouté par remplissage de zéros",
    zorder=3,
)
ax.scatter(
    padded_index[P:],
    padded_values[P:],
    color=BLUE,
    s=65,
    label="entrée mesurée",
    zorder=3,
)
ax.text(-1.95, 0.27, "première fenêtre", fontweight="bold")
ax.set_xticks(padded_index)
ax.set_xlabel("position par rapport à l'entrée originale")
ax.set_ylabel("accélération corporelle (g)")
ax.set_ylim(-0.16, 0.36)
ax.grid(axis="y", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)
ax.legend(loc="lower right")
fig.tight_layout()
plt.show()

Les dix premières valeurs d'accélération sont précédées de deux zéros artificiels; la première fenêtre de cinq valeurs contient à la fois des valeurs ajoutées et mesurées.

Que se passe-t-il si \(i\) avance de 2 ?

def conv1d(x, w, padding=(0, 0), stride=1):

    P_left, P_right = padding
    x_pad = np.pad(x, (P_left, P_right), mode="constant")
    K = w.size
    starts = range(0, x_pad.size - K + 1, stride)
    y = np.zeros(len(starts))

    for t, i in enumerate(starts):
        for j in range(K):
            y[t] += x_pad[i + j] * w[j]

    return y

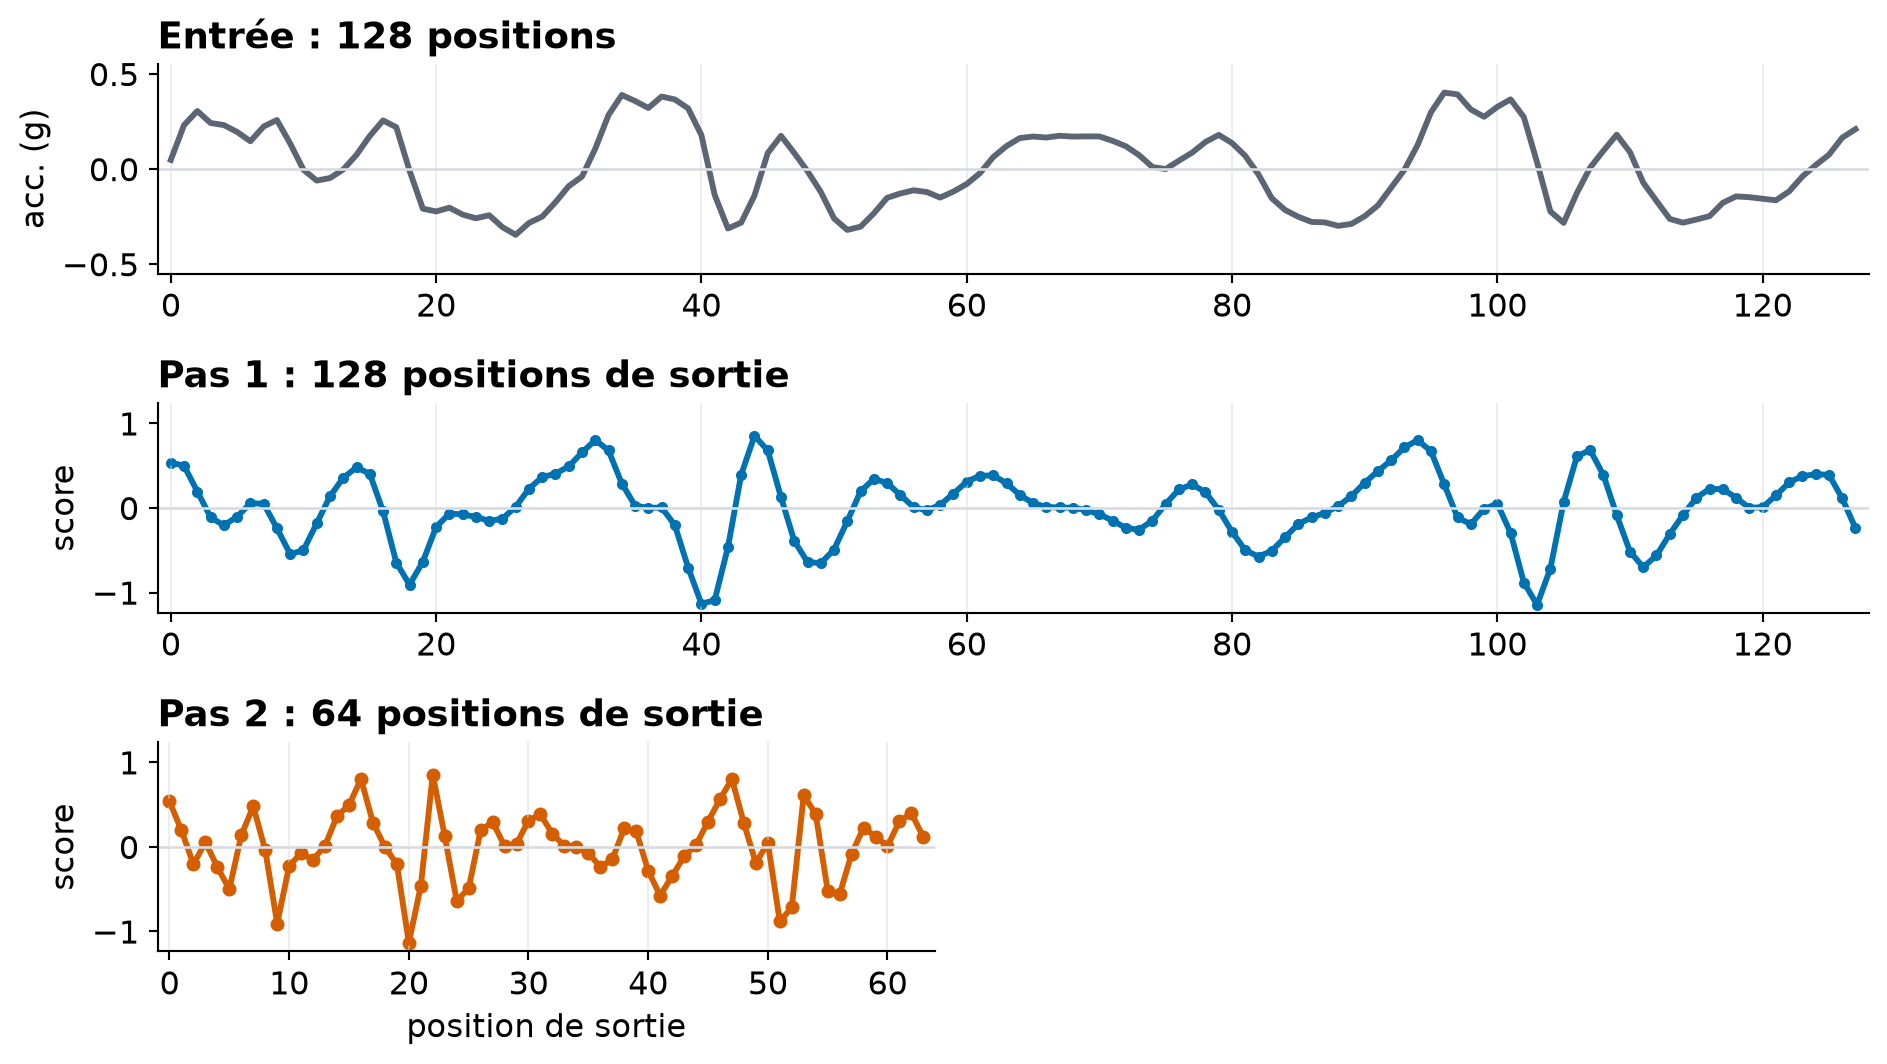
\[ L_{\mathrm{out}}= \left\lfloor\frac{L+P_{\mathrm{left}}+P_{\mathrm{right}}-K}{S}\right\rfloor+1 \]

Quel effet a un pas de 2 ?

Afficher le code du graphique
stride1_map = conv1d(x_walking, kernel_up, padding=(2, 2), stride=1)
stride2_map = conv1d(x_walking, kernel_up, padding=(2, 2), stride=2)

input_position = np.arange(x_walking.size)
stride1_position = np.arange(stride1_map.size)
stride2_position = np.arange(stride2_map.size)
score_limit = 1.08 * max(np.abs(stride1_map).max(), np.abs(stride2_map).max())

fig = plt.figure(figsize=(11.5, 6.0))
grid = fig.add_gridspec(3, 2, width_ratios=[1, 1], hspace=0.62)
input_ax = fig.add_subplot(grid[0, :])
stride1_ax = fig.add_subplot(grid[1, :])
stride2_ax = fig.add_subplot(grid[2, 0])
empty_ax = fig.add_subplot(grid[2, 1])
empty_ax.axis("off")

input_ax.plot(input_position, x_walking, color=GRAY)
input_ax.set_title("Entrée : 128 positions", loc="left")
input_ax.set_ylabel("acc. (g)")
input_ax.set_ylim(-0.55, 0.55)
input_ax.set_xlim(-1, 128)

stride1_ax.plot(stride1_position, stride1_map, color=BLUE)
stride1_ax.scatter(stride1_position, stride1_map, color=BLUE, s=10)
stride1_ax.set_title("Pas 1 : 128 positions de sortie", loc="left")
stride1_ax.set_ylabel("score")
stride1_ax.set_ylim(-score_limit, score_limit)
stride1_ax.set_xlim(-1, 128)

stride2_ax.plot(stride2_position, stride2_map, color=ORANGE)
stride2_ax.scatter(stride2_position, stride2_map, color=ORANGE, s=18)
stride2_ax.set_title("Pas 2 : 64 positions de sortie", loc="left")
stride2_ax.set_ylabel("score")
stride2_ax.set_xlabel("position de sortie")
stride2_ax.set_ylim(-score_limit, score_limit)
stride2_ax.set_xlim(-1, 64)

for ax in [input_ax, stride1_ax, stride2_ax]:
    ax.axhline(0, color=LIGHT_GRAY, linewidth=1)
    ax.grid(axis="x", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)

fig.tight_layout()
plt.show()

Une entrée de 128 positions et une sortie de 128 positions avec un pas de un occupent toute la largeur; la sortie de 64 positions avec un pas de deux n'en occupe que la moitié gauche.

Noyaux et canaux multiples

Plusieurs motifs locaux

Contraste ascendant

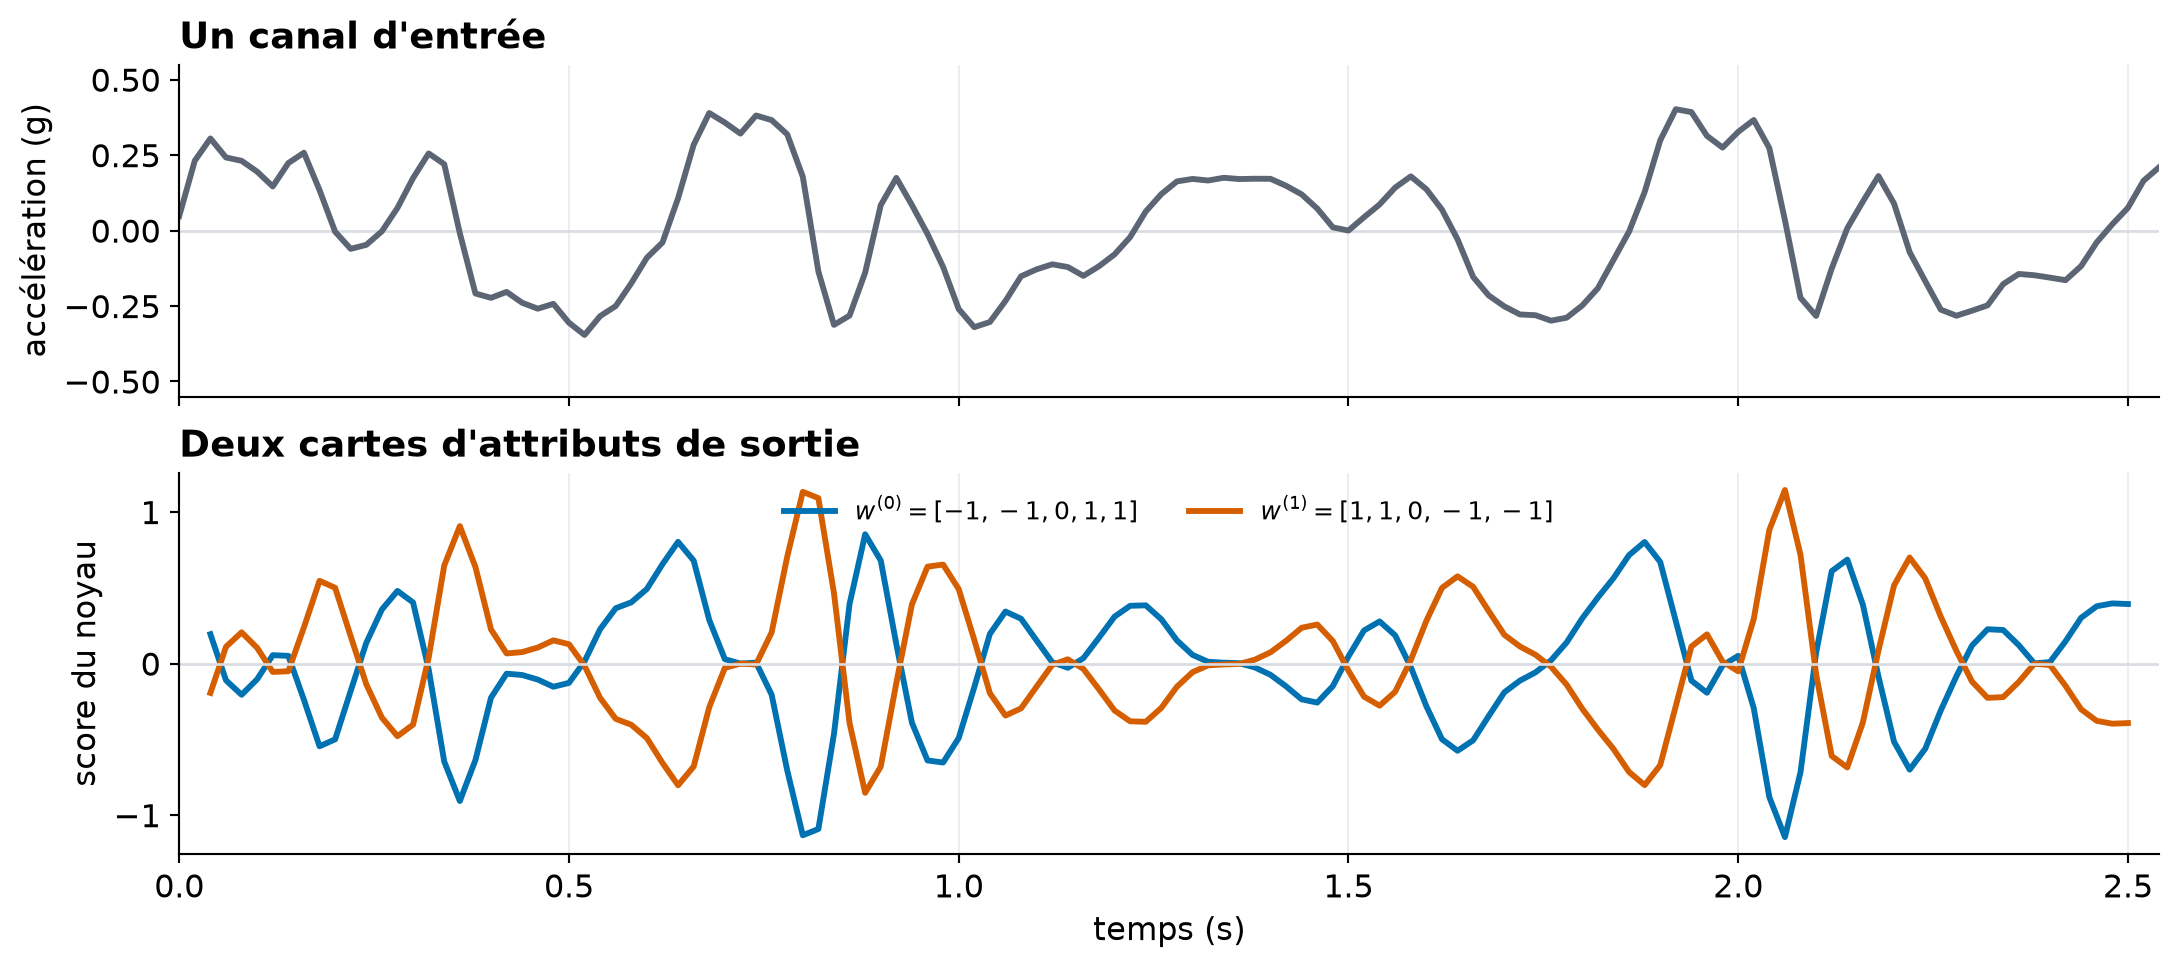
\[ w^{(0)} = [-1,-1,0,1,1] \]

La première paire est soustraite de la dernière.

Contraste descendant

\[ w^{(1)} = [1,1,0,-1,-1] \]

La dernière paire est soustraite de la première.

\[ W = \begin{bmatrix}\vert & \vert\\ w^{(0)} & w^{(1)}\\ \vert & \vert\end{bmatrix} \in \mathbb{R}^{K\times C_{\mathrm{out}}} \]

Combien de noyaux une couche devrait-elle utiliser ?

  • L’expertise du domaine peut suggérer un petit ensemble interprétable.
  • Plus souvent, \(C_{\mathrm{out}}\) est un hyperparamètre choisi à l’aide des données de validation.
  • Davantage de noyaux augmentent la capacité de représentation, le nombre de paramètres, la mémoire requise et les calculs.

La boucle acquiert un indice de noyau

def conv1d(x, W, b, padding=(0, 0), stride=1):

    P_left, P_right = padding
    x_pad = np.pad(x, (P_left, P_right), mode="constant")
    K, C_out = W.shape
    starts = range(0, x_pad.size - K + 1, stride)
    Y = np.zeros((len(starts), C_out))

    for t, i in enumerate(starts):
        for m in range(C_out):
            Y[t, m] = b[m]
            for j in range(K):
                Y[t, m] += x_pad[i + j] * W[j, m]

    return Y

Un noyau → une carte de sortie

Afficher le code du graphique
kernels = np.column_stack([kernel_up, kernel_down])
bias = np.zeros(2)
feature_maps = conv1d(x_walking, kernels, bias)
feature_time = (np.arange(feature_maps.shape[0]) + (K - 1) / 2) / SAMPLE_RATE

fig, axes = plt.subplots(
    2,
    1,
    figsize=(11.5, 5.2),
    sharex=True,
    gridspec_kw={"height_ratios": [1, 1.15]},
)

axes[0].plot(time, x_walking, color=GRAY)
axes[0].set_title("Un canal d'entrée", loc="left")
style_time_axis(
    axes[0],
    ylabel="accélération (g)",
    ylim=(-0.55, 0.55),
)

axes[1].plot(
    feature_time,
    feature_maps[:, 0],
    color=BLUE,
    label=r"$w^{(0)}=[-1,-1,0,1,1]$",
)
axes[1].plot(
    feature_time,
    feature_maps[:, 1],
    color=ORANGE,
    label=r"$w^{(1)}=[1,1,0,-1,-1]$",
)
axes[1].axhline(0, color=LIGHT_GRAY, linewidth=1)
axes[1].grid(axis="x", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)
axes[1].set_xlim(time[0], time[-1])
axes[1].set_title("Deux cartes d'attributs de sortie", loc="left")
axes[1].set_ylabel("score du noyau")
axes[1].set_xlabel("temps (s)")
axes[1].legend(loc="upper center", ncol=2, fontsize=9.5)

fig.tight_layout(h_pad=0.7)
plt.show()

Un signal d'accélération corporelle au-dessus de deux cartes d'attributs produites par des noyaux explicites de transition ascendante et descendante.

Formes et signification des objets

Objet Signification Forme
\(X\) séquence d’entrée \((L,C_{\mathrm{in}})\)
\(W\) poids des noyaux \((K,C_{\mathrm{in}},C_{\mathrm{out}})\)
\(b\) un biais par canal de sortie \((C_{\mathrm{out}})\)
\(Y\) cartes d’attributs de sortie \((L_{\mathrm{out}},C_{\mathrm{out}})\)

\[ Y[t,m] = b[m] + \sum_{j=0}^{K-1}\sum_{c=0}^{C_{\mathrm{in}}-1} \widetilde X[tS+j,c]W[j,c,m] \]

Une fenêtre couvre tous les canaux d’entrée

def conv1d(X, W, b, padding=(0, 0), stride=1):

    P_left, P_right = padding
    X_pad = np.pad(X, ((P_left, P_right), (0, 0)), mode="constant")
    K, C_in, C_out = W.shape
    starts = range(0, X_pad.shape[0] - K + 1, stride)
    Y = np.zeros((len(starts), C_out))

    for t, i in enumerate(starts):
        for m in range(C_out):
            Y[t, m] = b[m]
            for j in range(K):
                for c in range(C_in):
                    Y[t, m] += X_pad[i + j, c] * W[j, c, m]

    return Y

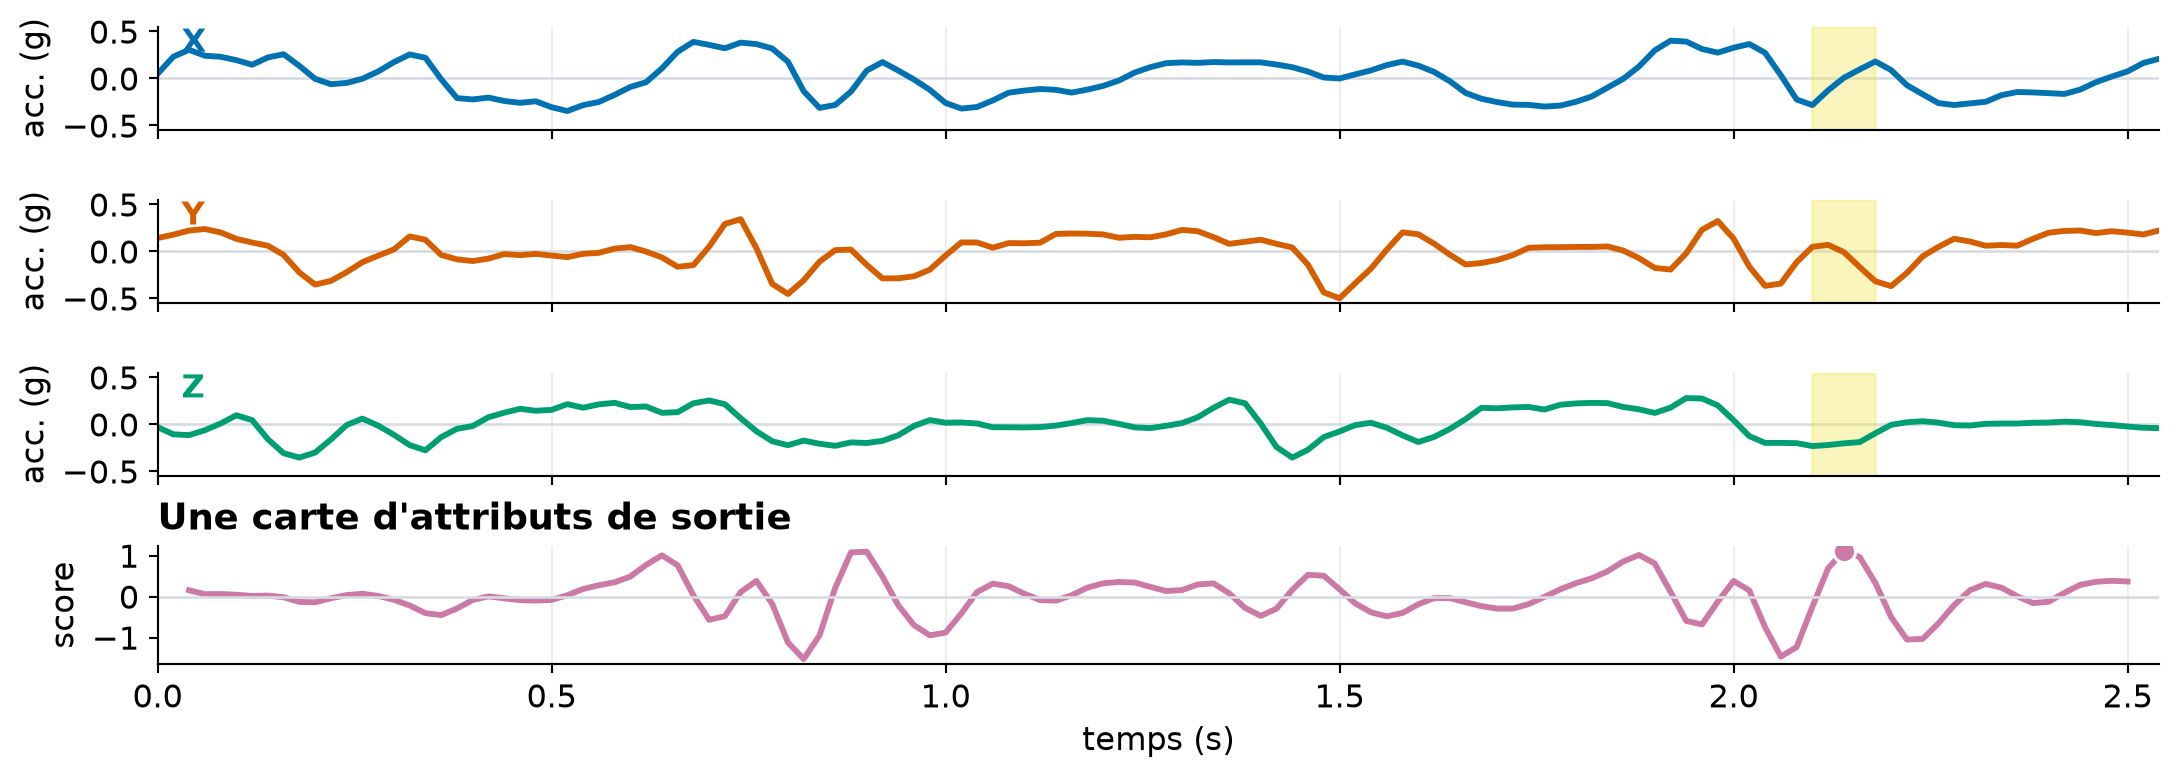
Un noyau couvre tous les canaux d’entrée

Afficher les tenseurs et le code du graphique
X = walking.loc[:, ["x", "y", "z"]].to_numpy()

# Un noyau illustratif : cinq positions, trois canaux, une carte de sortie.
W = np.stack(
    [kernel_up, -0.6 * kernel_up, 0.4 * kernel_up],
    axis=1,
)[:, :, np.newaxis]
b = np.zeros(1)
Y = conv1d(X, W, b, padding=(0, 0), stride=1)

multi_map = Y[:, 0]
multi_feature_time = (
    np.arange(multi_map.size) + (K - 1) / 2
) / SAMPLE_RATE
best_multi = int(np.argmax(multi_map))
start = best_multi
stop = start + K

fig, axes = plt.subplots(
    4,
    1,
    figsize=(11.5, 4.2),
    sharex=True,
    gridspec_kw={"height_ratios": [1, 1, 1, 1.15]},
)

for ax, channel, color in zip(
    axes[:3], ["x", "y", "z"], [BLUE, ORANGE, GREEN]
):
    ax.plot(time, walking[channel], color=color)
    ax.axvspan(
        time[start],
        time[stop - 1],
        color=HIGHLIGHT,
        alpha=0.35,
    )
    ax.text(
        0.012,
        0.76,
        channel.upper(),
        transform=ax.transAxes,
        color=color,
        fontweight="bold",
    )
    style_time_axis(ax, ylabel="acc. (g)", ylim=(-0.55, 0.55))

axes[3].plot(multi_feature_time, multi_map, color=PURPLE)
axes[3].scatter(
    multi_feature_time[best_multi],
    multi_map[best_multi],
    color=PURPLE,
    edgecolor="white",
    linewidth=1.2,
    s=70,
    zorder=3,
)
axes[3].axhline(0, color=LIGHT_GRAY, linewidth=1)
axes[3].grid(axis="x", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)
axes[3].set_xlim(time[0], time[-1])
axes[3].set_ylabel("score")
axes[3].set_xlabel("temps (s)")
axes[3].set_title("Une carte d'attributs de sortie", loc="left")

fig.tight_layout(h_pad=0.35)
plt.show()

Trois canaux synchronisés d'accélération corporelle, une fenêtre temporelle commune et la carte d'attributs qui en résulte.

Empilement et pooling

Que représentent \(X\) et \(Y\) ?

\[ X \;\xrightarrow{\;\text{convolution}+b\;}\; Z \;\xrightarrow{\;g\;}\; Y \]

\[ X^{(\ell+1)}=Y^{(\ell)} \]

  • \(X\) : entrée d’une couche ;
  • \(Z\) : scores de préactivation ;
  • \(Y=g(Z)\) : activations de sortie ;
  • les canaux de \(Y^{(\ell)}\) deviennent les canaux d’entrée de la couche suivante.

Combiner des cartes d’attributs

def relu(Z):
    return np.maximum(Z, 0)

X0 = x_walking[:, np.newaxis]
W1 = kernels[:, np.newaxis, :]
b1 = np.zeros(2)
Z1 = conv1d(X0, W1, b1)
Y1 = relu(Z1)

W2 = np.zeros((K, 2, 1))

W2[:2, 0, 0] = 0.5     # indice ascendant plus tôt
W2[-2:, 1, 0] = 0.5    # indice descendant plus tard

b2 = np.array([-0.8])
Z2 = conv1d(Y1, W2, b2)
Y2 = relu(Z2)

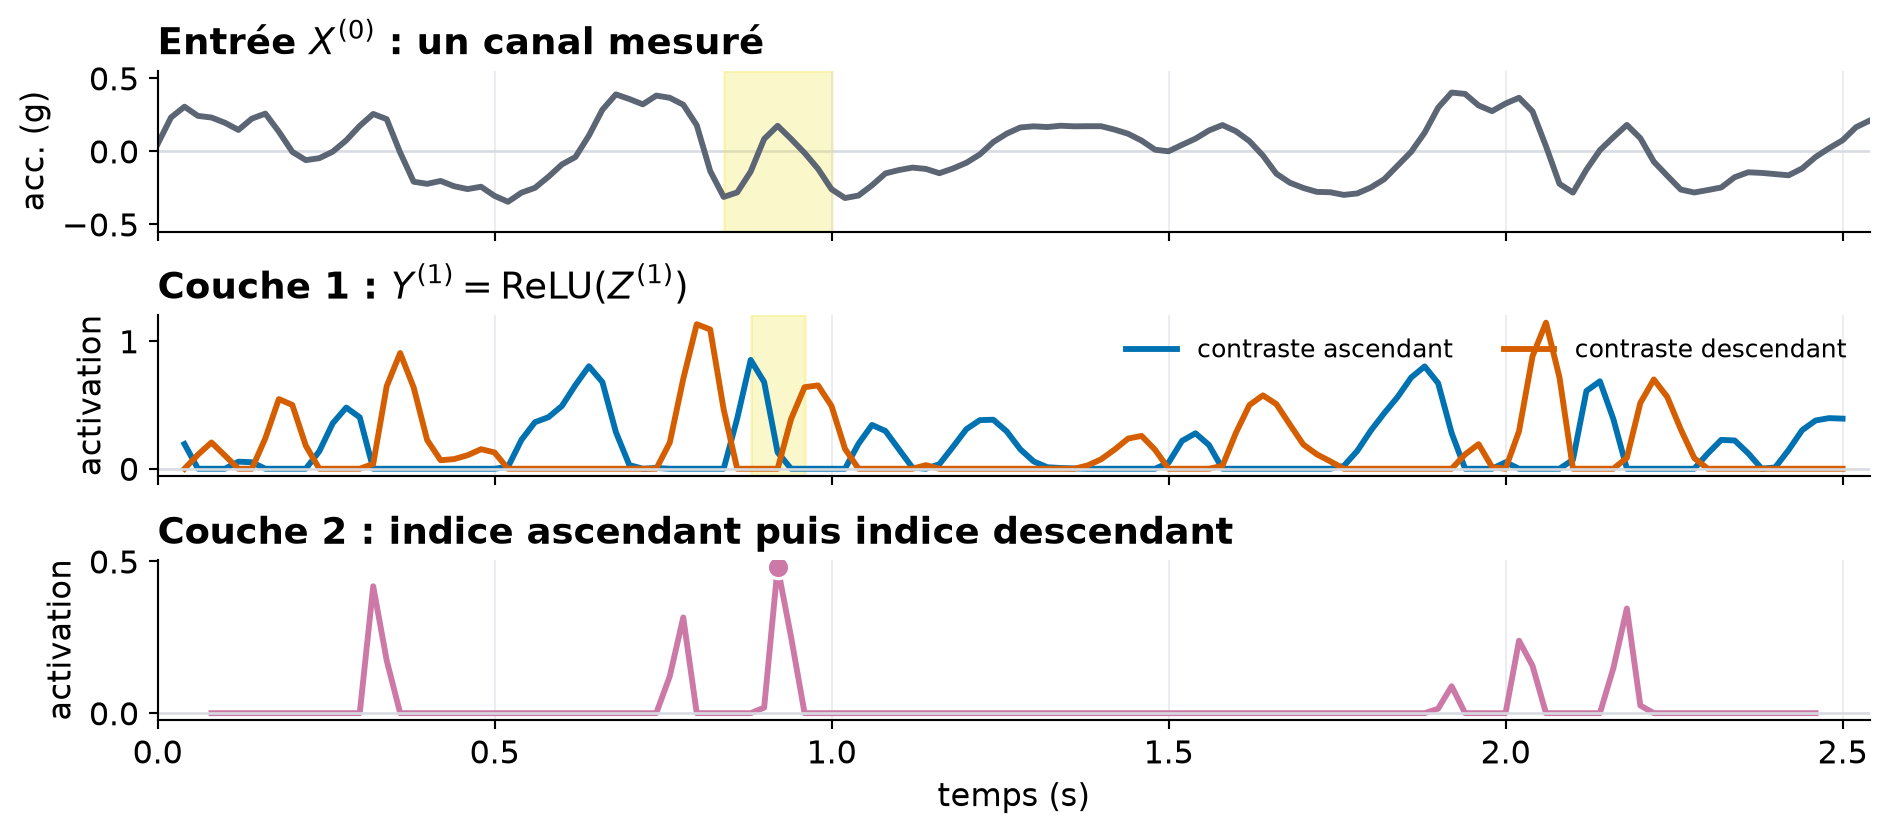
Les couches détectent des motifs de motifs

Afficher le code
time1 = (np.arange(Y1.shape[0]) + (K - 1) / 2) / SAMPLE_RATE
time2 = (np.arange(Y2.shape[0]) + (K - 1)) / SAMPLE_RATE
best_pattern = int(np.argmax(Y2[:, 0]))
receptive_start = best_pattern
receptive_stop = best_pattern + 2 * K - 1

fig, axes = plt.subplots(3, 1, figsize=(10.0, 4.5), sharex=True)

axes[0].plot(time, X0[:, 0], color=GRAY)
axes[0].axvspan(
    time[receptive_start],
    time[receptive_stop - 1],
    color=HIGHLIGHT,
    alpha=0.28,
)
axes[0].set_title(r"Entrée $X^{(0)}$ : un canal mesuré", loc="left")
style_time_axis(axes[0], ylabel="acc. (g)", ylim=(-0.55, 0.55))

axes[1].plot(time1, Y1[:, 0], color=BLUE, label="contraste ascendant")
axes[1].plot(time1, Y1[:, 1], color=ORANGE, label="contraste descendant")
axes[1].axvspan(
    time1[best_pattern],
    time1[best_pattern + K - 1],
    color=HIGHLIGHT,
    alpha=0.28,
)
axes[1].set_title(
    r"Couche 1 : $Y^{(1)}=\operatorname{ReLU}(Z^{(1)})$",
    loc="left",
)
axes[1].set_ylabel("activation")
axes[1].axhline(0, color=LIGHT_GRAY, linewidth=1)
axes[1].grid(axis="x", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)
axes[1].legend(loc="upper right", ncol=2, fontsize=9.5)

axes[2].plot(time2, Y2[:, 0], color=PURPLE)
axes[2].scatter(
    time2[best_pattern],
    Y2[best_pattern, 0],
    color=PURPLE,
    edgecolor="white",
    linewidth=1.2,
    s=70,
    zorder=3,
)
axes[2].set_title(
    "Couche 2 : indice ascendant puis indice descendant",
    loc="left",
)
axes[2].set_ylabel("activation")
axes[2].set_xlabel("temps (s)")
axes[2].axhline(0, color=LIGHT_GRAY, linewidth=1)
axes[2].grid(axis="x", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)
axes[2].set_xlim(time[0], time[-1])

fig.tight_layout(h_pad=0.65)
plt.show()

Une entrée d'accélération produit des activations ReLU ascendantes et descendantes dans la première couche; la deuxième combine un indice ascendant plus tôt et un indice descendant plus tard dans une seule carte d'activation.

Que modifie le biais ?

\[ Y[i,m] = \sum_{j=0}^{K-1}x[i+j] W[j,m] + b[m] \]

Fenêtre locale ou champ récepteur ?

  • Une fenêtre locale (patch ou window) est la tranche de l’entrée d’une couche lue par le noyau.
  • Le champ récepteur d’une unité regroupe les positions de l’entrée originale qui peuvent l’influencer.

Avec un pas unitaire et sans dilatation,

\[ R_1=K_1,\qquad R_2=R_1+(K_2-1). \]

Deux noyaux de longueur 5 donnent à la deuxième couche un champ récepteur de \(5+(5-1)=9\) positions.

Résumer le voisinage

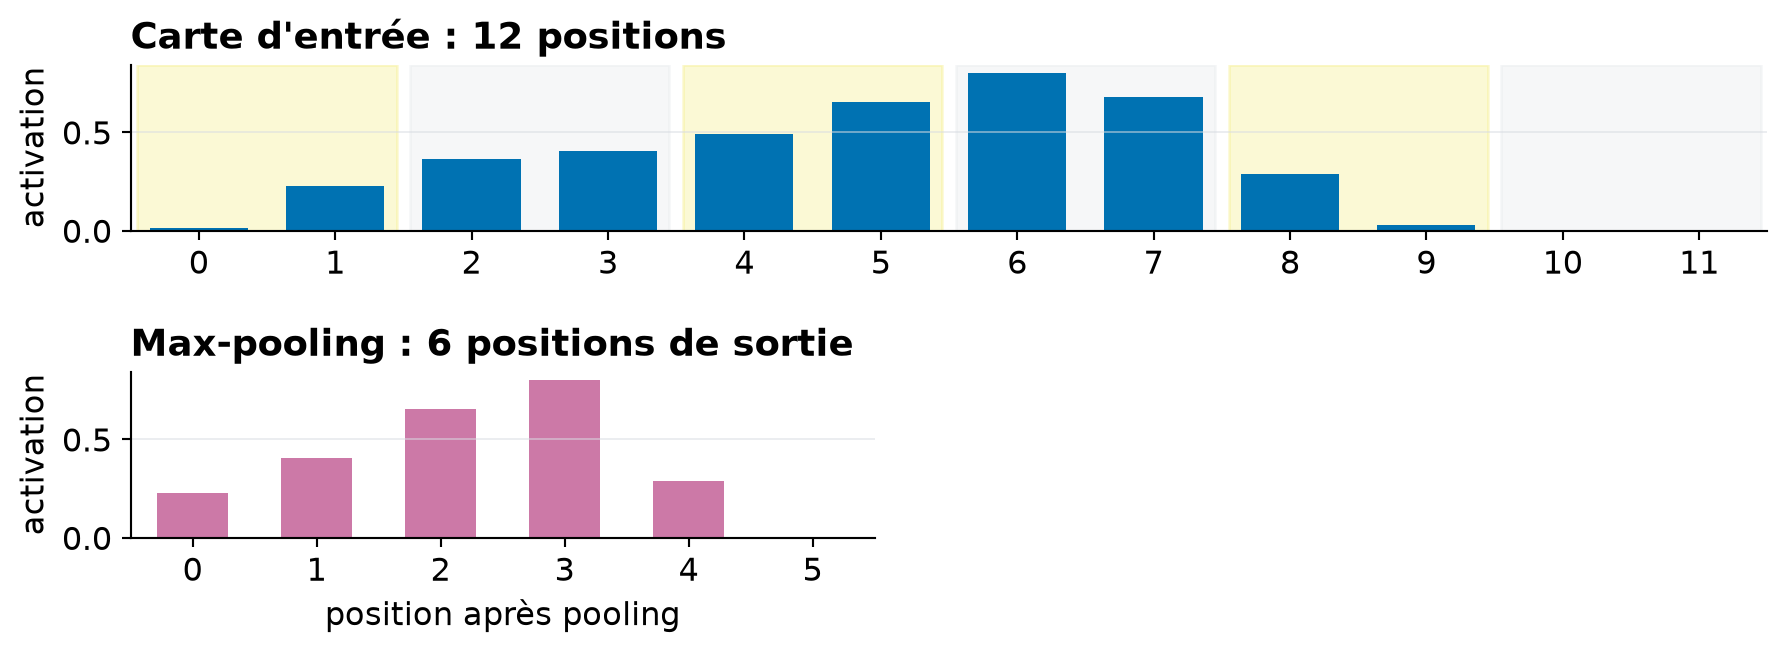
def max_pool1d(y, pool_size=2, stride=2):

    L_out = (len(y) - pool_size) // stride + 1
    p = np.zeros(L_out)

    for t in range(L_out):
        i = t * stride
        window = y[i : i + pool_size]
        p[t] = max(window)

    return p

\[ p[t]=\max_{0\leq j<P} y[tS+j] \]

Le pooling réduit la longueur de la séquence

Afficher le code du graphique
# Sélectionner une courte région contenant des activations positives variées.
pool_start = 24
pool_input = np.maximum(up_map[pool_start : pool_start + 12], 0)
pool_output = max_pool1d(pool_input, pool_size=2, stride=2)

fig = plt.figure(figsize=(11.0, 3.2))
grid = fig.add_gridspec(2, 2, width_ratios=[1, 1], hspace=0.85)
input_ax = fig.add_subplot(grid[0, :])
pooled_ax = fig.add_subplot(grid[1, 0])
empty_ax = fig.add_subplot(grid[1, 1])
empty_ax.axis("off")

for pair in range(6):
    color = HIGHLIGHT if pair % 2 == 0 else LIGHT_GRAY
    input_ax.axvspan(
        2 * pair - 0.45,
        2 * pair + 1.45,
        color=color,
        alpha=0.22,
    )

input_ax.bar(np.arange(12), pool_input, color=BLUE, width=0.72)
input_ax.set_title("Carte d'entrée : 12 positions", loc="left")
input_ax.set_ylabel("activation")
input_ax.set_xticks(np.arange(12))
input_ax.set_xlim(-0.5, 11.5)
input_ax.grid(axis="y", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)

pooled_ax.bar(np.arange(6), pool_output, color=PURPLE, width=0.58)
pooled_ax.set_title("Max-pooling : 6 positions de sortie", loc="left")
pooled_ax.set_ylabel("activation")
pooled_ax.set_xlabel("position après pooling")
pooled_ax.set_xticks(np.arange(6))
pooled_ax.set_xlim(-0.5, 5.5)
pooled_ax.grid(axis="y", color=LIGHT_GRAY, linewidth=0.7, alpha=0.55)

fig.tight_layout()
plt.show()

Douze activations non négatives occupent toute la largeur; en dessous, les six sorties du max-pooling occupent la moitié de la largeur.

Effet sur la longueur

Opération Paramètres Canaux
Pas somme pondérée poids du noyau et biais peuvent changer
Pooling maximum ou moyenne fixe aucun généralement inchangés

Des attributs aux prédictions

Comment les cartes d’attributs prédisent-elles ?

\[ Y\in\mathbb{R}^{L_{\mathrm{out}}\times C_{\mathrm{out}}} \;\xrightarrow{\;\text{pooling global}\;}\; h\in\mathbb{R}^{C_{\mathrm{out}}} \;\xrightarrow{\;\text{Dense}\;}\; z\in\mathbb{R} \;\xrightarrow{\;\sigma\;}\; \widehat p_{\mathrm{marche}} \]

\[ h[m]=\max_i Y[i,m], \qquad z=\sum_m v[m]h[m]+a, \qquad \widehat p_{\mathrm{marche}}=\sigma(z). \]

Devons-nous savoir où un attribut est apparu, ou seulement s’il est apparu ?

Que change une translation ?

Soit \(T_\Delta\) une translation de l’entrée de \(\Delta\) positions.

Équivariance

\[ F(T_\Delta X)=T_\Delta F(X) \]

Une carte d’attributs convolutive se déplace avec le motif d’entrée.

Invariance

\[ G(T_\Delta Y)=G(Y) \]

Une sortie qui agrège les positions peut préserver la décision finale.

La prédiction exige une tête

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

def predict_walking(Y, v, a):
    C_out = Y.shape[1]
    h = np.zeros(C_out)
    for m in range(C_out):
        h[m] = max(Y[:, m])  # une valeur par carte d'attributs

    z = h @ v + a            # couche Dense
    return sigmoid(z)

\[ \text{signal} \rightarrow \text{couches convolutives} \rightarrow \text{pooling global} \rightarrow \text{Dense} \rightarrow \text{prédiction} \]

Apprentissage

\[ \text{exemples étiquetés} \rightarrow \text{passage avant} \rightarrow \text{perte} \]

\[ \text{perte} \rightarrow \text{rétropropagation} \rightarrow \text{mise à jour} \rightarrow \text{répéter} \]

  • Appris : chaque poids des noyaux, chaque biais des canaux de sortie ainsi que les poids et le biais de la tête de prédiction.
  • Spécifiés : le remplissage, le pas, la règle de pooling, la fonction d’activation et les dimensions des couches.

Plus de dimensions, plus d’indices

\[ \begin{aligned} \text{1D: } & W[j,c,m] \\ \text{2D: } & W[j_1,j_2,c,m] \\ \text{3D: } & W[j_1,j_2,j_3,c,m] \end{aligned} \]

Chaque noyau :

  1. sélectionne une fenêtre locale ;
  2. multiplie les valeurs et les poids correspondants ;
  3. additionne sur les positions locales et les canaux d’entrée ;
  4. produit une valeur dans une carte de sortie.

Un téléphone peut-il reconnaître la marche ?

\[ X \rightarrow \text{attributs locaux} \rightarrow \text{hiérarchie} \rightarrow \text{résumé global} \rightarrow \widehat p_{\mathrm{marche}} \]

Oui, une fois les noyaux, les biais et la tête de prédiction appris à partir d’exemples étiquetés.

Prologue

Résumé

  • Localité et partage : le même noyau examine chaque fenêtre locale et produit une carte d’attributs avec relativement peu de paramètres.
  • Canaux : chaque noyau couvre tous les canaux d’entrée et produit une carte d’attributs de sortie.
  • Géométrie : le remplissage contrôle les frontières; le pas et le pooling contrôlent la résolution et les détails de position conservés.

Résumé (suite)

  • Hiérarchie : l’empilement des couches compose des attributs simples et agrandit les champs récepteurs.
  • Prédiction : la convolution est équivariante par translation; l’agrégation des positions peut favoriser des prédictions invariantes, et une tête de prédiction produit la sortie finale.
  • Apprentissage : la rétropropagation apprend conjointement chaque noyau, chaque poids et chaque biais.

Lectures complémentaires

  • Understanding Deep Learning (Prince 2023) est un manuel récent consacré aux concepts fondamentaux de l’apprentissage profond.

  • Il part des principes de base et aborde ensuite des sujets contemporains comme les transformeurs, les modèles de diffusion, les réseaux neuronaux de graphes, les autoencodeurs, les réseaux antagonistes et l’apprentissage par renforcement.

  • Il vise à rendre ces concepts compréhensibles sans s’attarder excessivement aux détails théoriques.

  • Il comprend 68 exercices sous forme de carnets Python.

  • Le livre suit un modèle « lire d’abord, payer plus tard ».

Ressources

  • A guide to convolution arithmetic for deep learning
  • Auteurs : Vincent Dumoulin et Francesco Visin
  • Dernière révision : 11 janvier 2018

StatQuest

Prochain cours

  • Nous introduirons la recherche.

Références

Géron, Aurélien. 2019. Hands-on Machine Learning with Scikit-Learn, Keras, and TensorFlow. 2nd éd. O’Reilly Media.
Krizhevsky, Alex, Ilya Sutskever, et Geoffrey E Hinton. 2012. « ImageNet Classification with Deep Convolutional Neural Networks ». In Advances in Neural Information Processing Systems, édité par F. Pereira, C. J. Burges, L. Bottou, et K. Q. Weinberger, vol. 25. Curran Associates, Inc. https://proceedings.neurips.cc/paper_files/paper/2012/file/c399862d3b9d6b76c8436e924a68c45b-Paper.pdf.
Prince, Simon J. D. 2023. Understanding Deep Learning. The MIT Press. http://udlbook.com.
Russell, Stuart, et Peter Norvig. 2020. Artificial Intelligence: A Modern Approach. 4ᵉ éd. Pearson. http://aima.cs.berkeley.edu/.
Simonyan, Karen, et Andrew Zisserman. 2015. « Very Deep Convolutional Networks for Large-Scale Image Recognition ». International Conference on Learning Representations.

Annexe : réseaux de neurones convolutifs bien connus

AlexNet

Krizhevsky et al. (2012)

VGG

Simonyan et Zisserman (2015)

Performance des ConvNets

Marcel Turcotte

[email protected]

École de science informatique et de génie électrique (SIGE)

Université d’Ottawa