CSI4506 Introduction à l’intelligence artificielle
Auteur·rice
Affiliations
Marcel Turcotte
École de science informatique et de génie électrique
Université d’Ottawa
Date de publication
15 octobre 2026
Ce cahier d’étude autonome prolonge la discussion de la présentation 11 sur les frontières de décision non linéaires. Nous comparons deux manières d’obtenir une représentation utile : concevoir des attributs pour la régression logistique et apprendre des représentations cachées avec un réseau de neurones. Il complète le jeu de données circulaire de TensorFlow Playground.
Les exemples Keras peuvent être explorés dès maintenant; les méthodes d’entraînement, les pertes et les techniques de régularisation sont développées dans les présentations 12 à 14.
Données
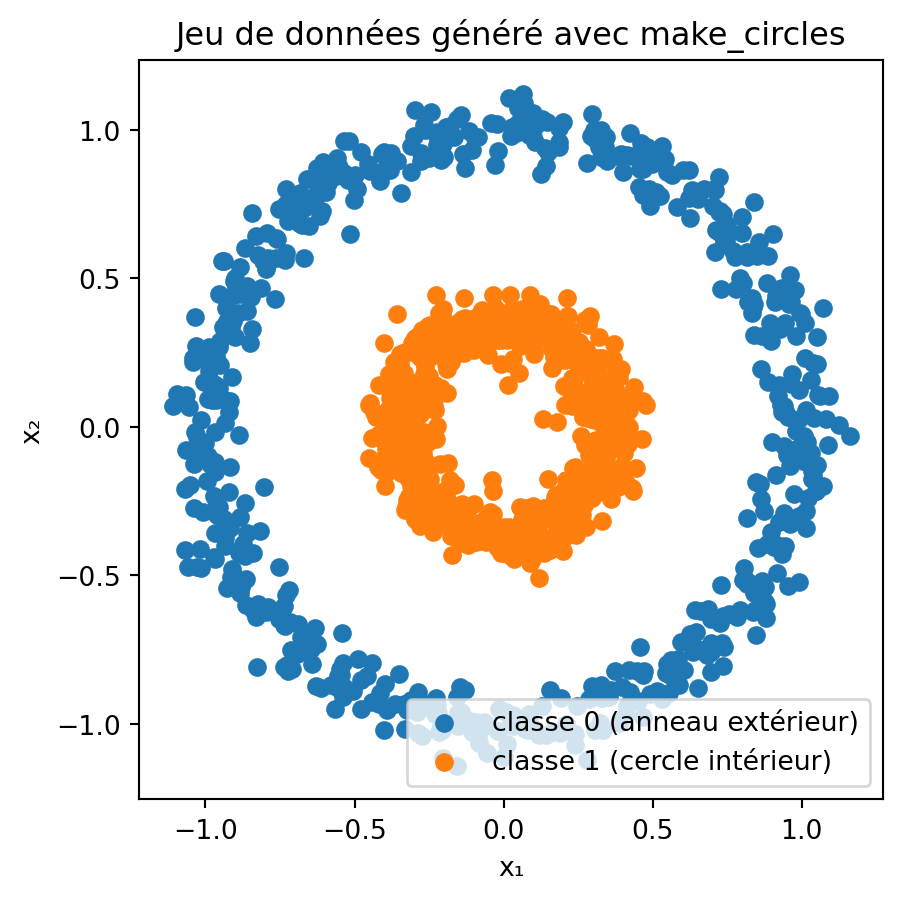
Le cercle intérieur constitue la classe 1, et l’anneau extérieur, la classe 0. Aucune droite ne peut séparer ces deux classes dans le plan des entrées d’origine.
La régression logistique utilisant seulement x_1 et x_2 possède une frontière de décision droite; elle ne peut donc pas séparer le cercle intérieur de l’anneau qui l’entoure. Elle peut néanmoins produire une frontière non linéaire dans le plan d’entrée si on lui fournit des attributs non linéaires.
TensorFlow Playground propose x_1^2 et x_2^2 comme attributs supplémentaires. Un réseau sans couche cachée avec une seule sortie sigmoïde est une régression logistique sur les attributs sélectionnés. Conserver les deux entrées d’origine et leurs carrés donne quatre attributs; sélectionner seulement les carrés en donne deux.
Pour simplifier la visualisation, combinons les carrés des entrées en un seul attribut :
r = x_1^2 + x_2^2.
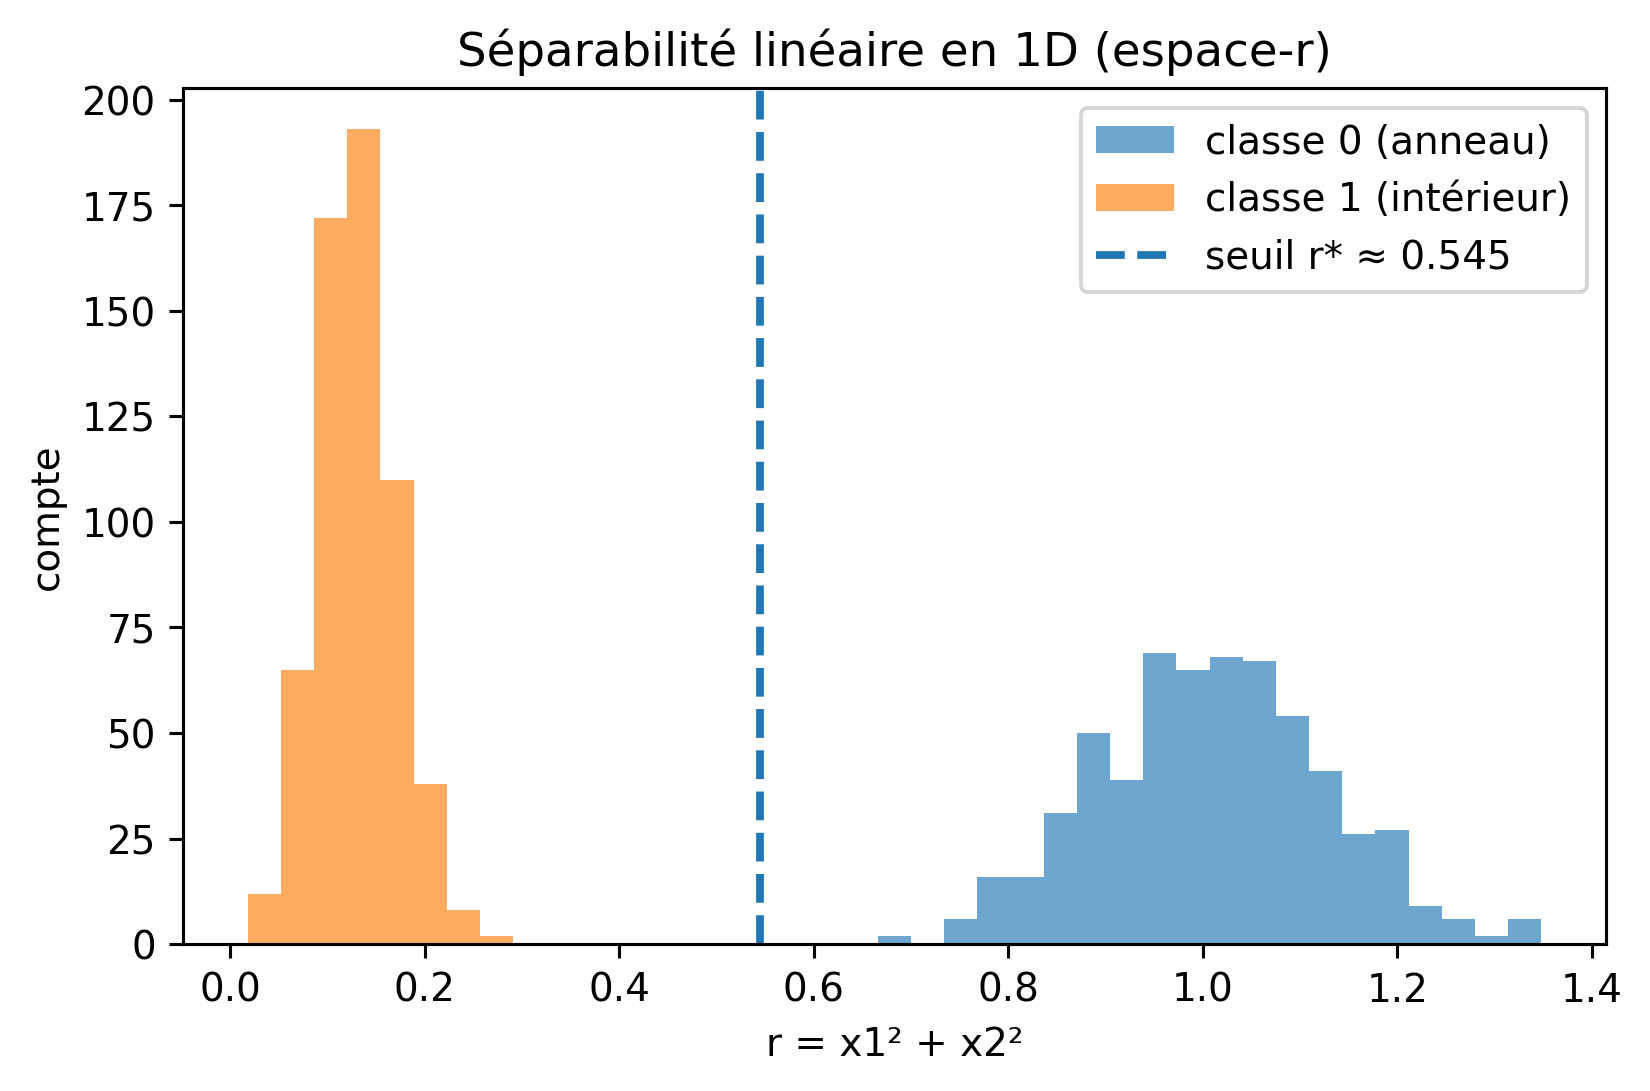
Ici, r désigne la distance au carré depuis l’origine, plutôt que le rayon lui-même. Les points du cercle intérieur ont un petit r, et ceux de l’anneau extérieur, un grand r. Élever la distance au carré conserve leur ordre : il n’est donc pas nécessaire de calculer une racine carrée.
Pour l’échantillon généré ci-dessus, les deux bandes sont séparées dans l’espace r. Un seuil r^* permet de séparer les classes :
\text{intérieur si } r < r^*, \qquad \text{extérieur si } r > r^*.
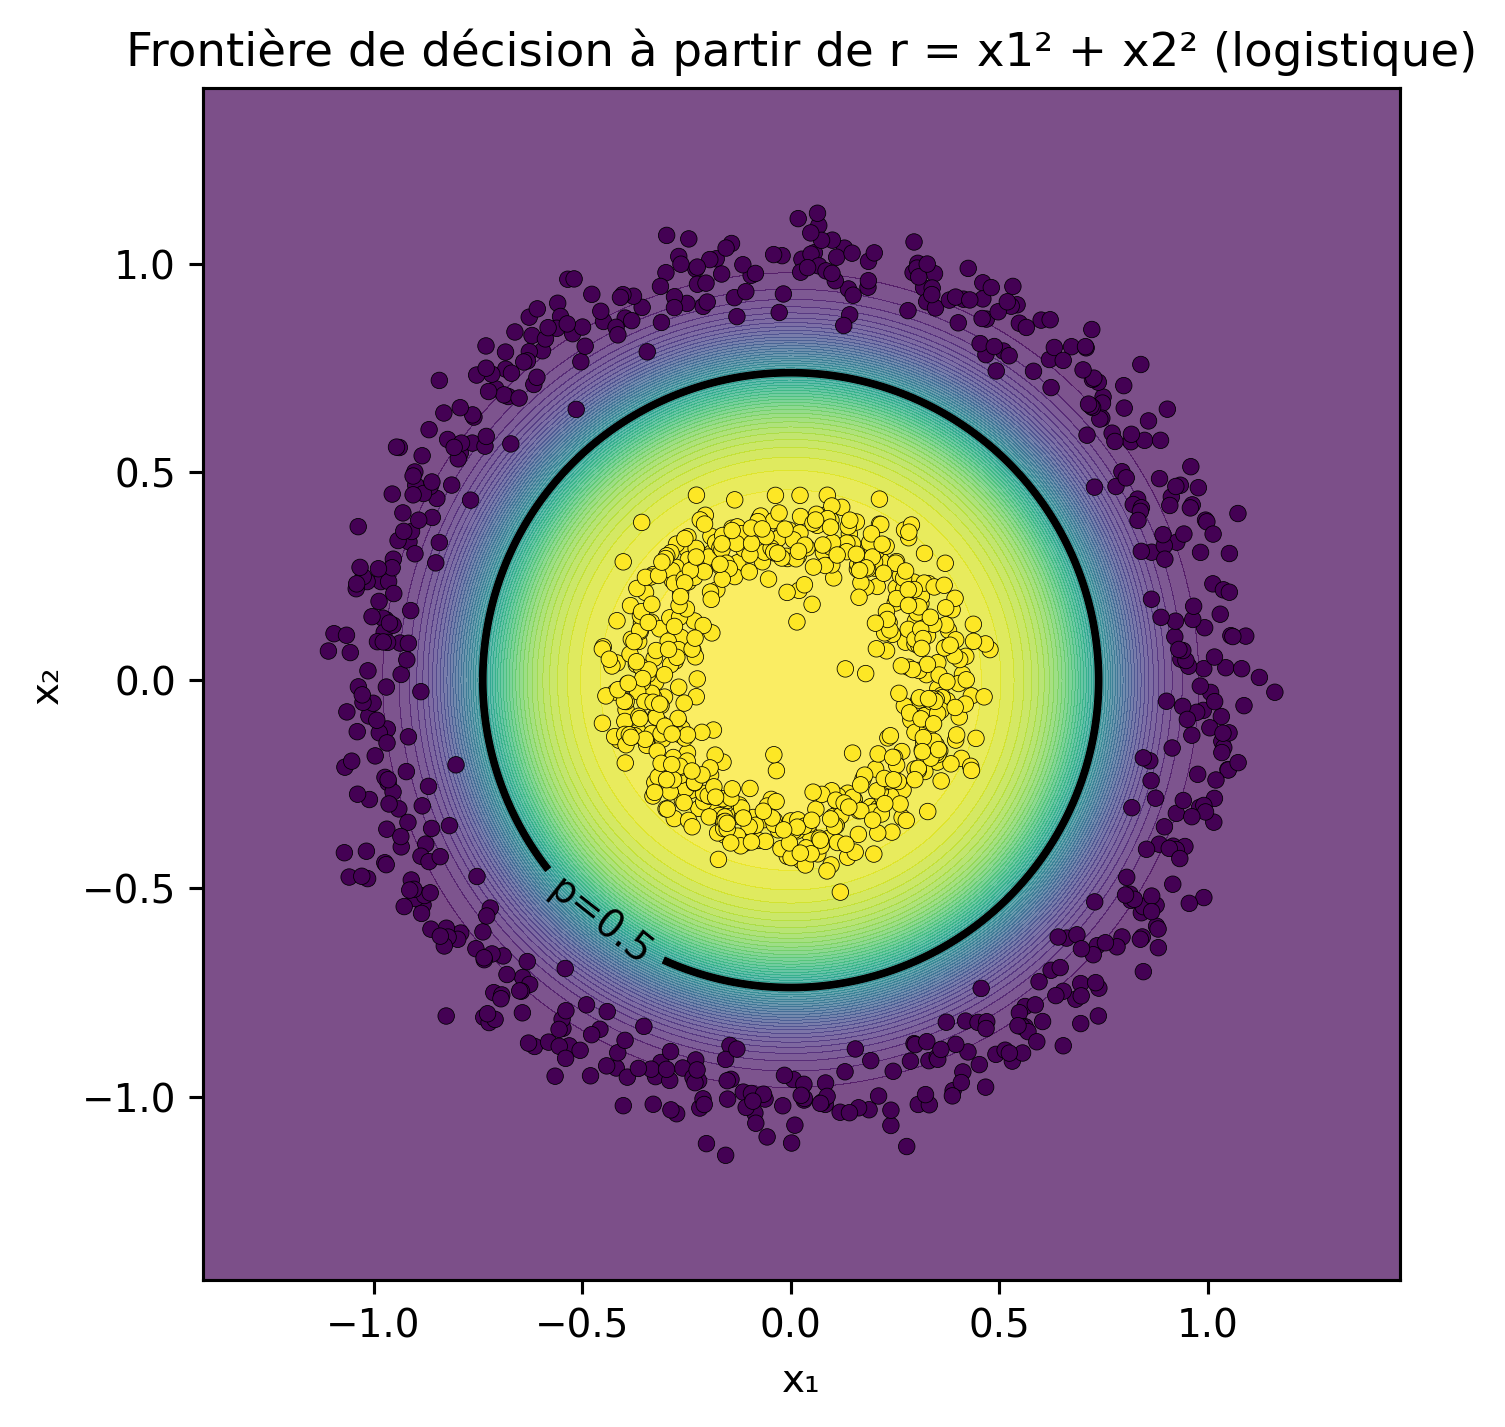
Ce même seuil correspond à un cercle dans le plan d’entrée d’origine. Avec davantage de bruit, les bandes radiales peuvent se chevaucher et une séparation parfaite peut devenir impossible.
Ajuster un modèle dans l’espace r
Tous les modèles d’un jeu de données utilisent le même partitionnement : 60 % pour l’entraînement, 20 % pour la validation et 20 % pour le test. Seuls les exemples d’entraînement servent à ajuster les paramètres. Le réseau de neurones utilise la perte de validation pour l’arrêt précoce (early stopping); les exemples de test sont réservés à la comparaison finale.
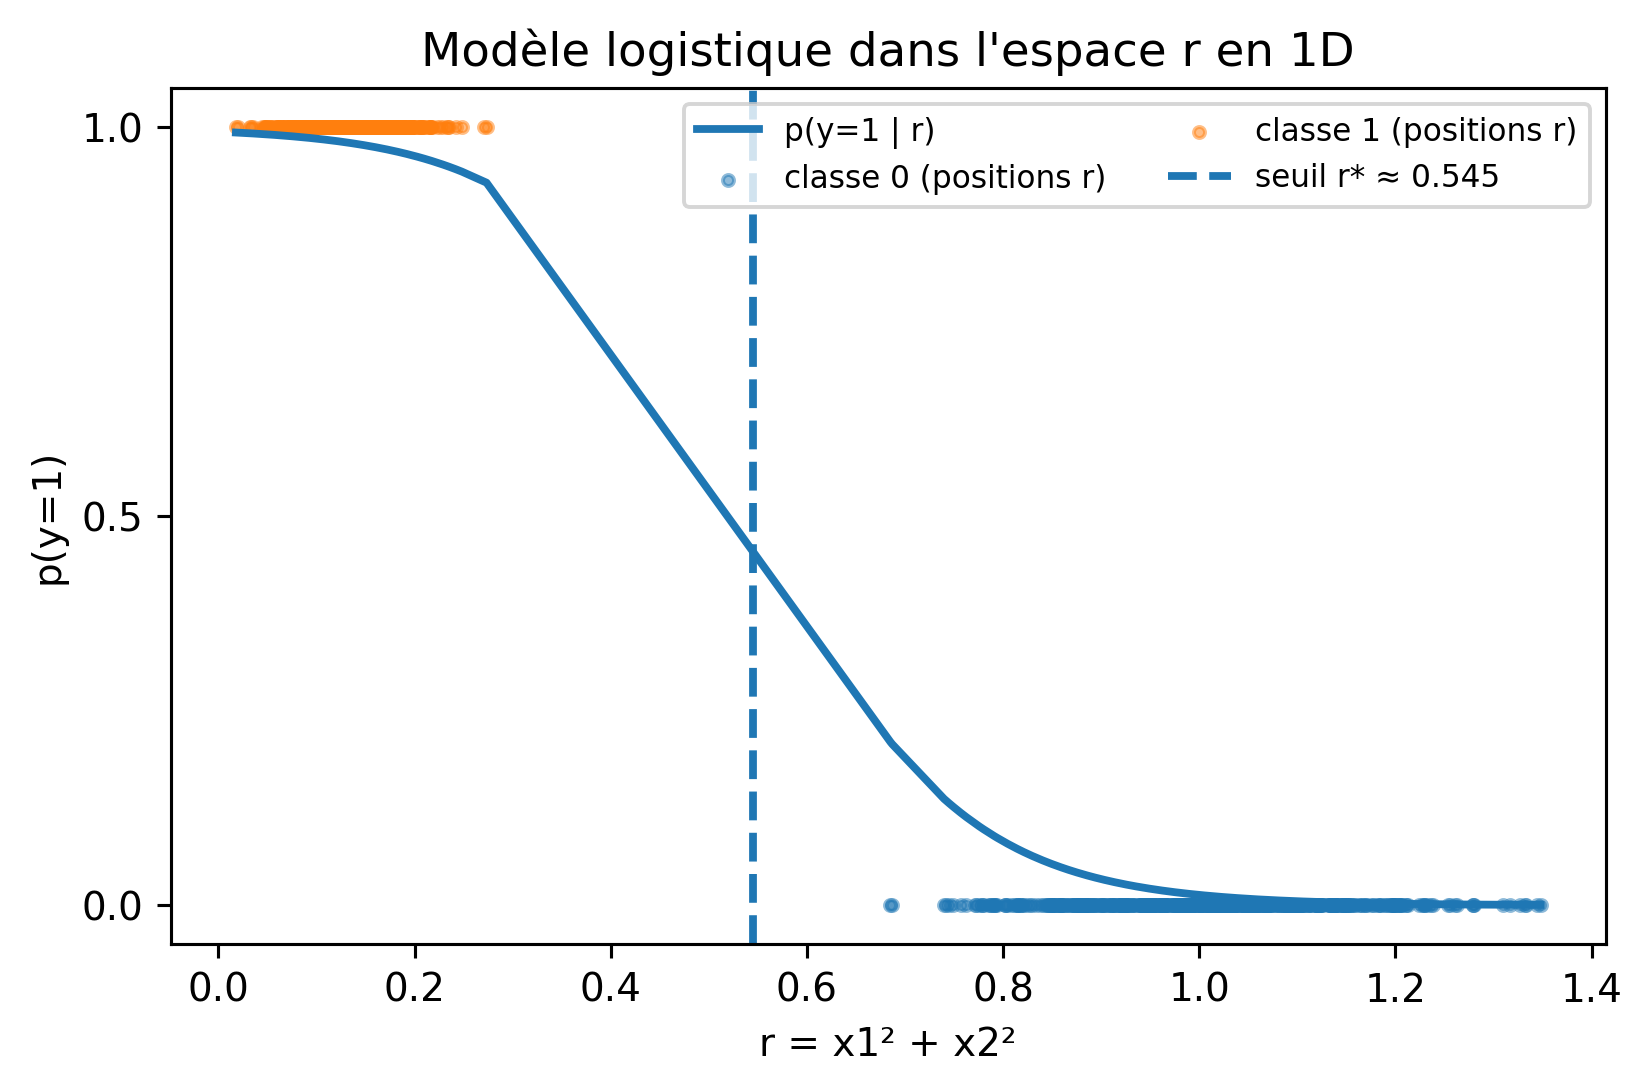
Le modèle radial estime p(y=1\mid r)=\sigma(wr+b). Sa frontière de décision vérifie wr+b=0, soit r^*=-b/w. Le poids appris est négatif parce que la classe 1 occupe les plus petits rayons.
Vue 3D
En associant à chaque point les coordonnées (x_1,x_2,r), on transforme la frontière de décision en un plan horizontal. Faites pivoter la vue interactive pour voir comment ce plan sépare les deux bandes.
La vue statique ci-dessous montre la même relation pour les lecteurs dont l’outil de consultation du cahier ou l’exportation PDF n’affiche pas les figures interactives.
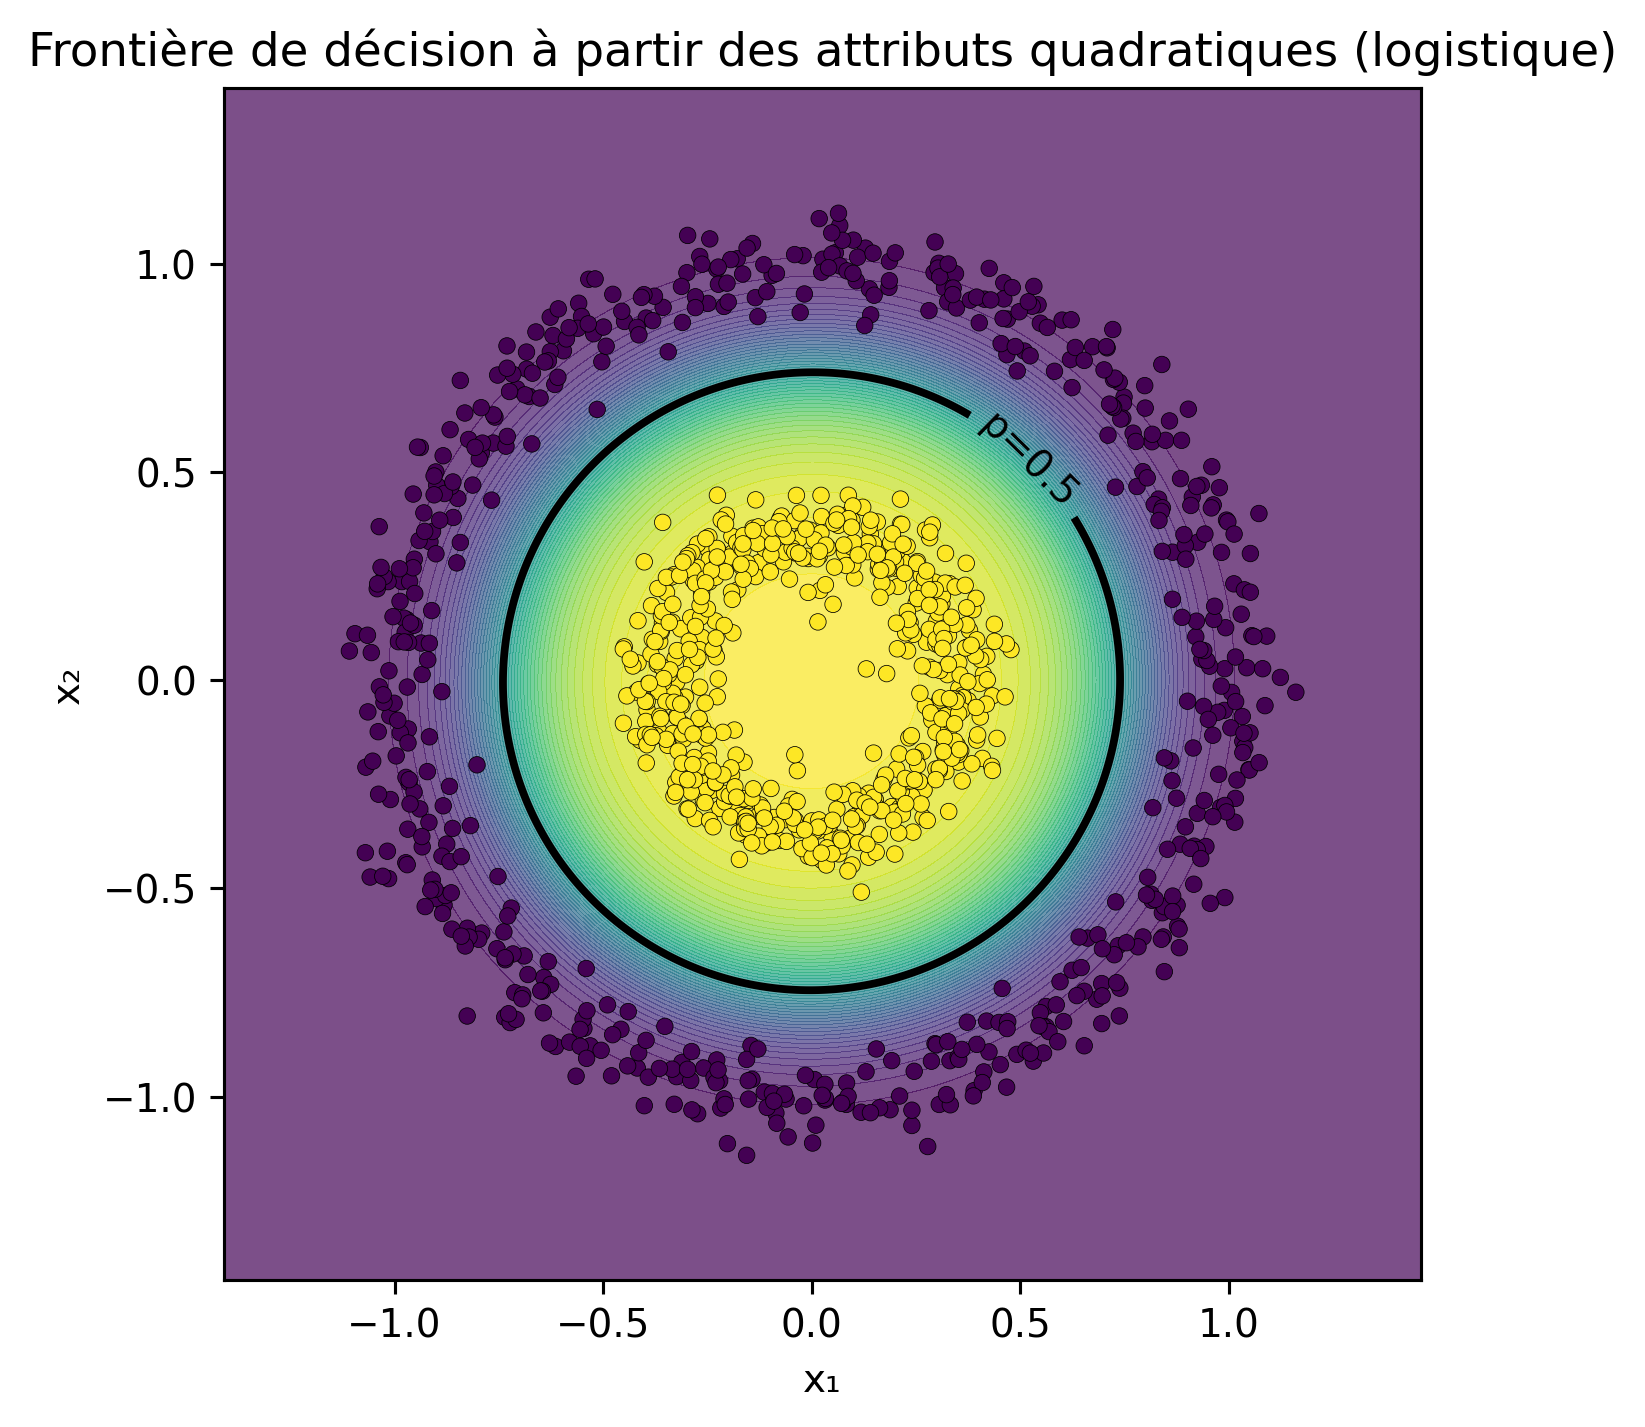
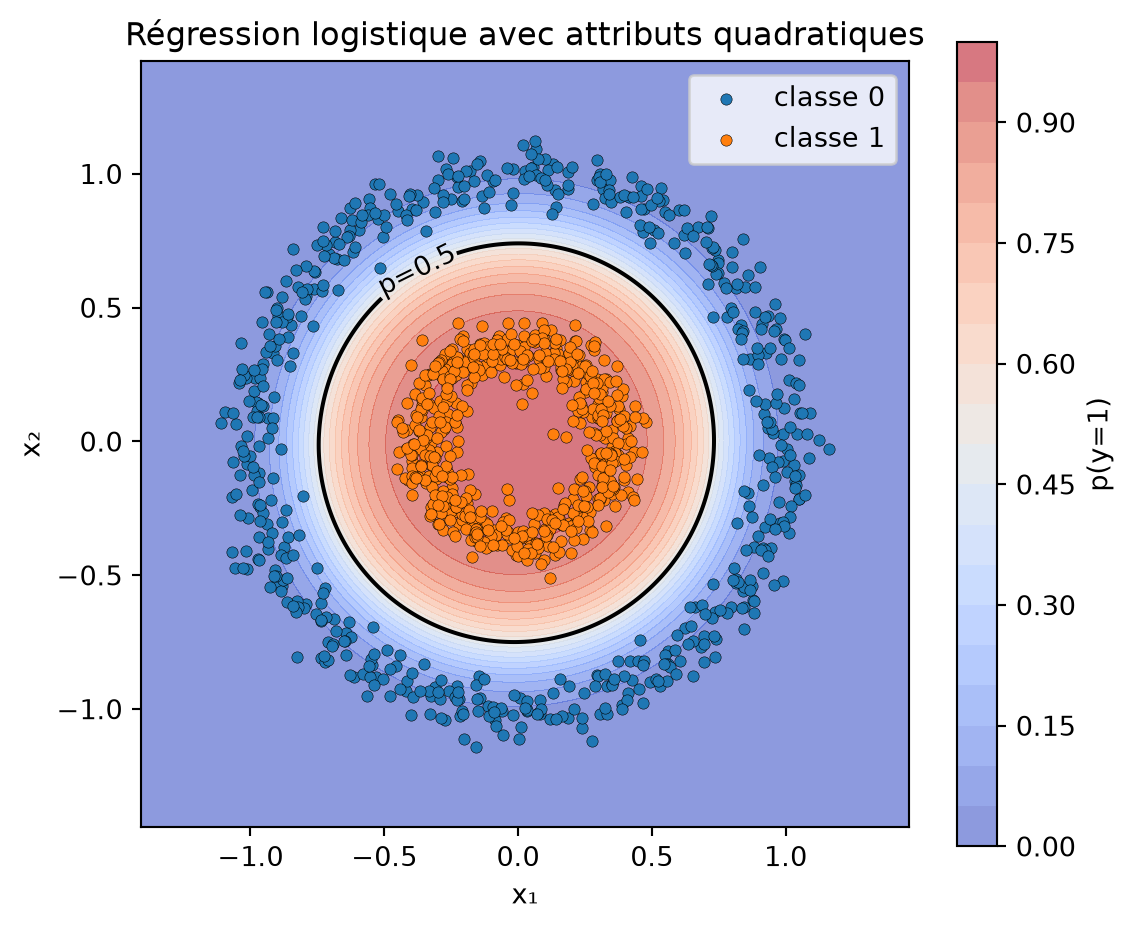
Les fonctions de tracé ci-dessous seront aussi utilisées pour le modèle quadratique et les réseaux de neurones. Les couleurs du fond montrent la probabilité estimée de la classe 1; le contour noir indique p=0.5. Les points représentent l’ensemble des données générées, tandis que l’ajustement des modèles utilise seulement la partition d’entraînement.
Le modèle radial impose un coefficient commun aux carrés des entrées, puisque wr=w(x_1^2+x_2^2). Le modèle quadratique peut pondérer les cinq attributs indépendamment. Les deux peuvent séparer ces cercles, mais leurs frontières et leurs probabilités ajustées ne sont pas nécessairement identiques. Leur régularisation par défaut agit aussi sur des paramétrisations différentes.
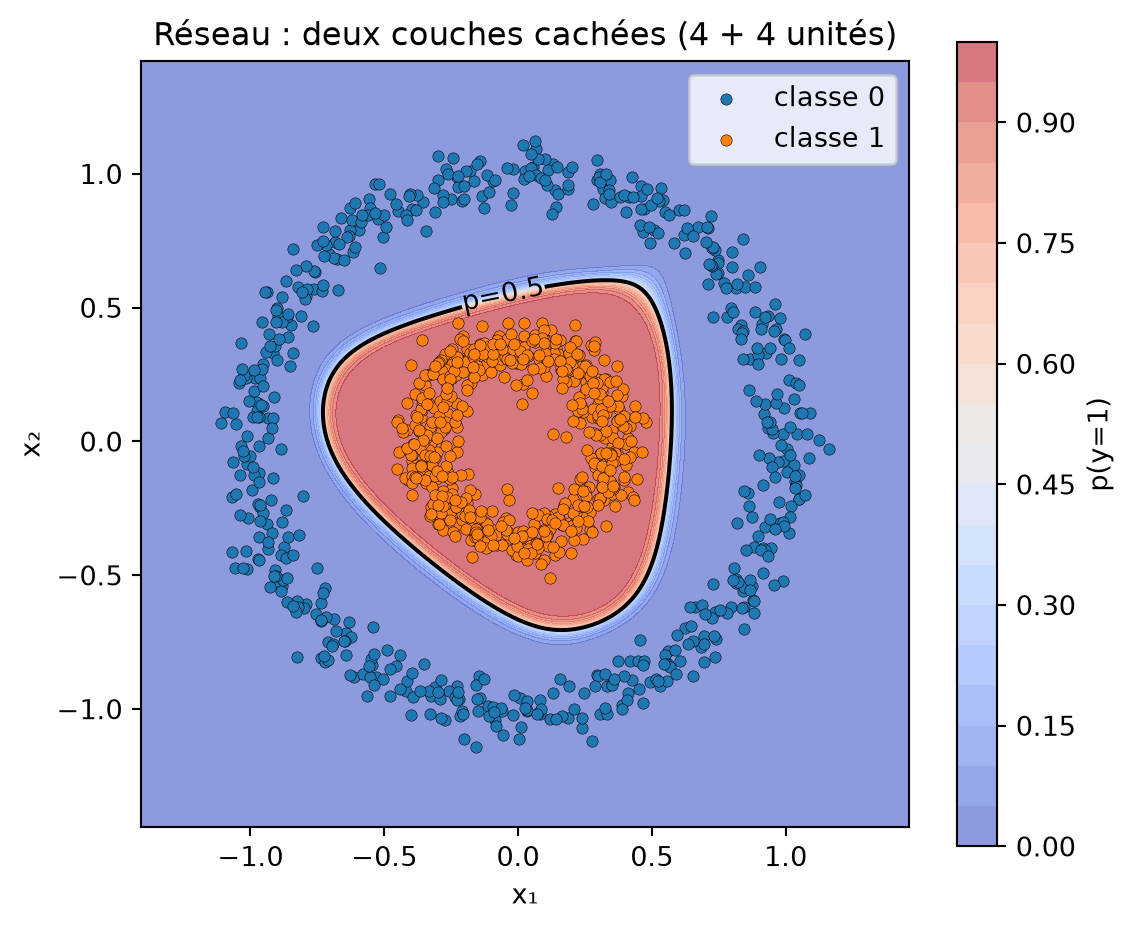
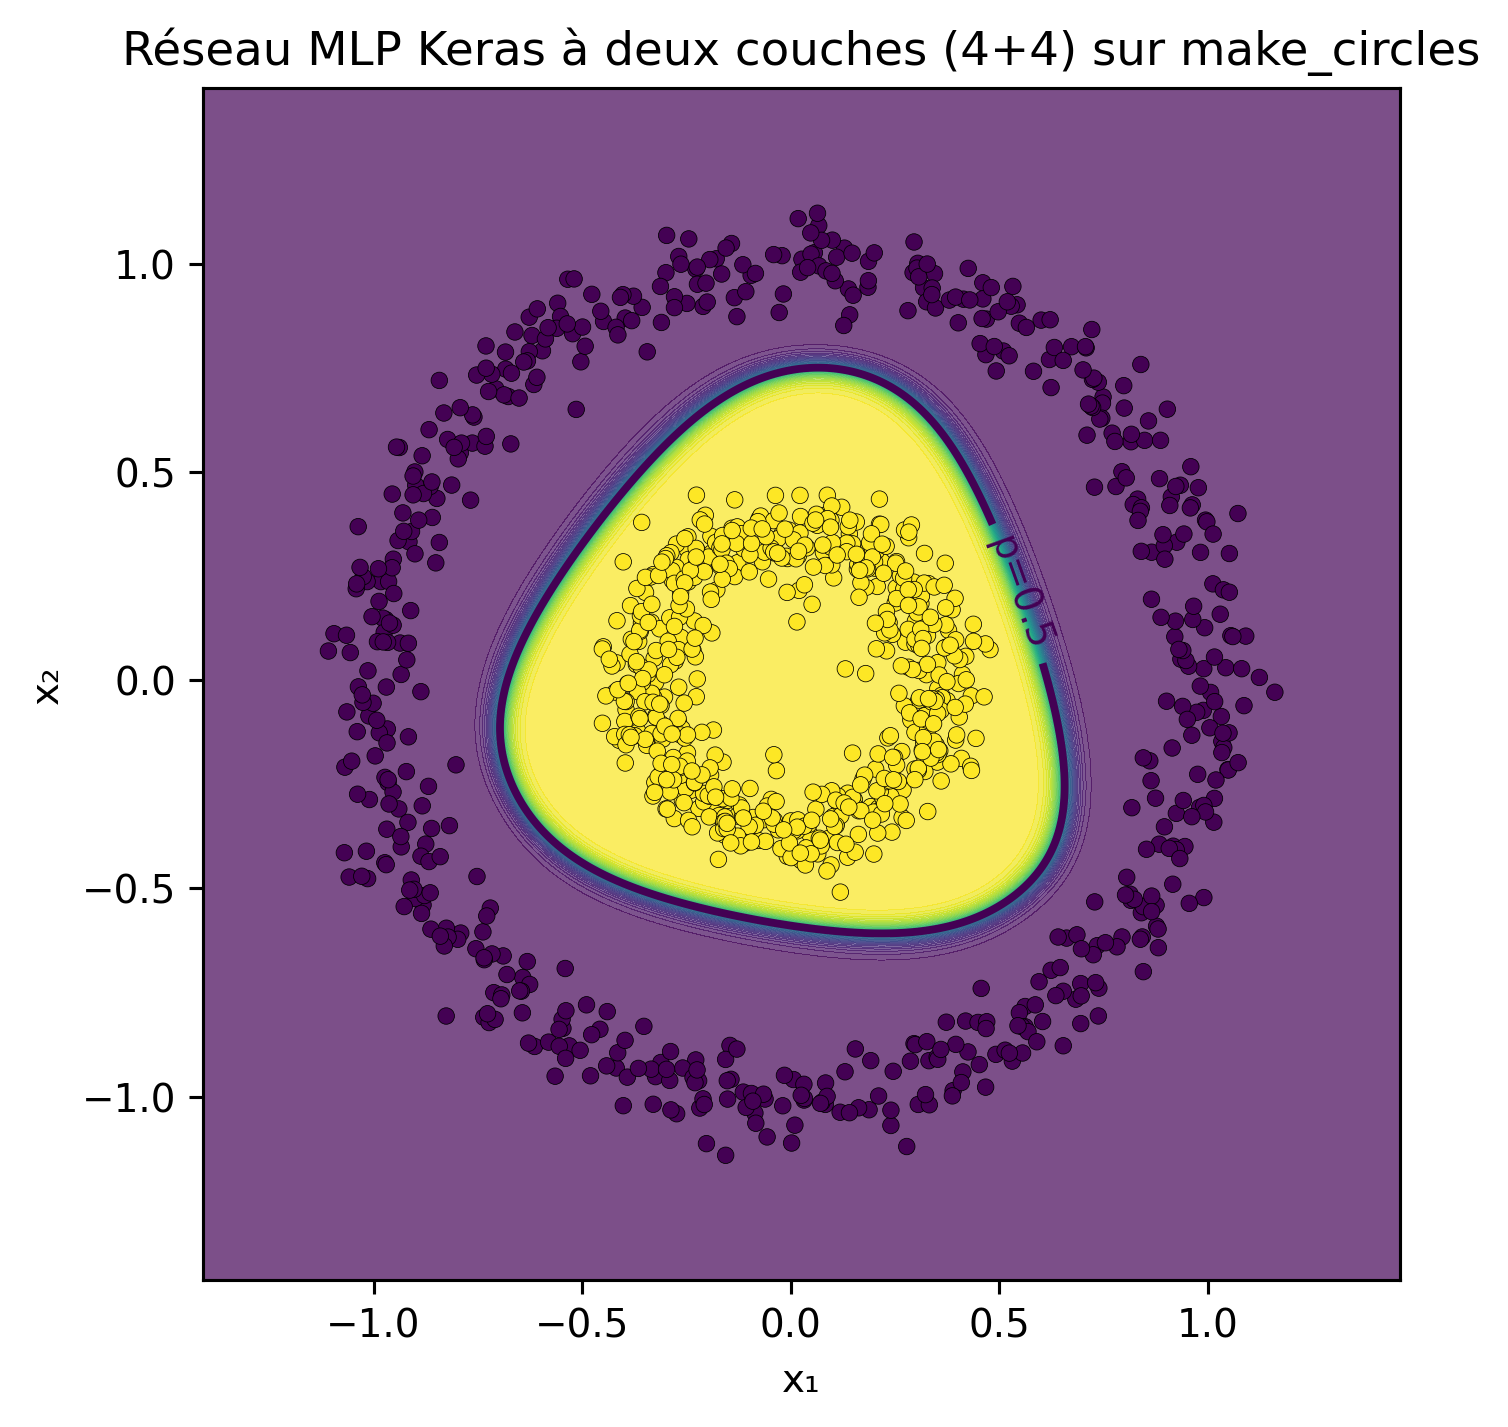
Le réseau de neurones reçoit uniquement les entrées d’origine x_1 et x_2. Il possède deux couches cachées de quatre unités chacune, suivies d’une seule sortie sigmoïde : trois couches avec des paramètres entraînables. Les couches cachées utilisent tanh, une activation non linéaire, et apprennent une représentation à partir des exemples d’entraînement.
Il s’agit d’une configuration qui fonctionne, et non d’une affirmation selon laquelle tanh s’entraîne toujours plus vite ou mieux que d’autres activations. La réussite de l’entraînement dépend des données, de l’initialisation, de l’architecture et des réglages de l’optimisation.
L’arrêt précoce surveille la perte de validation et restaure les poids de l’époque où cette perte est la plus faible. Cette époque n’a pas nécessairement la meilleure exactitude de validation. Nous évaluons donc directement le modèle restauré, plutôt que de prendre des valeurs provenant d’époques différentes dans l’historique d’entraînement. La documentation de Keras explique les paramètres de ce rappel (callback).
Évaluation finale sur l’ensemble de test des cercles
La comparaison utilise les mêmes exemples mis de côté pour tous les modèles. Elle illustre l’effet de la représentation sur ce jeu de données; une exécution réussie ne garantit pas les mêmes résultats avec d’autres données ou réglages d’entraînement.
Logistique : entrées d'origine     exactitude de test = 0.471
Logistique : attribut radial       exactitude de test = 1.000
Logistique : attributs quadratiques exactitude de test = 1.000
Réseau : entrées d'origine         exactitude de test = 1.000
Jeu de données XOR
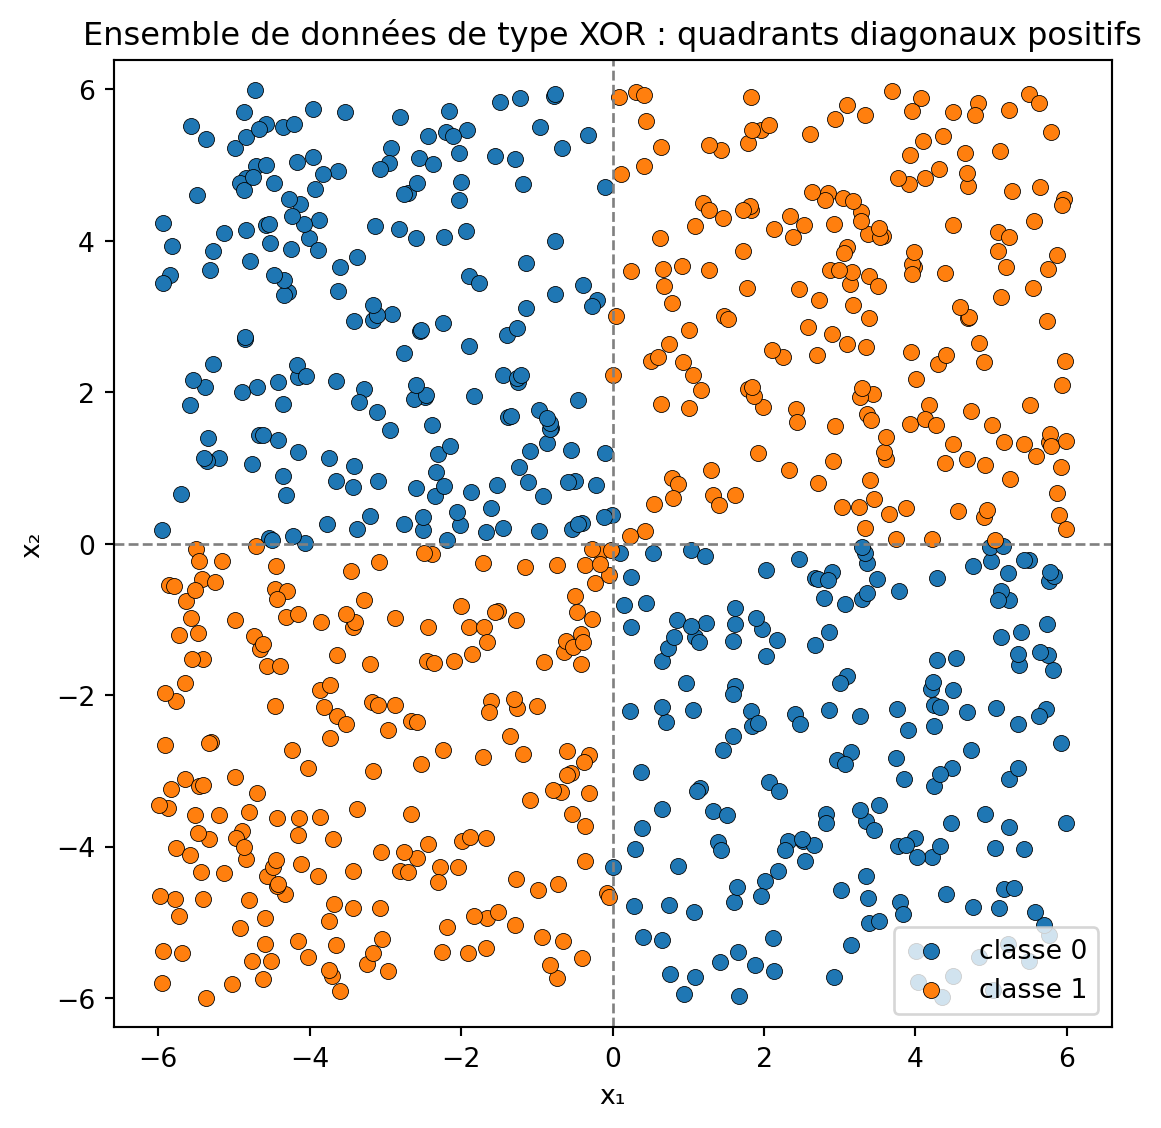
Dans la présentation 11, une couche cachée a été configurée à la main pour calculer le XOR booléen. Ici, une version continue permet d’explorer l’apprentissage d’une frontière non linéaire. Interprétez A comme (x_1>0) et B comme (x_2>0). La classe 1 correspond à A\oplus B : exactement une entrée est positive, ce qui donne les quadrants supérieur gauche et inférieur droit.
Une frontière de décision droite ne peut pas séparer les classes dans le plan d’origine. Des attributs conçus de manière appropriée et un réseau de neurones sont deux moyens de surmonter cette limite.
L’attribut radial supprime l’information sur les signes. Des points à la même distance de l’origine peuvent appartenir à l’une ou l’autre classe. L’attribut qui séparait les cercles ne peut donc pas séparer XOR. Dans cette distribution d’échantillonnage, l’étiquette est indépendante du rayon au carré; un échantillon fini peut néanmoins présenter de petites associations fortuites.
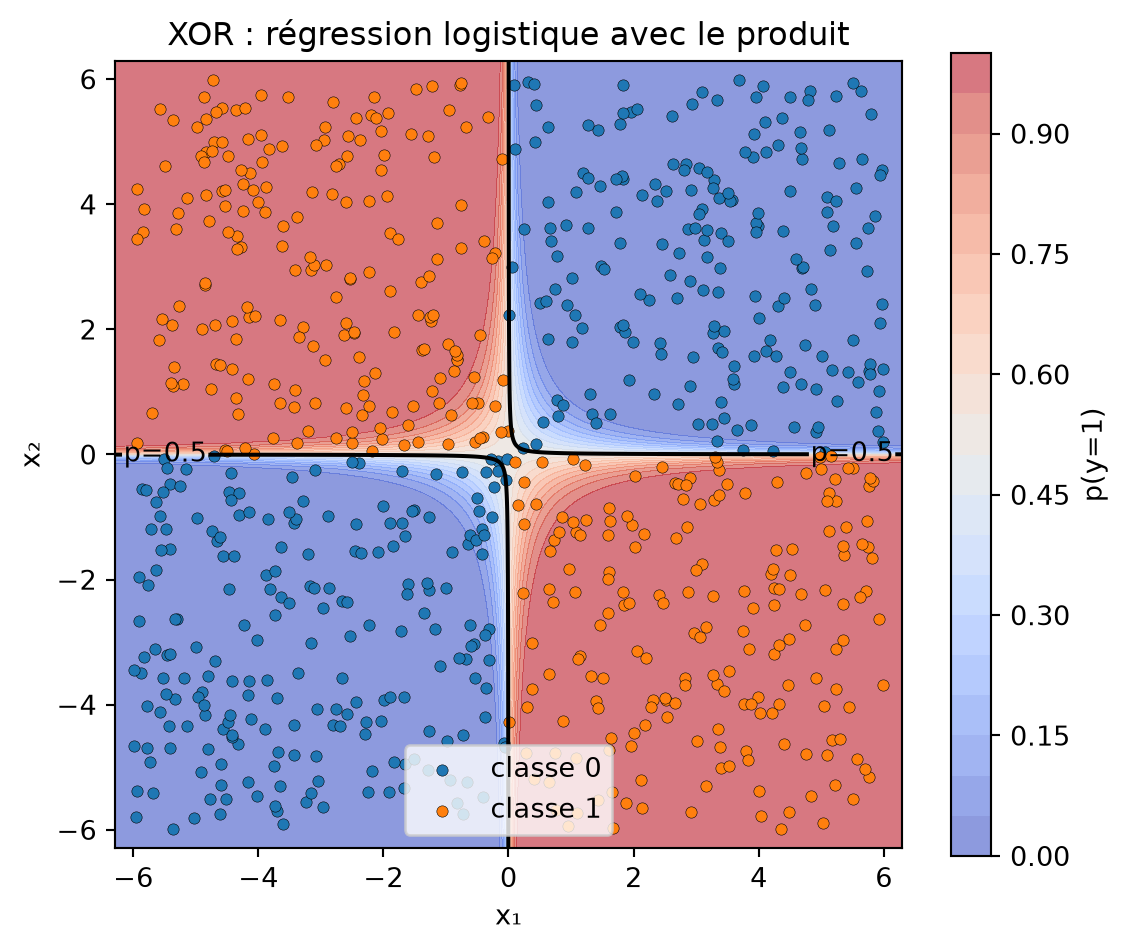
Le produit s=x_1x_2 distingue les signes opposés des signes identiques. En dehors des axes de coordonnées, la classe 1 vérifie s<0, et la classe 0, s>0. Un seuil nul sépare les classes dans cet espace d’attributs.
Le développement quadratique comprend déjà x_1x_2. Le modèle quadratique complet peut donc aussi représenter une frontière XOR, même si l’attribut radial seul ne le permet pas.
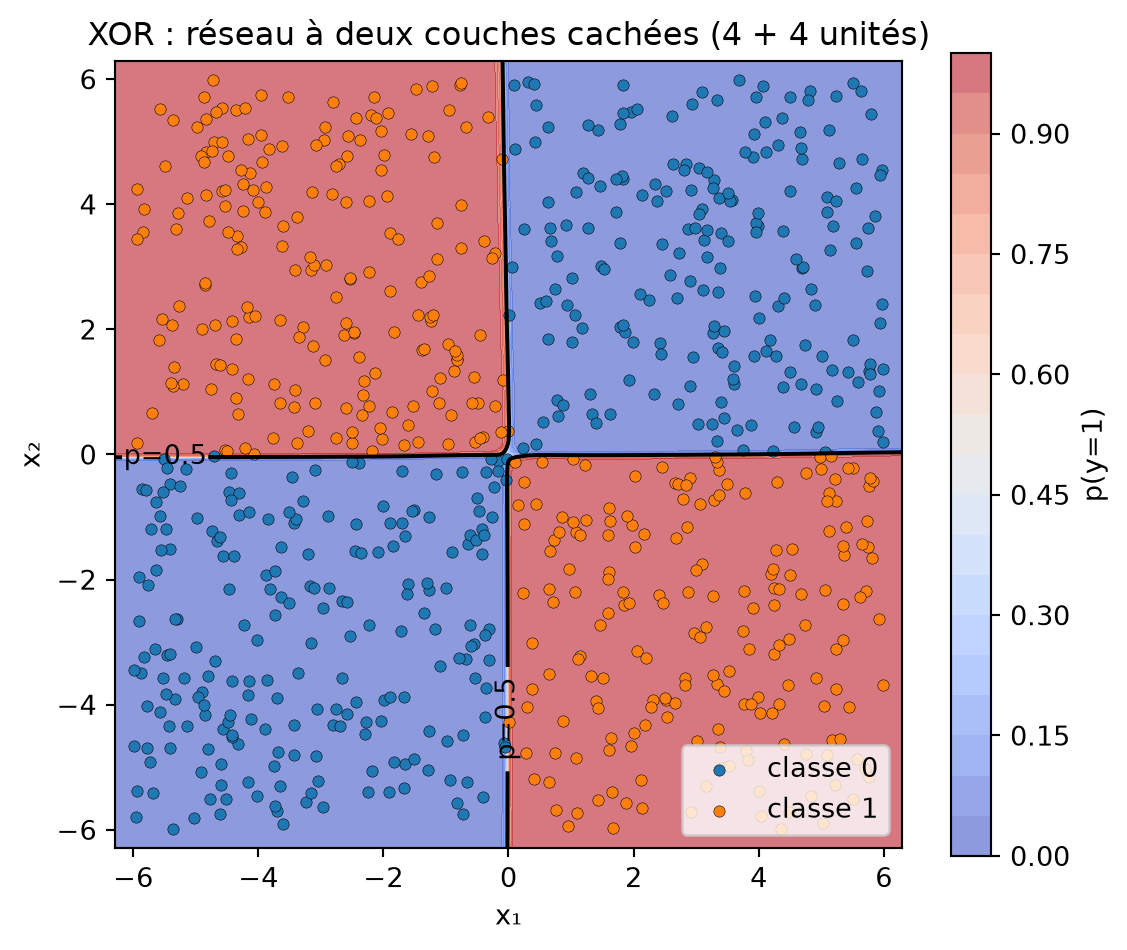
Nous entraînons un nouveau réseau de neurones avec la même architecture et les mêmes réglages que pour les cercles. Seules les entrées d’origine sont fournies : nous ne donnons ni l’attribut radial ni le produit. La fonction de tracé et la fonction de construction du modèle sont réutilisées.
Logistique : entrées d'origine     exactitude de test = 0.512
Logistique : attribut radial       exactitude de test = 0.556
Logistique : attribut produit      exactitude de test = 1.000
Logistique : attributs quadratiques exactitude de test = 0.988
Réseau : entrées d'origine         exactitude de test = 1.000
À retenir
La séparabilité linéaire dépend de la représentation. Un classificateur linéaire appliqué à des attributs non linéaires peut avoir une frontière non linéaire dans l’espace d’entrée d’origine.
Les attributs utiles dépendent de la tâche : le rayon au carré sépare ces cercles, tandis que le produit distingue les quadrants de XOR.
Les couches cachées fournissent un autre moyen d’apprendre une représentation. Elles ne garantissent ni que l’entraînement trouvera des paramètres appropriés, ni qu’un réseau surpassera un modèle doté d’attributs bien choisis.
Ces expériences illustrent la distinction de la présentation 11 entre ce qu’une architecture peut représenter et ce qu’un entraînement trouve à partir de données.